
遇见数据集

ginigen/Korean-Hallucination-Bench

收藏
Hugging Face2026-06-17 更新2026-06-21 收录
官方服务:

资源简介:

Korean Hallucination Benchmark(한국어 환각 진단 벤치마크)是一个用于评估韩语大语言模型幻觉抵抗性的四选一多项选择题基准测试。它涵盖五个专业领域:法律、专利、行政、医疗和金融,并包含10种韩语特定幻觉类型,如数值/日期错误、条款扭曲、无根据推理、汉字词/新词混淆、过度泛化、多轮上下文崩溃、敬语/非敬语反转、来源伪造、术语扭曲和事实伪造。每个问题由一个事实正确答案和三个看似合理、足以欺骗专家的幻觉错误答案组成。数据集总计10,167个问题,通过Darwin-398B-JGOS生成问题与选项,并使用Claude进行答案验证和校正以确保准确性,同时自动丢弃答案不明确或存在多个正确答案的问题。数据以JSON格式存储,包括领域、幻觉类型、问题、选项、答案索引、答案文本和解释。评估方法基于greedy decoding,测量模型在避免选择幻觉选项的情况下选择正确答案的准确率。该数据集主要用于GenizenAI的LLM X-RAY幻觉诊断模块,以诊断韩语LLM在不同领域的幻觉漏洞。许可证为Apache 2.0,由GenizenAI在NIPA的先进GPU利用支持项目下开发。

The Korean Hallucination Benchmark (한국어 환각 진단 벤치마크) is a multiple-choice benchmark with four options designed to evaluate the hallucination resistance of Korean large language models. It covers five specialized domains: legal, patent, administrative, medical, and finance, and includes 10 Korean-specific hallucination types, such as numerical/date errors, clause distortion, unfounded reasoning, hanja/neologism confusion, overgeneralization, multi-turn context collapse, honorific/casual speech reversal, source fabrication, term distortion, and fact fabrication. Each question consists of one factual correct answer and three plausible hallucination incorrect answers that are convincing enough to deceive experts. The dataset contains a total of 10,167 questions, generated using Darwin-398B-JGOS for questions and options, with answer validation and correction performed by Claude to ensure accuracy, and automatic discarding of questions with ambiguous or multiple correct answers. Data is stored in JSON format, including domain, hallucination type, question, options, answer index, answer text, and explanation. Evaluation is based on greedy decoding, measuring the models accuracy in selecting the correct answer while avoiding hallucination options. The dataset is primarily used for GenizenAIs LLM X-RAY hallucination diagnosis module to identify hallucination vulnerabilities in Korean LLMs across different domains. It is licensed under Apache 2.0 and developed by GenizenAI with support from NIPAs Advanced GPU Utilization Support Project.

提供机构:
ginigen
搜集汇总
数据集介绍
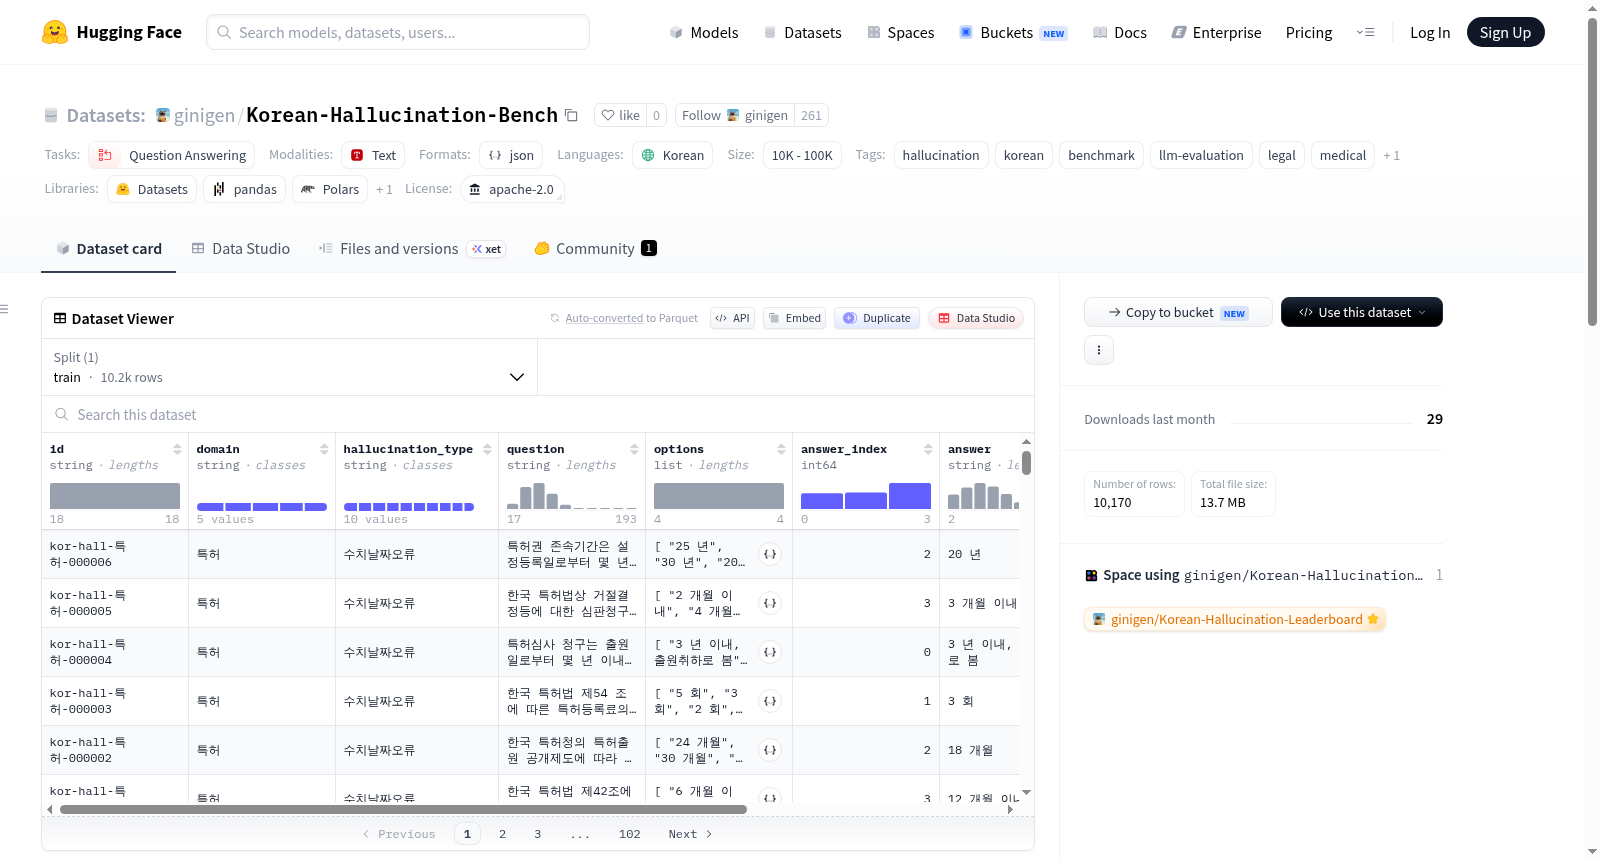
ginigen/Korean-Hallucination-Bench 数据集图片
构建方式
Korean-Hallucination-Bench是一个专为评估韩语大语言模型幻觉抵抗能力而设计的四选一基准测试集。其构建过程采用双阶段流程:首先,利用Darwin-398B-JGOS模型生成涵盖法律、专利、行政、医疗和金融五个专业领域的试题及选项;随后,经由Claude模型对每一道题目的正确答案进行严格的审核与校正,确保答案基于韩国现行法规与事实,从而消除生成模型自身可能引入的偏差。最终,仅保留答案唯一且明确的题目,构建出包含10,167道高质量试题的数据集。
特点
该数据集的核心特色在于其高度专业化的领域覆盖与精细化的幻觉类型分类。它横跨法律、专利、行政、医疗、金融五大知识密集型领域,同时精心设计了十种韩语特有的幻觉类型,如数值日期错误、条款扭曲、无依据推断、汉字词与新生词混淆、过度泛化、多轮对话上下文断裂、敬语与非敬语反转、来源捏造、术语歪曲及事实编造等。每道试题均包含一个正确答案与三个足以误导专家的逼真错误选项,从而对模型的语言理解、事实判断与抗干扰能力进行严苛评测。
使用方法
使用该数据集时,研究者需将题目中的问题与四个选项依次输入待评估的韩语大语言模型,并采用贪婪解码策略,记录模型选择的答案。通过统计模型在全部题目中正确选择正确答案的比例,即可获得该模型在特定领域及整体上的幻觉抵抗准确率。这一评估流程不仅揭示了模型在专业领域的弱点,还通过幻觉类型标签,精准定位模型在语言认知层面的具体缺陷,为模型优化提供明确方向。
背景与挑战
背景概述
Korean-Hallucination-Bench数据集由韩国人工智能企业지니젠AI(Genizen AI)于NIPA(韩国信息通信技术振兴中心)尖端GPU利用支援项目资助下创建,旨在系统评估韩语大语言模型(LLM)在专业领域中的幻觉抵抗能力。该数据集聚焦法律、专利、行政、医疗与金融五个高专业性领域,涵盖10种韩语特有的幻觉类型,包括数值日期错误、法条扭曲、无根据推理、汉字词与新造词混淆、过度泛化、多轮对话上下文崩溃、敬语与半语倒置、来源捏造、术语歪曲及事实捏造。其核心研究问题在于构建一个能够有效区分韩语LLM生成内容的真实性与误导性的基准,通过提供极具迷惑性的错误选项——即便是领域专家亦可能被诱导——从而精准评测模型的幻觉脆弱性。该数据集的发布对于提升韩语LLM在关键应用场景的可靠性具有重要推动作用,为后续韩语NLP领域的幻觉检测、模型鲁棒性增强及相关标准化评估奠定了坚实基础。
当前挑战
Korean-Hallucination-Bench所解决的领域挑战在于韩语LLM在专业领域高精度任务中频发的幻觉现象,特别是在法律、医疗等对事实准确性要求严苛的场景下,模型可能生成看似合理实则完全错误的信息,造成严重的实务风险。构建过程中的挑战首当其冲的是高质量对抗性选项的生成与筛选,需确保错误选项在专家眼中具备高度迷惑性而非明显荒谬;为此团队采用Darwin-398B-JGOS模型生成初版问题与选项,再经Anthropic的Claude模型进行严格的正答校验与修正,并自动剔除答案模棱两可或存在多个正确答案的题目,以消除生成模型的固有偏见。此外,覆盖五个专业领域及十种幻觉类型需要平衡数据分布的均匀性与代表性,构建过程需依赖领域专家知识对正答依据与错误选项理由进行详实标注,确保每个题项均附带可解释的推理过程,这一过程对人力与计算资源提出了极高要求。
常用场景
经典使用场景
Korean-Hallucination-Bench作为韩国语大语言模型幻觉抵抗能力的专业评估基准,其最经典的使用场景是在法律、专利、行政、医疗和金融五大专业领域内,通过四选一的选择题形式,系统性地评估模型在面对10种精心设计的幻觉类型时的鲁棒性。每个问题包含一个事实正确答案和三个由领域专家审核的、极具迷惑性的幻觉干扰项,从而精确衡量模型在专业语境下辨识事实与虚构信息的能力。这一基准为韩国语LLM的幻觉检测提供了标准化、多维度的测试框架,是研究人员和开发者验证模型可靠性的核心工具。
实际应用
在实际应用中,Korean-Hallucination-Bench作为GenieGen AI公司LLM X-RAY产品的幻觉诊断模块评估集,直接服务于企业级韩国语大语言模型的质量保障流程。开发人员利用该基准对模型进行分领域、分类型的压力测试,识别模型在金融咨询、法律条文解析、医疗诊断辅助等场景中的具体幻觉脆弱点。这些评估结果指导模型微调策略的制定,优化知识检索增强架构,并帮助建立内容生成的事实核查机制。在公共事务的行政文书处理、专利检索系统以及金融合规咨询等高风险应用中,该基准确保LLM的响应具备专业级别的可信度。
衍生相关工作
Korean-Hallucination-Bench的发布催生了一系列相关工作,包括针对韩国语大语言模型幻觉缓解的增强训练方法研究,如在微调过程中引入对抗性幻觉样本以提升模型辨识能力。研究者基于该基准开发了多层次幻觉检测框架,结合事实知识库和逻辑验证机制来过滤生成内容中的虚假信息。此外,该数据集启发了针对特定领域(如医疗诊断和法律咨询)的幻觉防护系统设计,以及跨语言幻觉抵抗对比分析。其分类体系也被用于构建更细粒度的幻觉标注工具,为韩国语LLM的安全性评估和可解释性研究提供了结构化参考标准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

