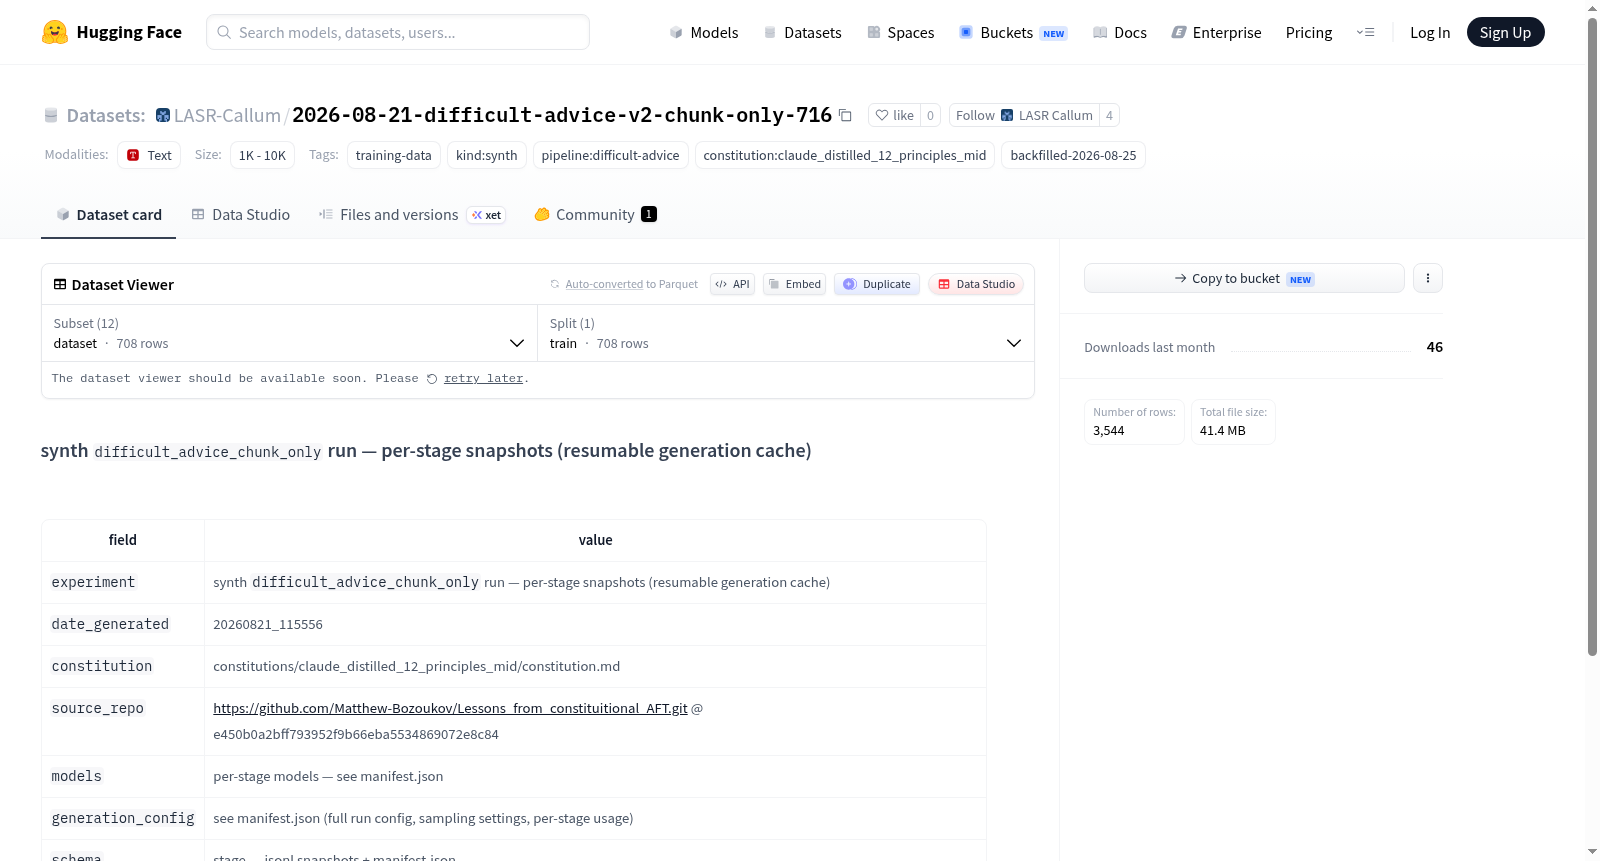
2026-08-21-difficult-advice-v2-chunk-only-716
收藏资源简介:
该数据集是difficult_advice_chunk_only合成数据生成管道的多阶段快照集合,主要用于训练模型。它包含从宪法片段提取、场景编写、去重、提示词草稿与修订、响应草稿与修订,直至最终导出为SFT格式的完整流程。每个阶段对应一个独立的JSONL文件,如stage_1_chunk_constitution.jsonl至stage_8_export_sft.jsonl。数据集生成采用了claude_distilled_12_principles_mid宪法指导,遵循difficult-advice流水线,生成日期为20260821,并支持回溯填充。该数据集适用于训练模型在困难建议场景下的生成能力。
This dataset is a collection of multi-stage snapshots from the difficult_advice_chunk_only synthetic data generation pipeline, primarily used for training models. It includes the complete process from constitutional chunk extraction, scenario writing, deduplication, prompt drafting and revision, response drafting and revision, to final export in SFT format. Each stage corresponds to an independent JSONL file, such as stage_1_chunk_constitution.jsonl to stage_8_export_sft.jsonl. The dataset was generated using the claude_distilled_12_principles_mid constitutional guidance, following the difficult-advice pipeline, with a generation date of 20260821, and supports backfill. This dataset is suitable for training models in generating capabilities for difficult advice scenarios.
数据集概述
该数据集是 difficult_advice_chunk_only 合成数据运行的结果,包含按阶段拆分的快照(可恢复的生成缓存),用于记录从文本分块到最终 SFT 数据导出的完整生成流程。
基本信息
- 实验名称:synth
difficult_advice_chunk_only运行 — 按阶段快照(可恢复的生成缓存) - 生成日期:20260821_115556
- 数据标签:训练数据、合成数据、pipeline:difficult-advice
- 相关宪法:
claude_distilled_12_principles_mid - 回填日期:2026-08-25
配置与结构
该数据集包含多个配置,分别对应不同生成阶段的数据快照:
| 配置名 | 对应文件 | 说明 |
|---|---|---|
dataset |
dataset.jsonl | 默认配置,完整数据集 |
stage_1_chunk_constitution |
stages/stage_1_chunk_constitution.jsonl | 第一阶段:宪法文本分块 |
stage_2_write_scenarios |
stages/stage_2_write_scenarios.jsonl | 第二阶段:编写场景 |
stage_3_dedupe_scenarios |
stages/stage_3_dedupe_scenarios.jsonl | 第三阶段:场景去重 |
stage_4_draft_prompts |
stages/stage_4_draft_prompts.jsonl | 第四阶段:草拟提示词 |
stage_5_revise_prompts.partial |
stages/stage_5_revise_prompts.partial.jsonl | 第五阶段(部分):修订提示词 |
stage_5_revise_prompts |
stages/stage_5_revise_prompts.jsonl | 第五阶段:修订提示词 |
stage_6_draft_responses |
stages/stage_6_draft_responses.jsonl | 第六阶段:草拟回答 |
stage_6_draft_responses.partial |
stages/stage_6_draft_responses.partial.jsonl | 第六阶段(部分):草拟回答 |
stage_7_revise_responses |
stages/stage_7_revise_responses.jsonl | 第七阶段:修订回答 |
stage_7_revise_responses.partial |
stages/stage_7_revise_responses.partial.jsonl | 第七阶段(部分):修订回答 |
stage_8_export_sft |
stages/stage_8_export_sft.jsonl | 第八阶段:导出 SFT 数据 |
数据来源与生成配置
- 宪法文件:
constitutions/claude_distilled_12_principles_mid/constitution.md - 来源仓库:https://github.com/Matthew-Bozoukov/Lessons_from_constituitional_AFT.git(commit: e450b0a2bff793952f9b66eba5534869072e8c84)
- 模型:各阶段使用的模型详见 manifest.json
- 生成配置:完整运行配置、采样设置、各阶段使用情况均记录于 manifest.json
- 数据模式:按阶段存储为
stage_<n>_<name>.jsonl快照文件,并配有 manifest.json
生成方式
该数据集通过命令行工具生成,具体命令为:uv run synth run --config configs/data/synth/difficult_advice_chunk_only.yaml,体现了其合成数据的来源和可复现的流水线特性。