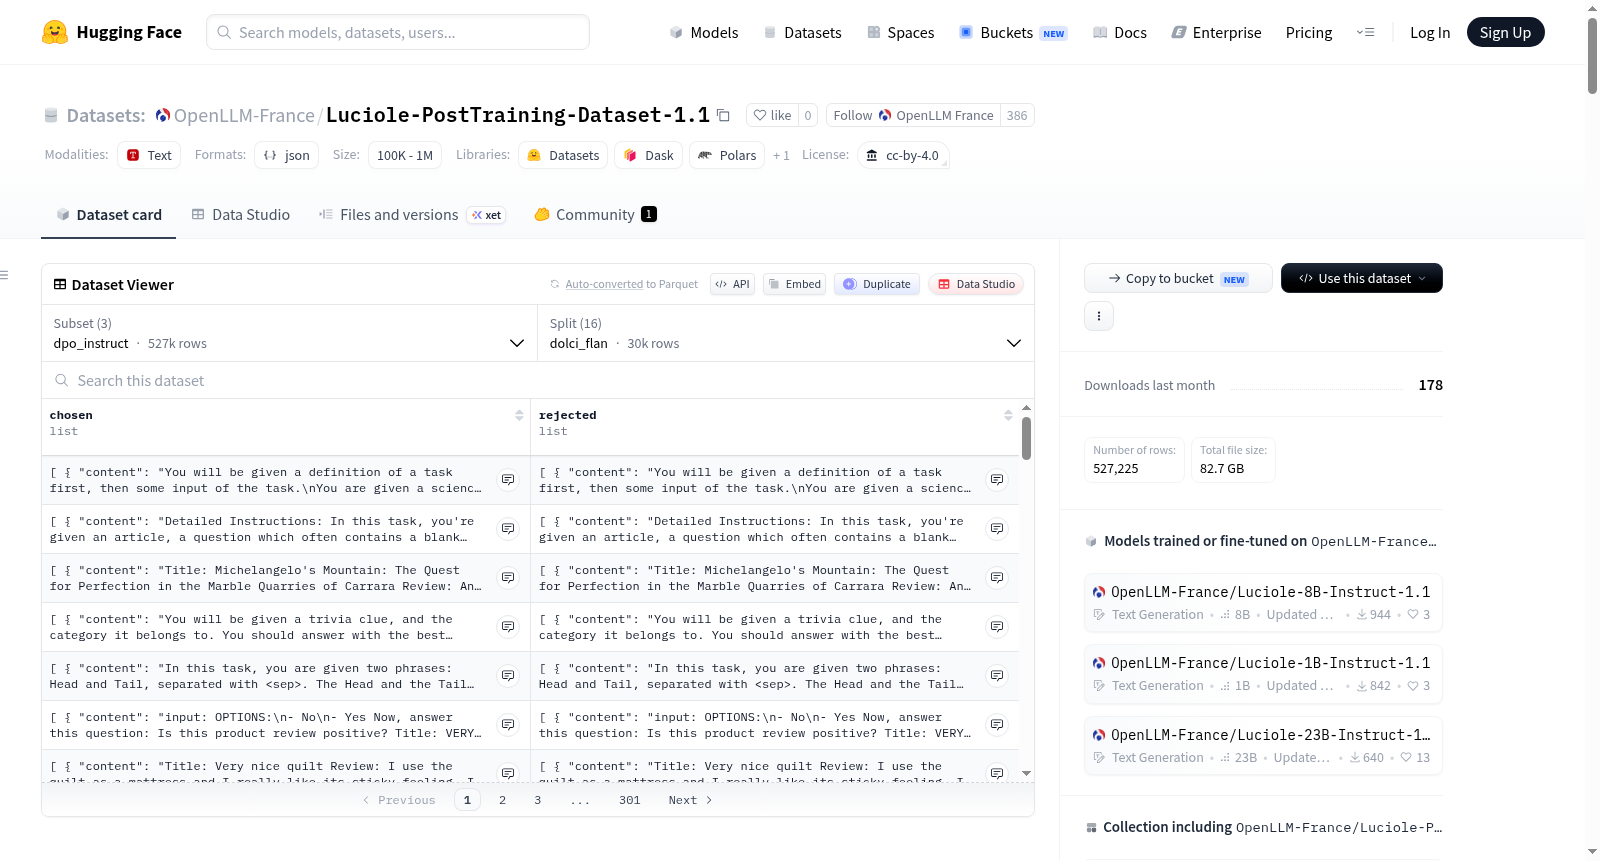
Luciole-PostTraining-Dataset-1.1
收藏资源简介:
Luciole-PostTraining-Dataset-1.1 是一个精心策划的开源指令式文本数据集,专为语言模型的后训练阶段设计,旨在促进符合开源要求和欧洲人工智能开发及知识产权法律的大型语言模型训练。数据集包含混合的合成与非合成指令数据,主要用于监督微调(SFT)以及为偏好对齐(例如DPO)设计的响应对。数据以英语为主,包含少量多语言内容,并计划在未来版本中增加多语言(尤其是法语)数据的比例。数据集由四个主要子集构成:sft_instruct(不含思维痕迹的指令数据)、sft_thinking(包含思维痕迹的指令数据)、dpo_instruct(不含思维痕迹的接受与拒绝响应对)以及即将推出的dpo_thinking(包含思维痕迹的接受与拒绝响应对)。每个子集进一步细分为多个具体的数据源(或称为“拆分”),例如来自dolci_flan、nemotron_code、nemotron_instruction_following_chat_v1、pleias_rag、smolrewrite等来源的数据。数据规模庞大,例如sft_instruct子集中的nemotron_instruction_following_chat_v1拆分包含218,343个样本,sft_thinking子集中的nemotron_posttrain_v3_math拆分包含1,251,769个样本。在数据生成方面,DPO对齐对是使用Qwen3-32B和Qwen3-0.6B模型通过delta学习方法合成生成的,其中Qwen3-32B的响应被标记为“接受”的响应。安全对齐数据则混合使用了Qwen3-14B、Ministral-3-14B-Instruct以及一个Luciole-8B-Instruct的中间检查点模型生成,并且每个响应对都经过Ministral-14B-Reasoning和Qwen3-14B双重模型的判断,仅在两模型标注一致时才被纳入数据集。数据格式遵循标准结构:SFT子集中的每个样本包含一个messages字段,该字段是一个列表,其中每个元素包含content(字符串)和role(字符串)键,遵循HuggingFace聊天格式。DPO子集中的每个样本则包含chosen和rejected两个字段,每个字段同样是上述格式的对话列表,其内容除最后的assistant回合外完全相同。该数据集由OpenLLM France联盟在法国BPI France资助的France 2030项目下创建,数据在GENCI的Jean Zay超级计算机上处理存储。数据集采用CC BY-SA 4.0许可证发布。需要注意的是,由于数据主要使用第三方开源权重模型生成,可能引入不必要的语言和文化偏见;安全对齐数据因其教学性质可能包含有害内容;且当前版本未区分同一语言的不同变体(如美式英语和英式英语)。
Luciole-PostTraining-Dataset-1.1 is a meticulously curated open-source instructional text dataset designed for the post-training phase of language models. It aims to facilitate the training of large language models that comply with open-source requirements and European AI development and intellectual property laws. The dataset contains a mix of synthetic and non-synthetic instructional data, primarily used for supervised fine-tuning (SFT) and response pairs designed for preference alignment (e.g., DPO). The data is predominantly in English, with a small amount of multilingual content, and plans to increase the proportion of multilingual data (especially French) in future versions. The dataset consists of four main subsets: sft_instruct (instructional data without thinking traces), sft_thinking (instructional data with thinking traces), dpo_instruct (accepted and rejected response pairs without thinking traces), and the upcoming dpo_thinking (accepted and rejected response pairs with thinking traces). Each subset is further divided into multiple specific data sources (or splits), such as data from dolci_flan, nemotron_code, nemotron_instruction_following_chat_v1, pleias_rag, smolrewrite, etc. The dataset is large in scale; for example, the nemotron_instruction_following_chat_v1 split in the sft_instruct subset contains 218,343 samples, and the nemotron_posttrain_v3_math split in the sft_thinking subset contains 1,251,769 samples. In terms of data generation, DPO alignment pairs are synthetically generated using the Qwen3-32B and Qwen3-0.6B models via delta learning methods, with responses from Qwen3-32B labeled as accepted responses. Safety alignment data is generated using a mix of Qwen3-14B, Ministral-3-14B-Instruct, and an intermediate checkpoint of the Luciole-8B-Instruct model, and each response pair is judged by both Ministral-14B-Reasoning and Qwen3-14B models, only being included in the dataset if both models agree. The data format follows a standard structure: each sample in the SFT subsets contains a messages field, which is a list where each element has content (string) and role (string) keys, adhering to the HuggingFace chat format. Each sample in the DPO subsets contains chosen and rejected fields, each being a dialogue list in the same format, with identical content except for the final assistant turn. The dataset was created by the OpenLLM France consortium under the France 2030 project funded by BPI France, with data processed and stored on the GENCI Jean Zay supercomputer. It is released under the CC BY-SA 4.0 license. Note that since the data is primarily generated using third-party open-source weight models, it may introduce unnecessary linguistic and cultural biases; safety alignment data may contain harmful content due to its instructional nature; and the current version does not distinguish between variants of the same language (e.g., American and British English).
数据集概述
Luciole-PostTraining-Dataset-1.1 是一个专用于语言模型后训练的指令式文本数据集,涵盖了监督微调(SFT)和偏好对齐(如DPO)所需的数据。
基本信息
- 许可证:CC BY-SA 4.0
- 创建者:OpenLLM France 项目联盟,由 BPI France 资助,作为 France 2030 计划的一部分。
- 数据存储与处理:在 GENCI 的 Jean Zay 超算上完成,由 IDRIS 管理。
- 代码仓库:Luciole-Training (https://github.com/OpenLLM-France/Luciole-Training/tree/main/data)
数据特点与用途
- 内容:混合了合成与非合成的指令数据,以及用于偏好对齐的响应配对。
- 语言:以英语为主,包含少量多语言数据,未来版本将增加多语言(特别是法语)数据。
- 对齐对生成:除安全对齐数据外,均使用 Qwen3-32B 和 Qwen3-0.6B 以 delta 学习方法合成,前者作为接受回答。安全数据使用 Qwen3-14B、Ministral-3-14B-Instruct 和 Luciole-8B-Instruct(SFT后中间检查点)生成,并由 Ministral-14B-Reasoning 和 Qwen3-14B 共同判定标签,仅当两者一致时样本被收录。
- 数据预处理:移除了包含特定模型名、公司名、中文和俄文的样本。预处理脚本见代码仓库中的 processing/posttraining 文件夹。
偏见、风险与局限性
- 大部分数据由第三方开放权重模型生成,可能引入非预期的语言和文化偏见。
- 安全对齐配对可能包含有毒或危险内容。
- 数据未区分同一语言的不同变体(如美式英语和英式英语)。
数据集结构
数据集包含四个子集,当前版本提供其中三个。
| 子集名称 | 描述 | 状态 |
|---|---|---|
sft_instruct |
无思考轨迹的指令数据 | 已提供 |
sft_thinking |
带有思考轨迹的指令数据 | 已提供 |
dpo_instruct |
无思考轨迹的接受/拒绝响应配对 | 已提供 |
dpo_thinking |
带有思考轨迹的接受/拒绝响应配对 | 即将推出 |
数据特征
- SFT 子集 (
sft_instruct,sft_thinking):包含messages字段,采用 HuggingFace 聊天格式。 - DPO 子集 (
dpo_instruct):包含chosen和rejected字段,每个字段均为对话格式,仅最后一条assistant回复不同。
数据划分与规模
数据按配置(config)和拆分(split)组织,每个拆分有独立的样本量和字节数。
dpo_instruct 配置的拆分
| 拆分名称 | 样本数 | 字节数 |
|---|---|---|
| dolci_flan | 30,009 | 93,470,441 |
| dolci_instruct_dpo_persona_precise_if | 4,102 | 11,675,333 |
| dolci_instruct_dpo_precise_if | 14,224 | 56,594,779 |
| dolci_python_algorithms | 184,361 | 787,968,960 |
| dolci_sciriff | 4,247 | 43,425,434 |
| nemotron_code | 30,054 | 244,686,471 |
| nemotron_instruction_following_chat_v1 | 70,032 | 1,601,478,867 |
| nemotron_math | 21,098 | 108,803,362 |
| nemotron_safety | 24,085 | 100,125,061 |
| nemotron_stem | 65,738 | 341,469,602 |
| pleias_rag | 7,891 | 201,478,603 |
| smol_instruct_rewrite | 1,787 | 2,208,387 |
| smolrewrite | 3,016 | 10,017,564 |
| smolsummarize | 5,949 | 26,356,924 |
| when2call | 9,000 | 36,565,517 |
| xlam | 51,632 | 224,893,643 |
sft_instruct 配置的拆分
| 拆分名称 | 样本数 | 字节数 |
|---|---|---|
| dolci_flan | 3,472 | 107,784,210 |
| dolci_logic_puzzles | 83,472 | 107,784,210 |
| dolci_instruct_precise_if | 126,271 | 263,950,453 |
| dolci_python_algorithms | 186,038 | 296,864,669 |
| dolci_sciriff | 4,460 | 22,228,226 |
| nemotron_code | 173,047 | 950,381,906 |
| nemotron_instruction_following_chat_v1 | 218,343 | 2,922,631,310 |
| nemotron_math_v2 | 239,362 | 484,546,923 |
| nemotron_posttraining_v2_math_french | 1,000 | 15,678,092 |
| nemotron_stem | 348,608 | 761,734,450 |
| pleias_rag | 796,582 | 12,851,037,010 |
| paradocs | 70,000 | 63,732,438 |
| smol_instruct_rewrite | 13,000 | 5,381,064 |
| smolrewrite | 15,000 | 24,776,697 |
| smolsummarize | 35,000 | 80,854,929 |
| when2call | 7,437 | 15,722,853 |
| xlam | 60,000 | 116,359,989 |
| context_qa_hotpot | 74,393 | 474,609,683 |
| context_qa_tat | 7,195 | 26,401,532 |
| croissant_aligned_instruct | 12,129 | 4,144,675 |
| hardcoded_en | 1,108 | 200,770 |
| hardcoded_fr | 962 | 215,218 |
| hermes | 1,893 | 16,907,558 |
| linagora_personas_math | 16,448 | 44,022,031 |
sft_thinking 配置的拆分
| 拆分名称 | 样本数 | 字节数 |
|---|---|---|
| dolci_think_sft_persona_precise_if | 216,083 | 1,274,545,838 |
| dolci_think_sft_precise_if | 118,644 | 1,387,191,105 |
| nemotron_agentic_toolcalling | 293,291 | 6,598,244,005 |
| nemotron_instruction_following_chat_v1 | 216,083 | 1,274,545,838 |
| nemotron_posttrain_v3_math | 1,251,769 | 4,886,080,343 |
| nemotron_posttraining_v2_math_french | 80,000 | 1,262,603,542 |
| nemotron_science_v1_mcq | 173,276 | 1,724,960,038 |
| nemotron_code | 110,796 | 5,413,208,846 |
| pleias_rag | 796,582 | 12,812,113,147 |
| opencodereasoning | 477,868 | 16,683,924,673 |
| smoltalk_smolagents_toolcalling | 9,079 | 207,000,591 |
| synthetic_2_SFT_verified | 103,254 | 2,593,211,389 |
数据来源
数据来源于多个开放数据集,按类别划分。部分数据集在训练中仅使用了随机子样本,权重(以青色显示)表示使用比例。所有数据集默认使用英语,特殊情况以紫色标注。
- 聊天/指令跟随(Chat/IF):包含 Nemotron-Instruction-Following-Chat-v1、Dolci-Think-SFT(多个变体)、Dolci-Instruct-SFT、Dolci-Instruct-DPO、smoltalk 系列(smol-instruct-rewrite、smolrewrite、smolsummarize)等。
- 数学(Math):包含 Nemotron-Post-training-v3 low no tools、SYNTHETIC-2-SFT-Verified、Nemotron-Post-Training-Dataset-v2 及其多语言版本等。