cavendishlabs/rebus
收藏资源简介:
--- dataset_info: features: - name: Filename dtype: string - name: Solution dtype: string - name: Also accept dtype: string - name: Theme dtype: string - name: Difficulty dtype: string - name: Exact spelling? dtype: string - name: Specific reference dtype: string - name: Reading? dtype: string - name: Attribution dtype: string - name: Author dtype: string - name: image dtype: image splits: - name: train num_bytes: 51545282.0 num_examples: 333 download_size: 47656838 dataset_size: 51545282.0 configs: - config_name: default data_files: - split: train path: data/train-* --- # REBUS REBUS: A Robust Evaluation Benchmark of Understanding Symbols [**Paper**](https://arxiv.org/abs/2401.05604) | [**🤗 Dataset**](https://huggingface.co/datasets/cavendishlabs/rebus) | [**GitHub**](https://github.com/cvndsh/rebus) | [**Website**](https://cavendishlabs.org/rebus/) ## Introduction Recent advances in large language models have led to the development of multimodal LLMs (MLLMs), which take both image data and text as an input. Virtually all of these models have been announced within the past year, leading to a significant need for benchmarks evaluating the abilities of these models to reason truthfully and accurately on a diverse set of tasks. When Google announced Gemini Pro (Gemini Team et al., 2023), they displayed its ability to solve rebuses—wordplay puzzles which involve creatively adding and subtracting letters from words derived from text and images. The diversity of rebuses allows for a broad evaluation of multimodal reasoning capabilities, including image recognition, multi-step reasoning, and understanding the human creator's intent. We present REBUS: a collection of 333 hand-crafted rebuses spanning 13 diverse categories, including hand-drawn and digital images created by nine contributors. Samples are presented in the table below. Notably, GPT-4V, the most powerful model we evaluated, answered only 24% of puzzles correctly, highlighting the poor capabilities of MLLMs in new and unexpected domains to which human reasoning generalizes with comparative ease. Open-source models perform even worse, with a median accuracy below 1%. We notice that models often give faithless explanations, fail to change their minds after an initial approach doesn't work, and remain highly uncalibrated on their own abilities. 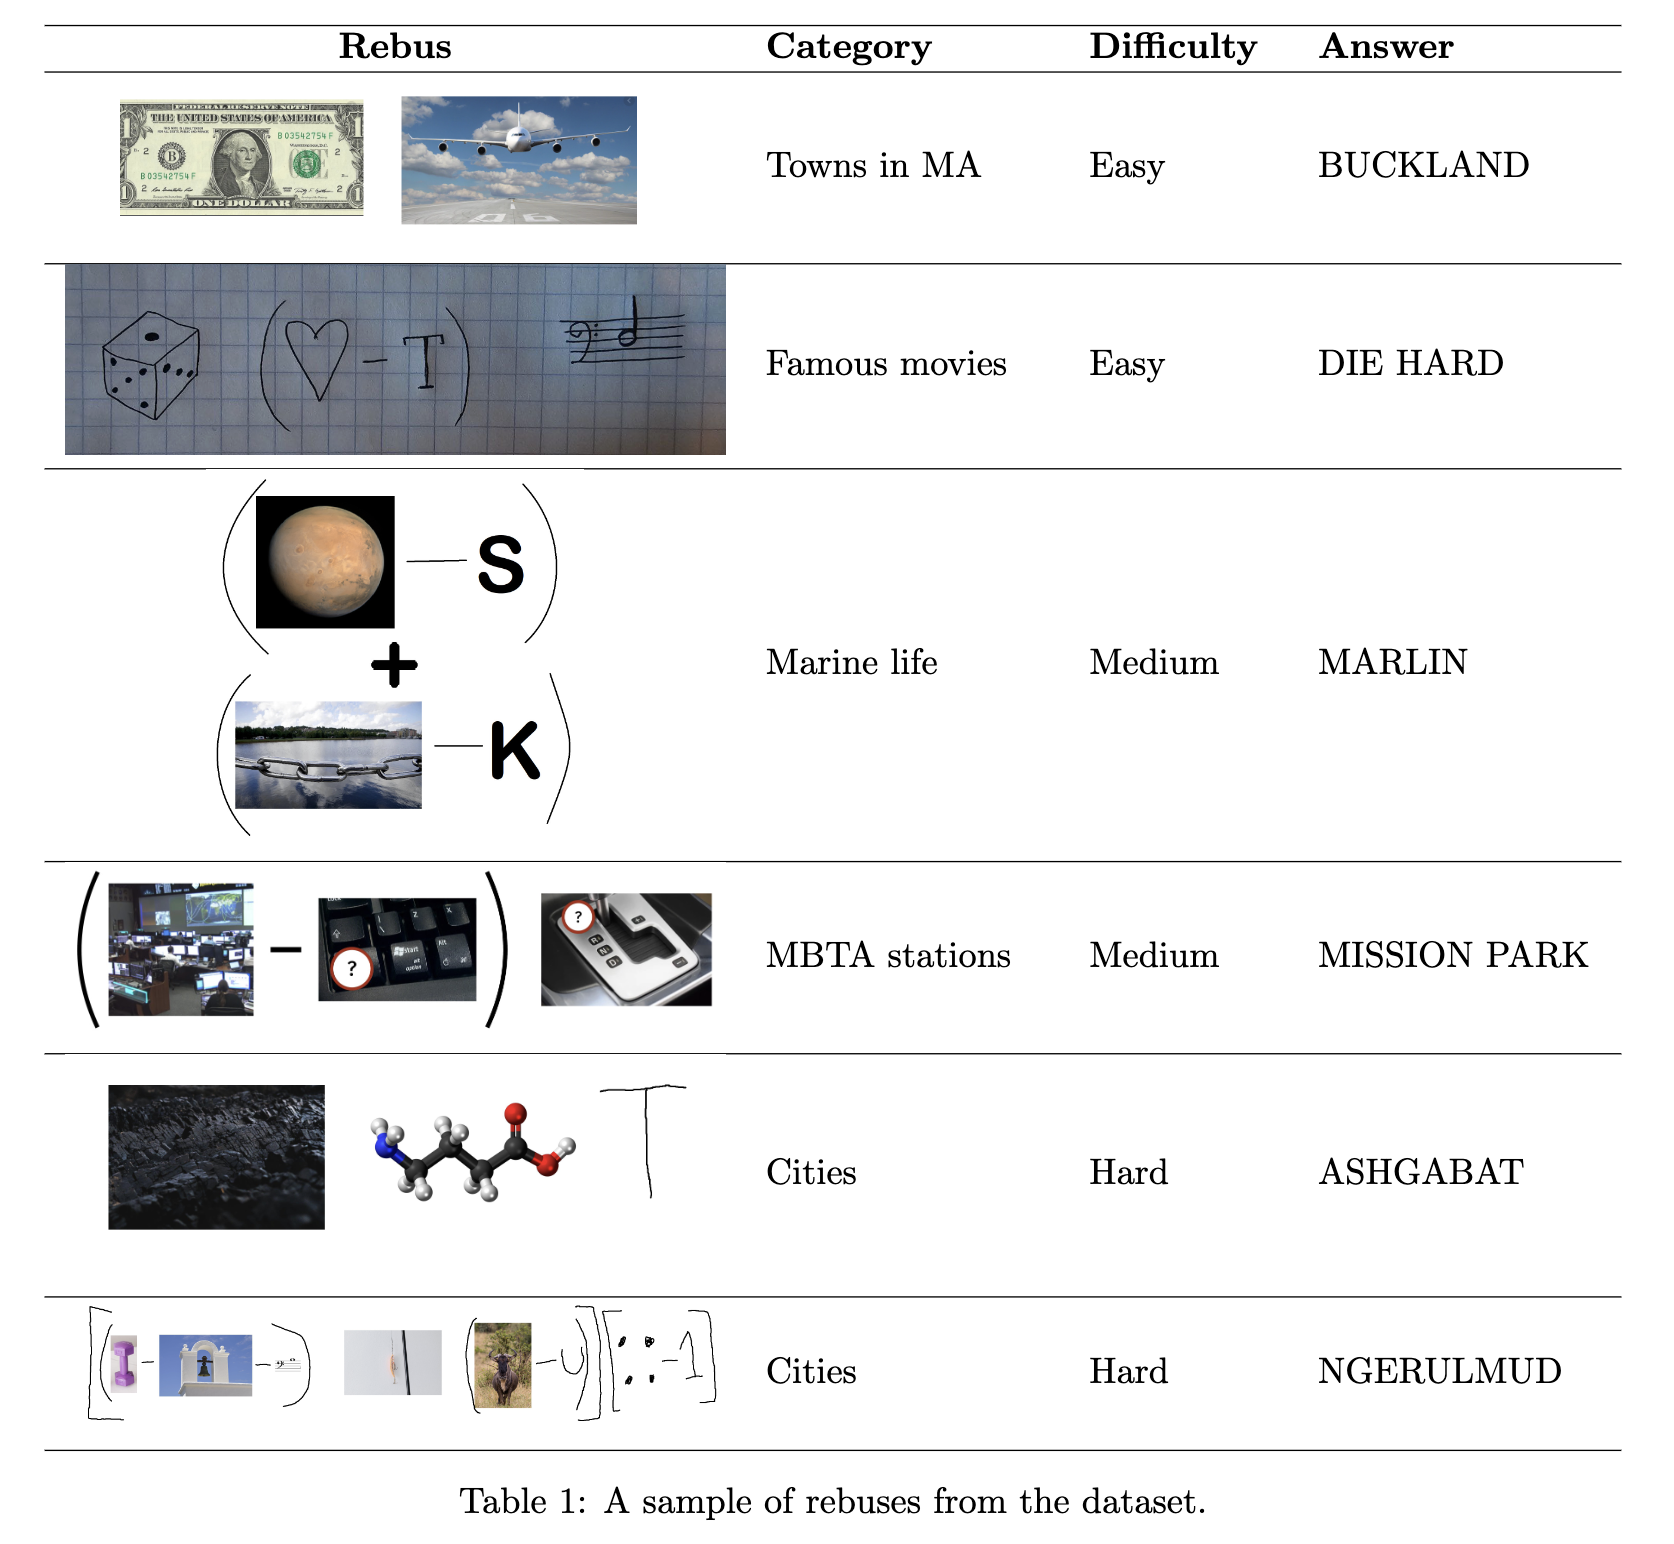 ## Evaluation results | Model | Overall | Easy | Medium | Hard | | ----------------- | ------------- | ------------- | ------------- | ------------ | | GPT-4V | **24.0** | **33.0** | **13.2** | **7.1** | | Gemini Pro | 13.2 | 19.4 | 5.3 | 3.6 | | LLaVa-1.5-13B | 1.8 | 2.6 | 0.9 | 0.0 | | LLaVa-1.5-7B | 1.5 | 2.6 | 0.0 | 0.0 | | BLIP2-FLAN-T5-XXL | 0.9 | 0.5 | 1.8 | 0.0 | | CogVLM | 0.9 | 1.6 | 0.0 | 0.0 | | QWEN | 0.9 | 1.6 | 0.0 | 0.0 | | InstructBLIP | 0.6 | 0.5 | 0.9 | 0.0 |
数据集信息: 特征: - 名称:Filename(文件名),数据类型:字符串 - 名称:Solution(参考答案),数据类型:字符串 - 名称:Also accept(可接受替代答案),数据类型:字符串 - 名称:Theme(主题),数据类型:字符串 - 名称:Difficulty(难度),数据类型:字符串 - 名称:Exact spelling?(拼写是否严格匹配?),数据类型:字符串 - 名称:Specific reference(具体参考文献),数据类型:字符串 - 名称:Reading?(是否需要阅读?),数据类型:字符串 - 名称:Attribution(署名),数据类型:字符串 - 名称:Author(作者),数据类型:字符串 - 名称:image(图像),数据类型:图像 数据集划分: - 划分名称:train(训练集),字节数:51545282.0,样本数:333 下载大小:47656838 数据集总大小:51545282.0 配置: - 配置名称:default(默认配置),数据文件: - 划分:train,路径:data/train-* # REBUS:符号理解鲁棒性评估基准 [**论文**](https://arxiv.org/abs/2401.05604) | [**🤗 数据集**](https://huggingface.co/datasets/cavendishlabs/rebus) | [**GitHub**](https://github.com/cvndsh/rebus) | [**官网**](https://cavendishlabs.org/rebus/) ## 简介 近年来,大语言模型(Large Language Model, LLM)的快速发展推动了多模态大语言模型(Multimodal Large Language Model, MLLM)的问世,这类模型能够同时以图像数据与文本作为输入。几乎所有这类模型都在过去一年内发布,因此亟需能够评估这些模型在多样化任务中开展真实且准确推理的基准数据集。当谷歌发布Gemini Pro(Gemini团队等,2023)时,其展示了其解决画谜(rebus)的能力——这类文字游戏谜题需要通过创造性地对源自文本与图像的单词进行字母增删操作来求解。画谜的多样性使其能够广泛评估多模态推理能力,包括图像识别、多步推理以及对人类创作者意图的理解。 我们提出REBUS:一个包含333个手工制作的画谜的数据集,涵盖13个多样化类别,包含由9位创作者制作的手绘与数字图像。示例如下表所示。值得注意的是,我们评估的最强模型GPT-4V仅能正确解答24%的谜题,这表明多模态大语言模型在人类推理可轻松泛化的全新与未知领域中能力仍存在显著不足。开源模型的表现更差,准确率中位数低于1%。我们观察到,模型往往会给出不可靠的解释,在初始推理路径失效后无法调整思路,且对自身能力的校准度极低。  ## 评估结果 | 模型 | 总体准确率 | 简单难度 | 中等难度 | 困难难度 | | ------------------ | ---------- | -------- | -------- | -------- | | GPT-4V | **24.0** | **33.0** | **13.2** | **7.1** | | Gemini Pro | 13.2 | 19.4 | 5.3 | 3.6 | | LLaVa-1.5-13B | 1.8 | 2.6 | 0.9 | 0.0 | | LLaVa-1.5-7B | 1.5 | 2.6 | 0.0 | 0.0 | | BLIP2-FLAN-T5-XXL | 0.9 | 0.5 | 1.8 | 0.0 | | CogVLM | 0.9 | 1.6 | 0.0 | 0.0 | | QWEN | 0.9 | 1.6 | 0.0 | 0.0 | | InstructBLIP | 0.6 | 0.5 | 0.9 | 0.0 |
数据集概述
数据集信息
-
特征列表:
Filename:文件名,数据类型为字符串。Solution:解决方案,数据类型为字符串。Also accept:也接受,数据类型为字符串。Theme:主题,数据类型为字符串。Difficulty:难度,数据类型为字符串。Exact spelling?:精确拼写?数据类型为字符串。Specific reference:特定引用,数据类型为字符串。Reading?:阅读?数据类型为字符串。Attribution:归属,数据类型为字符串。Author:作者,数据类型为字符串。image:图像,数据类型为图像。
-
数据分割:
train:训练集,包含333个样本,总字节数为51545282.0。
-
数据集大小:
- 下载大小:47656838字节
- 数据集大小:51545282.0字节
-
配置:
default:默认配置,数据文件路径为data/train-*。
评估结果
| 模型 | 总体 | 简单 | 中等 | 困难 |
|---|---|---|---|---|
| GPT-4V | 24.0 | 33.0 | 13.2 | 7.1 |
| Gemini Pro | 13.2 | 19.4 | 5.3 | 3.6 |
| LLaVa-1.5-13B | 1.8 | 2.6 | 0.9 | 0.0 |
| LLaVa-1.5-7B | 1.5 | 2.6 | 0.0 | 0.0 |
| BLIP2-FLAN-T5-XXL | 0.9 | 0.5 | 1.8 | 0.0 |
| CogVLM | 0.9 | 1.6 | 0.0 | 0.0 |
| QWEN | 0.9 | 1.6 | 0.0 | 0.0 |
| InstructBLIP | 0.6 | 0.5 | 0.9 | 0.0 |