
遇见数据集

omnimcp_agentops_vector_reranker_teaser

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

该数据集是 OmniMCP AgentOps 向量重排序 AI 智能体的免费样本数据集,包含 25 个经过验证的多轮对话样本。所有样本均通过 Pydantic 和 AST 模式验证,确保零语法幻觉。每个工具调用前都包含显式的链式思维推理步骤(<thought> 标签),并预先训练了自我修复和错误恢复能力,能够处理真实 API 错误、参数不匹配和超时等问题。该数据集适用于训练和评估 AgentOps 领域的向量重排序 AI 智能体。

This dataset is a free sample dataset for the OmniMCP AgentOps vector re-ranking AI agent, containing 25 validated multi-turn conversation samples. All samples are validated via Pydantic and AST schema, ensuring zero syntax hallucinations. Each tool call is preceded by an explicit chain-of-thought reasoning step (<thought> tag), and is pre-trained with self-healing and error recovery capabilities, capable of handling real API errors, parameter mismatches, and timeouts. This dataset is suitable for training and evaluating vector re-ranking AI agents in the AgentOps domain.

创建时间:
2026-08-31
原始信息汇总

OmniMCP AgentOps Vector Reranker Teaser Dataset(免费版)概述

基本信息

  • 语言:英语
  • 许可证:Apache 2.0
  • 标签:agentops_vector_reranker、函数调用、工具使用、合成数据、微调、智能体

数据集内容

该数据集是面向 AgentOps Vector Reranker AI 智能体的免费示例集,包含 25 个经过验证的多轮对话样本。完整的生产级主套件(包含 500+ 验证多轮样本及 EULA 许可证)需通过外部商店购买获取。

核心特性

  • 100% Pydantic 与 AST Schema 验证:确保零语法幻觉
  • 思维链推理:每次工具调用前包含显式的 <thought> 逐步逻辑说明
  • 自愈与错误恢复:数据集已针对处理真实 API 错误、参数不匹配和超时场景进行预训练

数据用途

该数据集适用于 AgentOps 向量重排序 AI 智能体的微调,特别强调:

  • 工具使用与函数调用的准确性
  • 多轮对话中的推理能力
  • 运行时错误恢复与自愈机制

相关完整产品矩阵

数据集所属的 OmniMCP 生态体系包含 40 个活跃产品,按层级分为:

  • Metropolis 层级:1 个综合套件(覆盖全部领域,800+ 样本),售价 299 欧元
  • Village 层级:15 个领域专项套件(如自主智能体、网络安全、法律科技、健康科技、金融科技等),售价 99-249 欧元
  • Brick 层级:24 个功能模块级数据集(如 Playwright、Neo4j、LangGraph、各类 SQL 审计工具等),售价 29-99 欧元
搜集汇总
数据集介绍
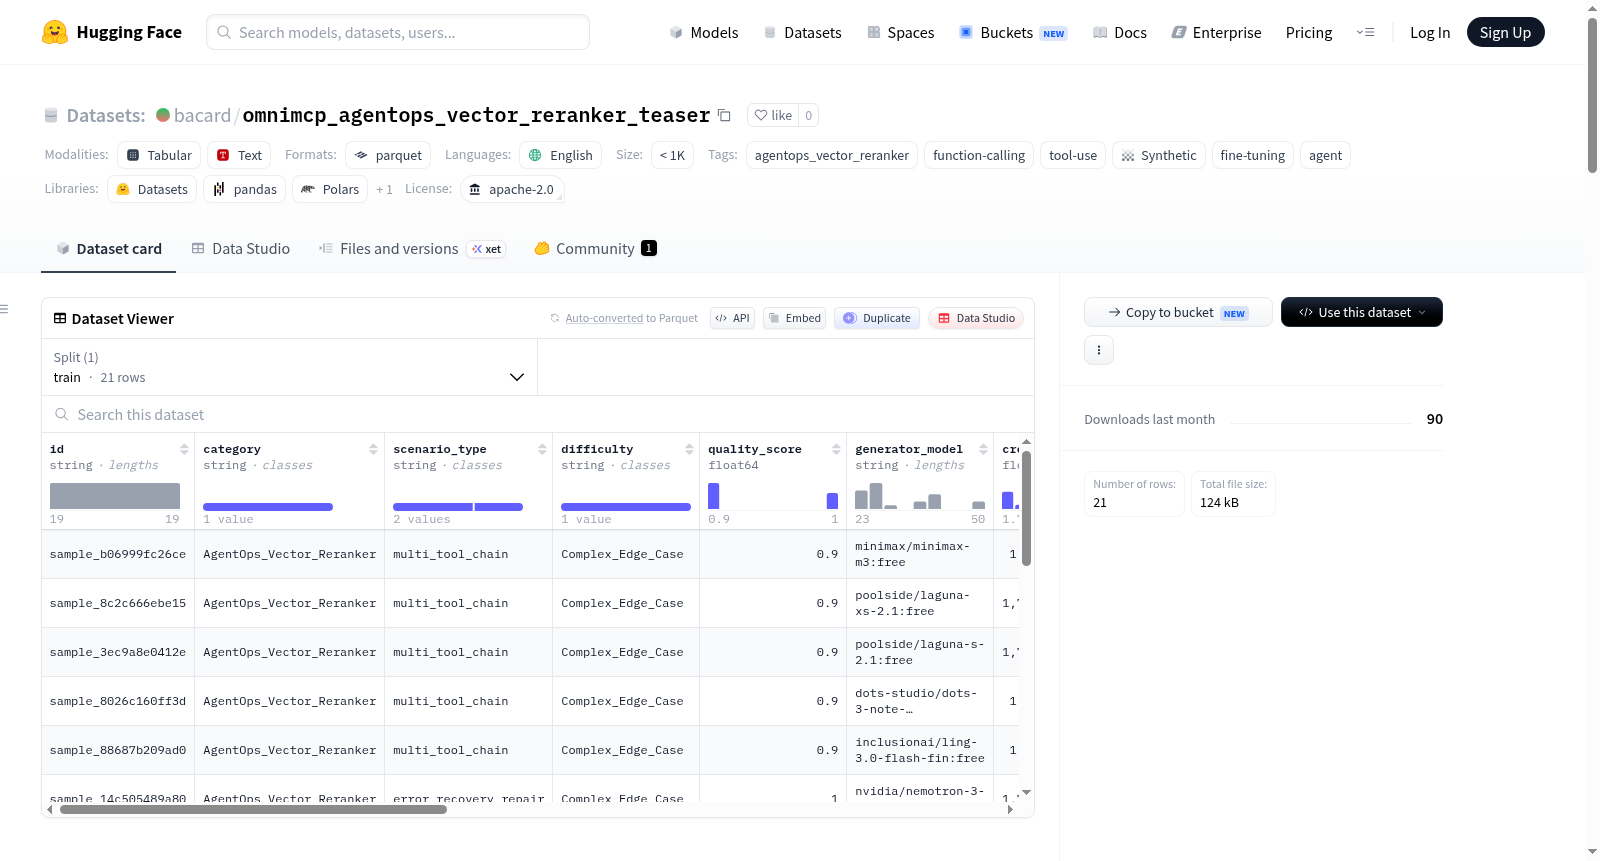
omnimcp_agentops_vector_reranker_teaser 数据集图片
构建方式
在智能体工具调用与函数编排日益复杂的背景下,该数据集以严格的模式验证为基石构建而成。全部样本经由Pydantic模型与抽象语法树(AST)双重检验,从源头上杜绝了语法幻觉与结构偏差。每个多轮对话样本均嵌入显式的思维链推理,在每次工具调用前以<thought>标签标注逐步逻辑。同时,样本预置了真实API错误、参数不匹配及超时等异常场景,使数据具备自愈与错误恢复能力。这一构建路径确保了合成数据在结构与语义层面均达到可部署级质量。
特点
该数据集的核心特质在于其高保真与可验证性。所有样本均通过Pydantic与AST模式验证,实现零语法幻觉;思维链推理的显式嵌入使智能体的决策过程透明可溯;自愈与错误恢复机制则覆盖了实际部署中常见的API故障、参数偏差与超时情形。作为免费预览版本,其包含25条经过验证的多轮样本,聚焦于智能体向量重排序与工具调用场景,为后续大规模商业套件提供了可靠的性能基线。
使用方法
在使用层面,该数据集可直接服务于智能体向量重排序器的微调与评估。研究者可将样本载入HuggingFace数据集库,利用其多轮对话结构与<thought>推理步骤进行监督式微调,以增强模型在函数调用与工具使用中的鲁棒性。同时,样本中集成的错误恢复场景可用于测试智能体的自愈能力,评估其在API异常下的响应质量。通过解析Pydantic与AST验证标签,亦可构建自动化的模式合规性检查流程,确保生成输出符合预定义接口规范。
背景与挑战
背景概述
随着大语言模型智能体在工具调用与函数执行领域的迅速崛起,如何确保智能体在多轮交互中精准选取向量重排序策略,已成为AgentOps方向的核心议题。omnimcp_agentops_vector_reranker_teaser数据集由OmniMCP项目团队构建,以免费预览版形式于2025年发布,包含25条经Pydantic与AST模式严格验证的多轮样本。该数据集聚焦智能体向量重排序器的微调与评估,通过思维链推理与自愈错误恢复机制,为工具调用场景下的检索增强生成提供了高质量的合成训练资源,对推动智能体运维自动化具有显著的先导意义。
当前挑战
该数据集所应对的领域问题在于智能体工具调用过程中向量重排序的语义对齐与鲁棒性挑战,即如何在多轮对话中依据用户意图动态筛选最优工具候选。构建过程中面临多重挑战:合成样本须严格遵循Pydantic与AST模式校验以杜绝语法幻觉,同时需嵌入显式思维链步骤以支撑可解释推理;此外,样本应预训练处理真实API错误、参数不匹配及超时等异常情形,实现自愈与错误恢复,这对数据生成的语义保真度与逻辑一致性提出了极高标准。
常用场景
经典使用场景
在智能体(Agent)与工具调用(Tool-Use)研究领域,该数据集经典地服务于向量重排序器的微调与评估。其核心使用场景在于:给定多轮对话中的用户意图与一系列候选工具调用方案,模型需借助思维链(Chain-of-Thought)推理,对候选方案进行相关性重排序,从而筛选出最符合上下文与API约束的工具调用序列。25条经过Pydantic与AST模式验证的样本,为研究者提供了零语法幻觉的高质量多轮交互轨迹,成为智能体决策链路中重排序环节的基准测试床。
衍生相关工作
以该数据集为起点,衍生出一系列围绕智能体工具调用优化与运维的经典工作。其中包括面向生产级多轮工具调用的完整套件,如涵盖沙箱文件系统、GitHub操作与搜索路由的MCP生产大师村;以及专注于自主代码重构、错误回溯修复与严格类型检查的专项模块。此外,针对Stripe计费、长期记忆压缩与多智能体协同等场景的衍生数据集,亦广泛借鉴了其思维链标注与模式验证范式,推动了AgentOps工具生态的繁荣。
数据集最近研究
最新研究方向
在智能体工具调用与函数编排日益复杂的背景下,该数据集聚焦于基于向量重排序的AgentOps运行时优化研究,通过引入思维链推理与自愈式错误恢复机制,探索多轮工具调用中参数漂移、超时重试及API语义失配的鲁棒性建模。当前研究前沿正将向量重排序器与MCP协议发现路由、Redis语义缓存及令牌看门狗联动,以缓解长程任务中的上下文膨胀与调用幻觉。同时,该数据集与欧盟AI法案合规审计、GDPR数据处理验证等热点治理议题形成交叉,为高风控场景下的自主智能体提供可验证的决策轨迹与模式约束校验,推动了智能体运维从静态微调向动态自愈与成本可控方向的范式演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


