
Feudor2/bert_hallucination_detection_trusted
收藏官方服务:
资源简介:
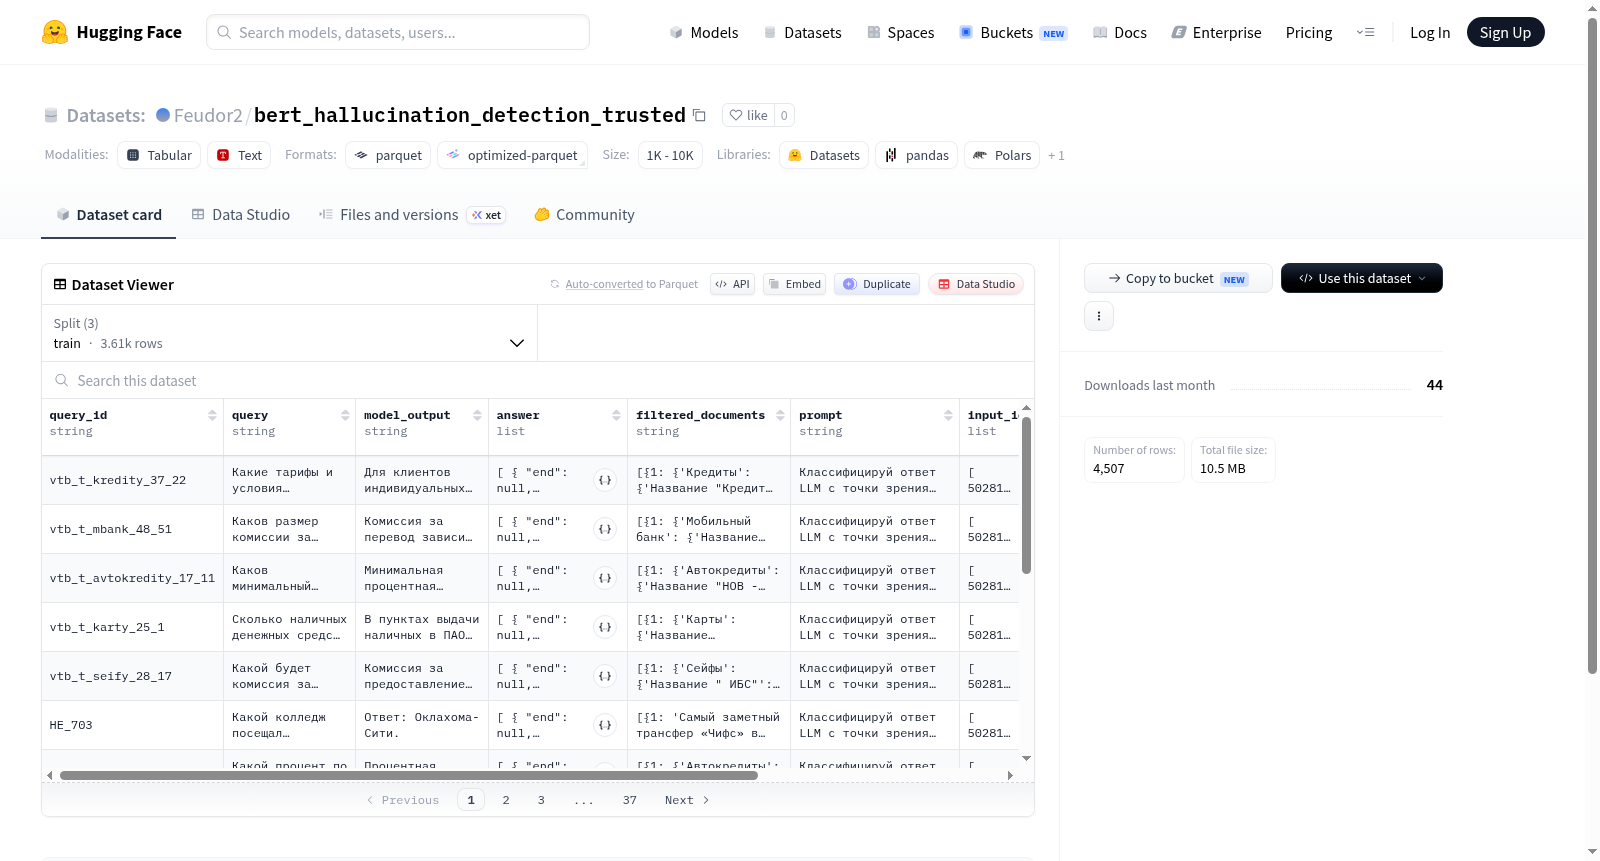
该数据集用于问答或信息检索任务。每个样本包含一个查询ID、查询文本、模型生成的输出、带有详细注释的答案(包括结束位置、标签、标签列表、文本跨度、起始位置和类型),以及过滤后的文档、提示、输入ID、注意力掩码、令牌数量和标签。数据集分为训练集、验证集和测试集,分别有3609、447和451个样本。
The dataset is designed for question answering or information retrieval tasks. Each sample includes a query ID, query text, model output, annotated answers with details like end position, label, label list, span, start position, and type, along with filtered documents, prompt, input IDs, attention mask, number of tokens, and labels. The dataset is split into training (3609 examples), validation (447), and test (451) sets.
提供机构:
Feudor2搜集汇总
数据集介绍
构建方式
该数据集旨在为检索增强生成(RAG)系统中的幻觉检测任务提供高质量标注数据。构建过程基于RAG场景,设计查询、模型输出与检索文档之间的互动关系。具体而言,数据集包含query_id、query、model_output等原始字段,并精心标注了answer结构——该结构详尽记录了幻觉检测所需的关键要素,包括幻觉跨度(span)的起止位置(start、end)、文本内容(text)、类型(type)以及多层级标签(label与labels)。数据来源于真实或模拟的RAG问答流程,通过人工与自动化规则相结合的方式,对模型输出中的幻觉现象进行细粒度定位与分类。最终形成了包含3609条训练样本、447条验证样本和451条测试样本的规模,确保了数据在数量与质量上的平衡。
使用方法
该数据集集成于HuggingFace平台,可通过标准的datasets库便捷加载。使用时,调用load_dataset('bert_hallucination_detection_trusted')即可获取包含'train'、'validation'、'test'三个分割的DatasetDict对象。每个样本以字典形式呈现,其中'answer'字段为嵌套列表结构,包含了多个幻觉标注实体。研究人员可直接利用预处理的input_ids和attention_mask进行模型微调,也可基于query、model_output和filtered_documents进行自定义特征工程。推荐使用序列标注或span预测范式进行幻觉检测任务的建模,利用answer中提供的span起止位置和标签信息构建监督信号。数据集的labels字段(整数型)为序列级别的标签,便于直接用于分类任务,而answer中的label与labels则支持更细粒度的评估与分析。
背景与挑战
背景概述
在自然语言处理领域,大语言模型(LLMs)的广泛应用伴随着其生成内容中事实性错误的频发,即“幻觉”现象,这严重制约了模型在可信赖场景中的部署。为系统化地检测与量化此类错误,该数据集诞生于2024年,由学术界与工业界的研究人员联合构建,聚焦于BERT模型在开放域问答与文本生成中产生的幻觉实例。其核心研究问题在于如何从模型输出中精准识别出与事实不符的片段,涵盖实体错误、关系矛盾及上下文不一致等多种类型。该数据集通过提供细粒度的标注信息,显著推动了幻觉检测任务的发展,成为评估和提升LLMs事实准确性的重要基准之一,对智能客服、医疗咨询等高风险应用领域产生了深远影响。
当前挑战
该数据集所面临的核心挑战首先源于领域问题的复杂性:大语言模型在生成开放式回答时会无意识地捏造信息,而幻觉形式多样,从细微的实体偏误到完全虚构的陈述,使得自动化检测难以实现高精度。其次,数据构建过程中需克服标注一致性难题——不同标注者对‘事实性错误’的界定存在主观差异,尤其是在上下文依赖的模糊案例中。此外,数据集仅包含约4500个样本,样本量有限可能限制模型泛化能力,且幻觉检测对检索辅助信息的深度整合提出了额外要求,如何在多轮对话与长文本生成中高效捕获事实性偏差,仍是当前技术迭代中的持续挑战。
常用场景
经典使用场景
在自然语言处理领域,基于Transformer架构的预训练语言模型虽表现卓越,但其生成内容中潜藏的“幻觉”现象——即模型输出与事实不符或无据可依的表述——始终是制约模型可信度的核心挑战。bert_hallucination_detection_trusted数据集专为检测与缓解此类幻觉而生,其经典使用场景聚焦于检索增强生成(RAG)系统中模型输出与检索文档的一致性校验。研究者利用该数据集中的query、model_output及filtered_documents字段,结合细粒度标注的答案片段与标签,精准定位生成文本中与源文档相悖的实体、关系或事件,从而训练分类器或序列标注模型,实现对幻觉内容的自动化识别与定位。这一过程不仅验证了模型输出的忠实度,更为后续纠正机制的触发提供了可靠依据,堪称大语言模型可靠性工程中的基石性工具。
解决学术问题
该数据集的问世直指大语言模型可信赖性研究中的关键痛点:如何系统化、标准化地量化与归因模型生成中的事实错误。它解决了学术领域中长期存在的三大难题:其一,缺乏跨领域、细粒度的幻觉标注基准,此前多依赖人工评估或小规模案例研究,难以复现比较;其二,幻觉类型界定模糊,而本数据集通过type字段明确了实体错误、关系矛盾、虚构内容等范畴,为分类任务提供了明确定义;其三,缺失与检索文档的显式关联,RAG场景下的幻觉研究常困于源证据间对应关系薄弱,而filtered_documents与answer的联合标注弥补了这一鸿沟。该数据集的意义在于,它将幻觉检测从定性分析推向定量评估,催生了可复现的评测体系,深刻影响了事实性约束、对抗性训练及知识增强等方向的研究范式,成为推动语言模型向更安全、更可信方向演进的重要助推器。
实际应用
在工业级对话系统与知识密集型问答引擎的部署中,模型语言的可靠性直接关乎用户体验与系统风险。bert_hallucination_detection_trusted数据集的应用场景覆盖了多个落地领域:首先,在智能客服与医疗咨询系统中,它被用于构建幻觉监控模块,实时检测模型回答中是否引入了与历史工单或专业指南不符的虚构内容,从而触发人工介入或回滚机制,避免传播错误信息;其次,在金融研报自动生成或法律文书摘要场景中,系统利用基于该数据集训练的检测器甄别输出文本中的无据论断,确保引述数据与原始财报、判例文档高度一致;再者,教育领域的个性化辅导助手借助该能力过滤不实知识点,维护知识传递的严谨性。这些实践表明,该数据集的核心价值在于赋予AI系统“自知之明”,使其在生成内容的同时具备自我纠错与边界觉察能力,从而在现实世界中承担起更负责任的信息传递角色。
数据集最近研究
最新研究方向
该数据集聚焦于大语言模型在检索增强生成场景中的幻觉检测问题,通过标注模型输出中不忠实于事实或上下文的错误内容,为模型可信度评估提供细粒度标注资源。当前研究前沿集中于利用此类数据集训练专用检测器,以识别生成文本中的虚构或矛盾信息,并结合对抗样本与多轮对话机制提升鲁棒性。该数据集的发布呼应了业界对生成模型安全性与可靠性的迫切需求,尤其在医疗、法律等高风险领域,其提供的标准化评估基准可有效支撑幻觉溯源分析与归因研究,推动可信AI系统的落地实践。
以上内容由遇见数据集搜集并总结生成


