
遇见数据集

zhanfwei-0226/phreshphish

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

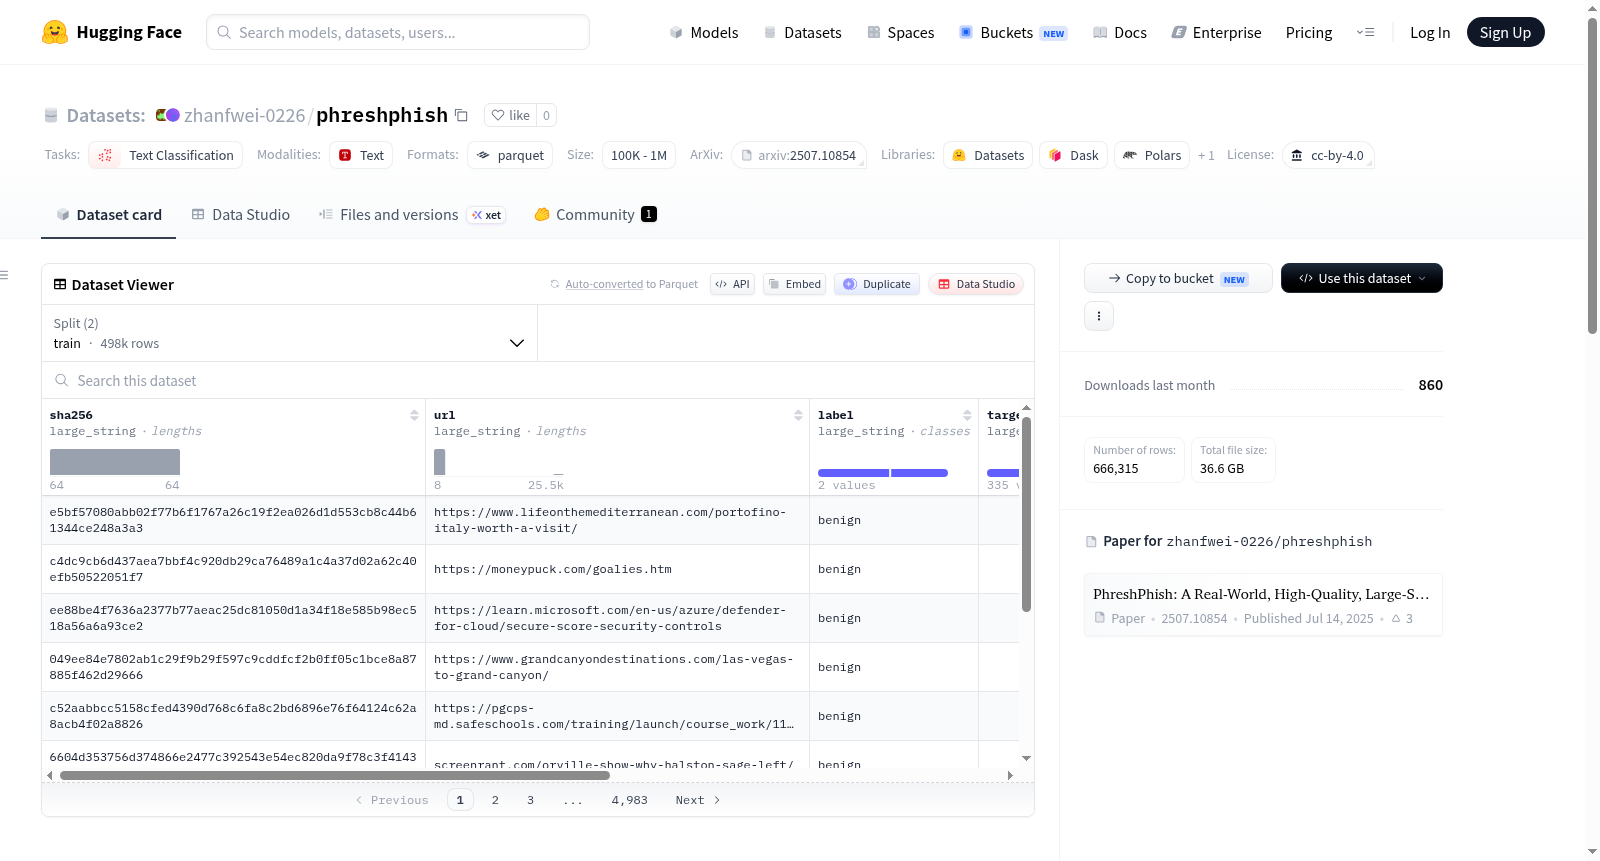
PhreshPhish是一个用于钓鱼网页检测的大规模、真实世界的数据集和基准测试,包含钓鱼和良性HTML-URL对。训练集有498,255个样本(276,729个良性样本和221,526个钓鱼样本),测试集有168,060个样本(91,260个良性样本和76,876个钓鱼样本)。此外,还提供了975个基准测试,基准率范围从[5e-4, 1e-3, 5e-3, 1e-2, 5e-2]。数据集的使用仅限于反钓鱼研究,并遵循Creative Commons Attribution 4.0 International许可。

PhreshPhish is a large-scale, real-world dataset and benchmark for phishing webpage detection containing phishing and benign HTML-URL pairs. The train set has 498,255 samples: 276,729 benign and 221,526 phish, and the test set has 168,060 samples: 91,260 benign and 76,876 phish. Additionally, it includes 975 benchmarks with base rates ranging from [5e-4, 1e-3, 5e-3, 1e-2, 5e-2]. The dataset is released under Creative Commons Attribution 4.0 International license and should only be used for anti-phishing research.
提供机构:
zhanfwei-0226
搜集汇总
数据集介绍
zhanfwei-0226/phreshphish 数据集图片
构建方式
PhreshPhish是一个大规模、真实世界的网络钓鱼网页检测数据集,由恶意及良性HTML-URL对构成。其构建过程注重现实性与规模性,训练集包含498,255个样本,其中良性样本276,729个,钓鱼样本221,526个;测试集包含168,060个样本,良性与钓鱼样本分别为91,260个和76,876个。数据集版本历经迭代,v1.0.1版本新增了2025年3月至12月间收集的约20万样本,并通过降采样早期样本来增强时间一致性,确保数据能够反映最新的网络钓鱼威胁态势。
特点
该数据集的核心特点在于其真实世界属性与大规模标注。不仅样本数量庞大,且涵盖了从2025年5月初始版本到后续更新的广泛时间跨度,能够有效捕捉网络钓鱼攻击的演变模式。此外,PhreshPhish提供了975个基准测试子集,其基础发生率从0.0005到0.05不等,为评估不同场景下的检测算法性能提供了多维度的标准化测试平台,极具研究价值。
使用方法
使用PhreshPhish数据集十分便捷。研究人员只需通过HuggingFace的datasets库,利用`load_dataset`函数即可轻松加载训练集和测试集,例如`train = load_dataset('phreshphish/phreshphish', split='train')`。该数据集适用于文本分类任务,可直接用于训练和评估钓鱼网页检测模型。其数据格式为Parquet文件,支持高效读取,便于集成到现有的机器学习工作流中进行实验与验证。
背景与挑战
背景概述
PhreshPhish是一个于2025年发布的大规模真实世界钓鱼网页检测数据集,由Thomas Dalton、Hemanth Gowda等研究人员共同创建。该数据集旨在解决网络安全领域中恶意网页检测的紧迫问题,特别是针对日益复杂且不断演变的钓鱼攻击。通过提供包含真实钓鱼网站与正常网站的HTML-URL配对样本,PhreshPhish为评估和推动基于文本分类的钓鱼检测模型提供了标准化基准。其训练集包含近50万样本,测试集包含约17万样本,并设计了涵盖不同基础比率的975个基准任务,显著提升了该领域研究的可复现性与可比性,对网络威胁情报与主动防御技术的发展具有重要推动作用。
当前挑战
PhreshPhish所应对的核心领域挑战在于钓鱼网页检测的高动态性与隐蔽性,传统基于黑名单或静态特征的方案难以应对零日攻击与快速演变的钓鱼模式。该数据集通过大规模真实样本和时态一致性优化,力求模拟实际部署中检测模型面临的分布漂移与类别不平衡问题。在构建过程中,挑战包括如何从海量网络流量中精确标注钓鱼与良性页面,同时维护数据的真实性与时效性;此外,平衡不同时间窗口下的采样比例以避免时间偏差,以及设计能够反映现实低基率场景的基准评估体系,均是确保数据集质量与实用性的关键难点。
常用场景
经典使用场景
在网络钓鱼检测这一关乎数字信任与安全的领域中,PhreshPhish数据集凭借其大规模、真实世界的数据来源,成为了训练和评估网页钓鱼分类模型的基石。其经典的使用场景是作为二分类任务的基准,将HTML与URL配对样本分为‘良性’或‘钓鱼’类别。研究者常利用其提供的训练集(近50万样本)和测试集(约17万样本),以及涵盖不同基础发生率(从5e-4到5e-2)的975个基准测试,来严谨地衡量模型在极不平衡场景下的泛化能力。该数据集的设计尤其适合评估分类器在低基率条件下的鲁棒性,为构建更为精准的防御系统提供了标准化的实验平台。
解决学术问题
PhreshPhish数据集直面了网络安全学术研究中的核心困境:缺乏高质量、大规模且具备时间一致性的真实世界钓鱼网页样本,导致许多模型仅在过时或合成数据上表现良好。它解决了如何从海量真实流量中可靠提取并标注钓鱼网站这一技术难题,为模型在现实部署中可能遭遇的概念漂移和类别不平衡问题提供了评估依据。其深远意义在于,通过引入时间维度(如v1.0.1版更新了2025年的样本)和多样化的基准设置,推动了钓鱼检测研究从实验室理想化环境向真实对抗场景的跨越。这项数据集极大地促进了对抗性机器学习、在线学习等前沿议题在该领域的实证探索。
衍生相关工作
自PhreshPhish发布以来,它已孕育出一系列脍炙人口的衍生研究。一方面,基于该数据集,学者们开发了多种针对高不平衡数据训练的深度学习架构,如结合注意力机制的CNN-LSTM混合模型,以及利用对比学习增强特征表示的钓鱼检测器。另一方面,该数据集与算法公平性研究产生了交叉,部分工作探讨了模型对不同地区或语言钓鱼网页的识别偏差。此外,它还被用于评估大语言模型在理解恶意HTML语义方面的能力,推动了多模态钓鱼检测方案的出现。这些衍生工作不仅验证了PhreshPhish作为基准的权威性,也将其影响力从单一分类任务扩展至更广阔的AI安全理论前沿。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

