OmniCap-IF
收藏资源简介:
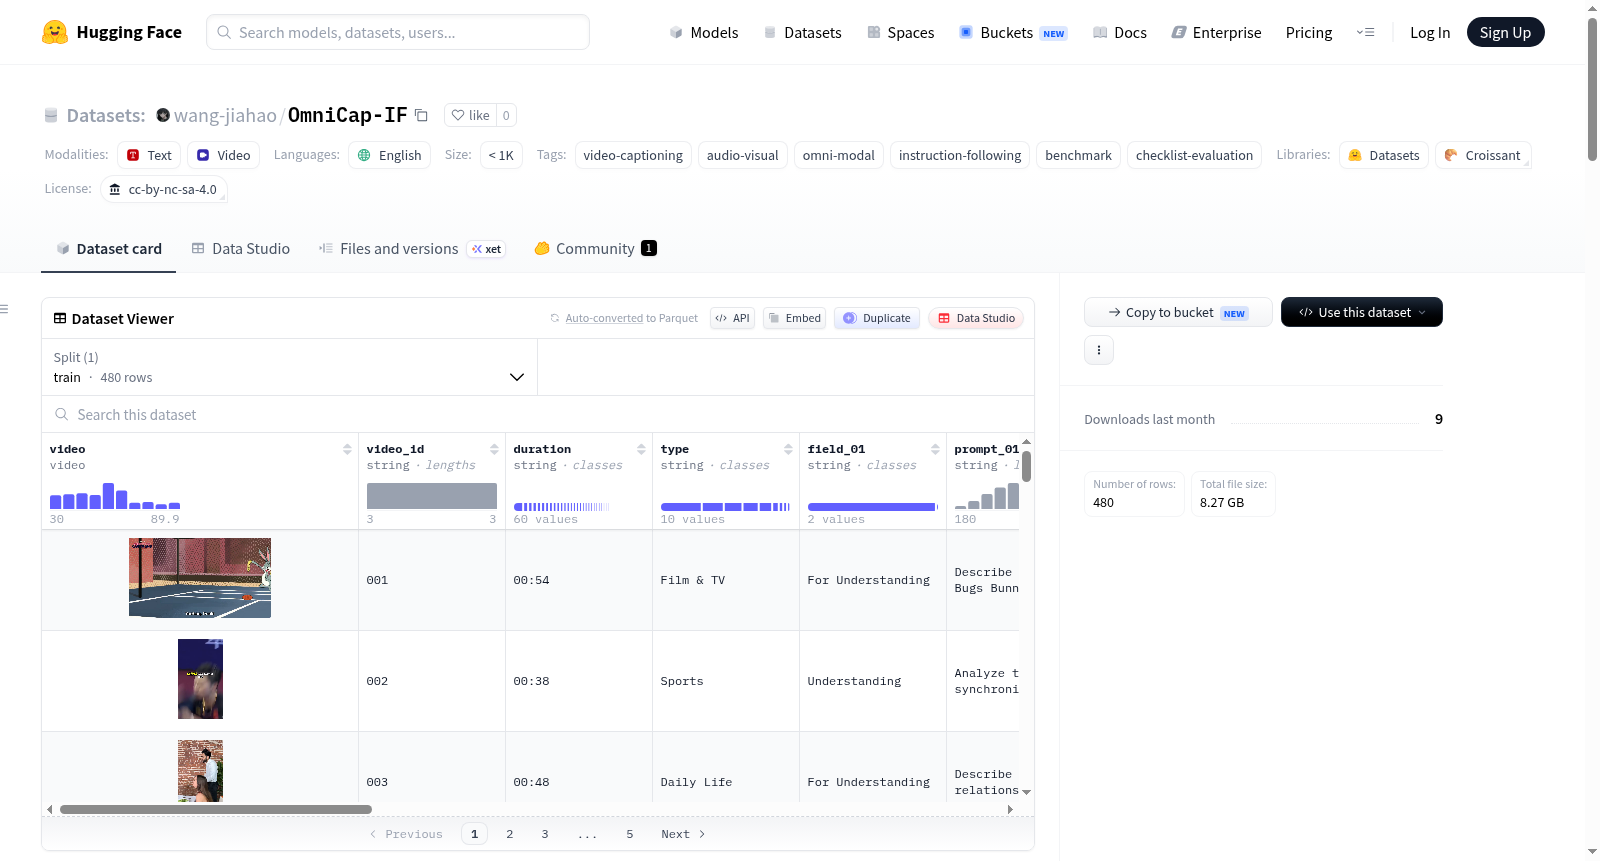
OmniCap-IF是一个用于评估全模态视频描述中指令遵循能力的基准测试数据集。该数据集旨在推动模型在生成有用视频描述的同时,精确满足用户明确指定的各种约束条件。数据集包含480个视频和1,920个指令样本,覆盖了理解、生成、检索和面向通信的视频描述任务。每个样本由一个提示词和一套细粒度的评估检查清单组成,用于系统性地评估模型在格式(如JSON、表格、时间戳)和内容(如视觉事件、音频事件、时间定位、视听因果关系)方面对指令的遵循程度。数据集的多样性体现在视频类别、时长、指令长度、约束数量及类型上,其核心评估焦点超越了通用的描述质量,强调模型对结构化、时间性、视觉、音频及视听融合约束的遵从能力。数据集文件结构包括注释文件(包含提示词、检查清单和视频元数据)、原始视频文件以及便于Hugging Face数据集查看器使用的轻量级元数据文件。
OmniCap-IF is a benchmark dataset for evaluating instruction-following capabilities in omnimodal video captioning. The dataset aims to advance models in generating useful video descriptions while precisely meeting various user-specified constraints. It includes 480 videos and 1,920 instruction samples, covering understanding, generation, retrieval, and communication-oriented video captioning tasks. Each sample consists of a prompt and a fine-grained evaluation checklist, used to systematically assess the models adherence to instructions in terms of format (e.g., JSON, tables, timestamps) and content (e.g., visual events, audio events, temporal localization, audio-visual causal relationships). The datasets diversity is reflected in video categories, duration, instruction length, number and types of constraints, with its core evaluation focus extending beyond general description quality to emphasize the models compliance with structural, temporal, visual, audio, and audio-visual fusion constraints. The dataset file structure includes annotation files (containing prompts, checklists, and video metadata), raw video files, and lightweight metadata files for easy use with the Hugging Face dataset viewer.
数据集名称:OmniCap-IF
基本信息
- 许可证:CC-BY-NC-SA-4.0
- 语言:英语
- 领域:视频描述(Video Captioning),专注于全模态(Audio-Visual)条件下的指令跟随
- 数据集规模:1,000 < n < 10,000(具体为480个视频,1,920条指令样本)
数据集概述
OmniCap-IF 是一个用于评估全模态视频描述中指令跟随能力的基准数据集。它包含480个视频和1,920条指令样本,涵盖理解、生成、检索和面向通信的描述任务。每个样本将提示与细粒度的格式和内容检查清单配对,用于评估模型是否遵循结构、时间、视觉、音频以及视听结合的约束。
数据集结构
数据集目录结构如下:
annotation/ prompts.json # 仅包含提示的基准样本 checklists.json # 包含评估检查清单的样本 video_meta_info.json # 视频时长、路径和类别元数据 videos/ # 视频文件(001.mp4 至 480.mp4) assets/ # 数据集统计信息图片 metadata.jsonl # Hugging Face 数据集查看器使用的轻量级文件
基准任务特点
- 覆盖多样的视频类别、时长、指令长度、约束数量和约束类型。
- 强调指令跟随行为:模型需在满足显式用户约束(如JSON/表格格式、时间戳、事件定位、源定位、音频可见性、视听因果关系)的同时生成有用的视频描述。
标注格式
每个视频ID对应四个提示级别的样本,示例格式如下: json { "001": [ { "field": "For Understanding", "prompt_id": "01", "generated_prompt": "...", "constraints_used": [ "omni_events_actions", "omni_temporal_grounding", "visual_events_actions", "audio_events_actions", "json_array", "timestamp_format", "case" ] } ] }
在 checklists.json 中,每个提示额外包含一个 checklist 字段:
json
{
"checklist": {
"format_check": [],
"content_check": []
}
}
此检查清单用于计算格式和内容正确性的 CSR 和 ISR 指标。
使用方式
-
下载数据集: bash hf download NJU-LINK/OmniCap-IF --repo-type dataset --local-dir OmniCap-IF
-
运行评估代码:将模型响应置于
response/目录下,每个响应文件映射视频ID到提示级别的输出: json { "001": [ { "prompt_id": "01", "response": "..." } ] } -
执行评估: bash python main.py --meta_dir ./annotation --response_dir ./response --save_dir ./results --api_key YOUR_API_KEY --base_url YOUR_BASE_URL --model_name YOUR_JUDGE_MODEL
引用信息
请引用以下论文: bibtex @article{wang2026omnicapif, title = {OmniCap-IF: Benchmarking and Improving Instruction Following Abilities for Omni-Video Captioning}, author = {Wang, Jiahao and Ping, An and Wang, Yanghai and Zhang, Yuanxing and Li, Shihao and Bian, Hanyan and Ren, Yichi and Zhang, Yize and Wang, Han and Chen, Haowen and Li, Junze and Wang, Jiaqi and Hu, Yiyang and Xu, Zhuze and Zhang, Zijie and Liu, Jiaheng}, journal = {arXiv preprint arXiv:2606.xxxxx}, year = {2026} }
相关链接
- 项目主页:https://nju-link.github.io/OmniCap-IF/
- 论文地址:https://arxiv.org/abs/2606.xxxxx
- GitHub仓库:https://github.com/NJU-LINK/OmniCap-IF
- 训练集:https://huggingface.co/datasets/NJU-LINK/OmniCap-IF-54K