Gelbooru-Tags-Full_2026-06-11
收藏资源简介:
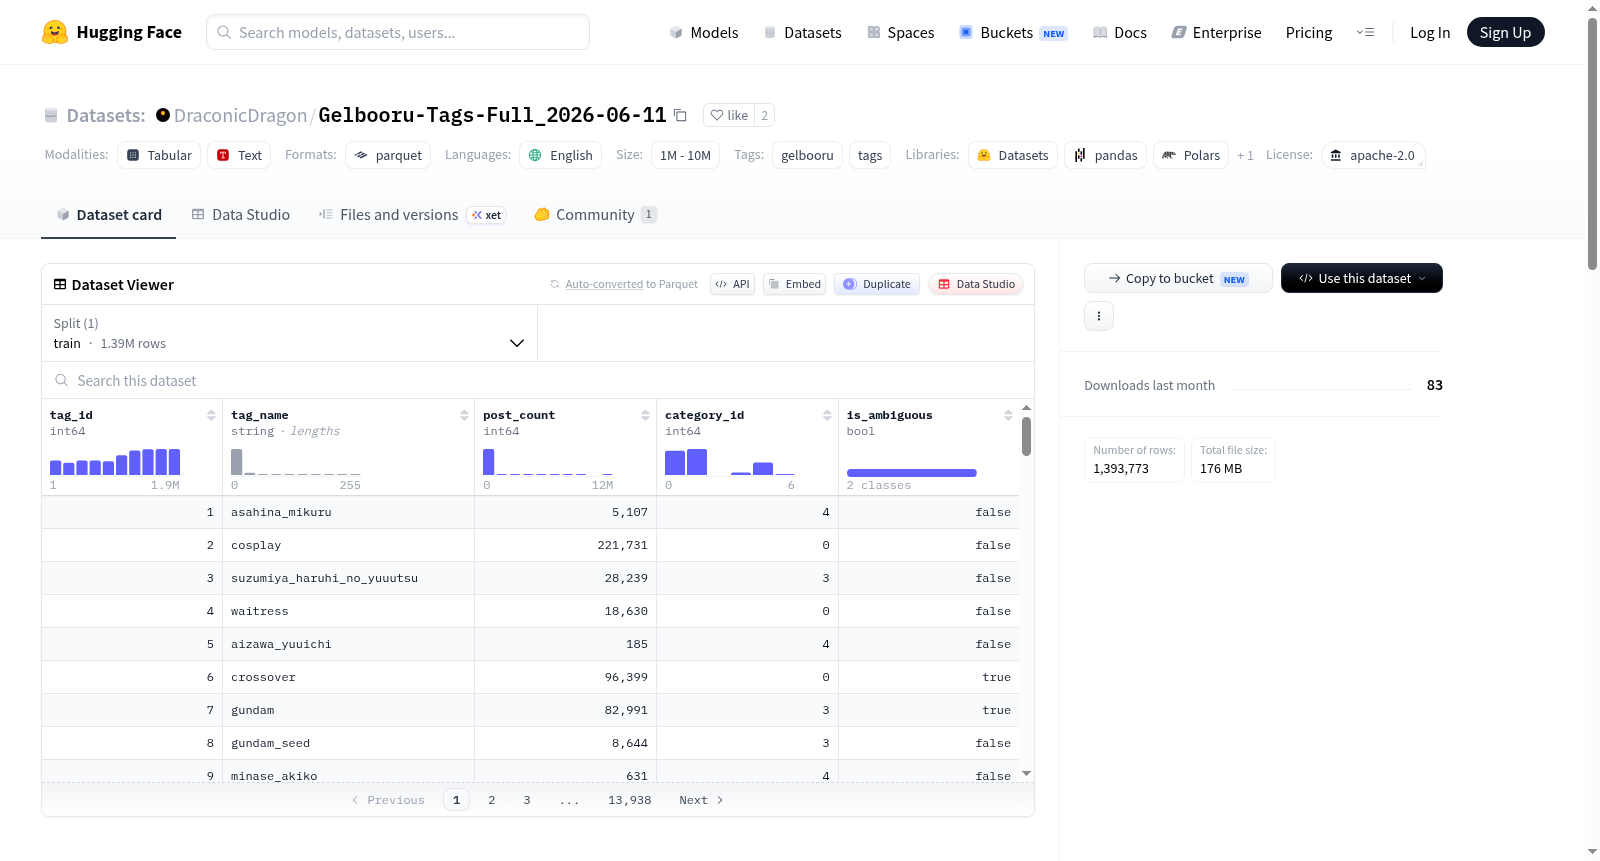
本数据集包含于2026年6月11日从Gelbooru图像分享网站的API获取的完整标签列表,旨在为下游任务(如标签处理、内容分析)提供全面的标签元数据。数据集提供两个格式版本(Parquet和JSONL),内容相同,核心字段包括标签ID、标签名称、关联的帖子数量、类别ID(0至6,分别对应通用、艺术家、无效/未使用、版权、角色、元数据和废弃类别)以及标签是否模糊的标识。数据规模覆盖Gelbooru平台上的所有标签,使用者可能需要进行筛选(例如从类别6的废弃标签开始)。一个显著特点是包含一个应用于绝大多数帖子(仅约160万帖子未使用)的空标签,该标签的帖子数量最高。Parquet文件按标签ID升序排序,推荐用于数据处理;JSONL文件则按帖子数量排序,字段名更接近原始API响应,便于人工查看和兼容性处理。
This dataset contains a complete list of tags obtained from the Gelbooru image sharing websites API on June 11, 2026, aiming to provide comprehensive tag metadata for downstream tasks such as tag processing and content analysis. The dataset includes two format versions (Parquet and JSONL) with identical content, core fields including tag ID, tag name, associated post count, category ID (0 to 6, corresponding to general, artist, invalid/unused, copyright, character, metadata, and deprecated categories), and a flag indicating whether the tag is ambiguous. The data scale covers all tags on the Gelbooru platform, and users may need to perform filtering (e.g., starting from category 6 deprecated tags). A notable feature is the inclusion of an empty tag applied to the vast majority of posts (only about 1.6 million posts not using it), which has the highest post count. The Parquet file is sorted in ascending order by tag ID, recommended for data processing; the JSONL file is sorted by post count, with field names closer to the original API response for easier manual viewing and compatibility handling.
数据集概述
该数据集从 Gelbooru 的 API 获取,收集于 2026年6月11日。数据集包含 Gelbooru 上所有标签的信息,适用于需要完整标签列表的下游任务,但用户可能需要自行进行数据清洗(例如移除类别6的废弃标签)。
数据内容
每条记录包含以下字段:
- Tag ID:标签的唯一标识符。
- Tag Name:标签名称。
- Post Count:使用该标签的帖子数量。
- Category ID:标签类别ID(取值范围0至6),类别名称对照表如下:
| ID | 类别名称 |
|---|---|
| 0 | General |
| 1 | Artist |
| 2 | Invalid / Unused |
| 3 | Copyright |
| 4 | Character |
| 5 | Meta |
| 6 | Deprecated |
- Is Ambiguous:标签是否具有歧义(布尔值)。
文件格式
数据集提供两种格式,数据内容相同:
- Parquet 文件(推荐使用):按标签ID升序排列,可通过 Hugging Face 数据集查看器按不同列排序。
- JSONL 文件:按帖子计数降序排列,更接近 Gelbooru API 原始响应格式(使用换行分隔而非数组)。
两种格式的字段名差异:
| JSONL 字段名 | Parquet 字段名 |
|---|---|
id |
tag_id |
name |
tag_name |
count |
post_count |
type |
category_id |
ambiguous |
is_ambiguous |
注意事项
- 数据集中存在一个空标签/空字符串,几乎应用于所有帖子(仅约160万帖子未包含该标签),因此拥有最高的帖子计数。
- 标签收集耗时约4-5小时,API响应频率在完成50%页面后显著下降。
- 数据获取代码可在 GitHub 查看。
许可协议
数据集采用 Apache 2.0 许可证。