unjudged-law-instructions-dataset
收藏资源简介:
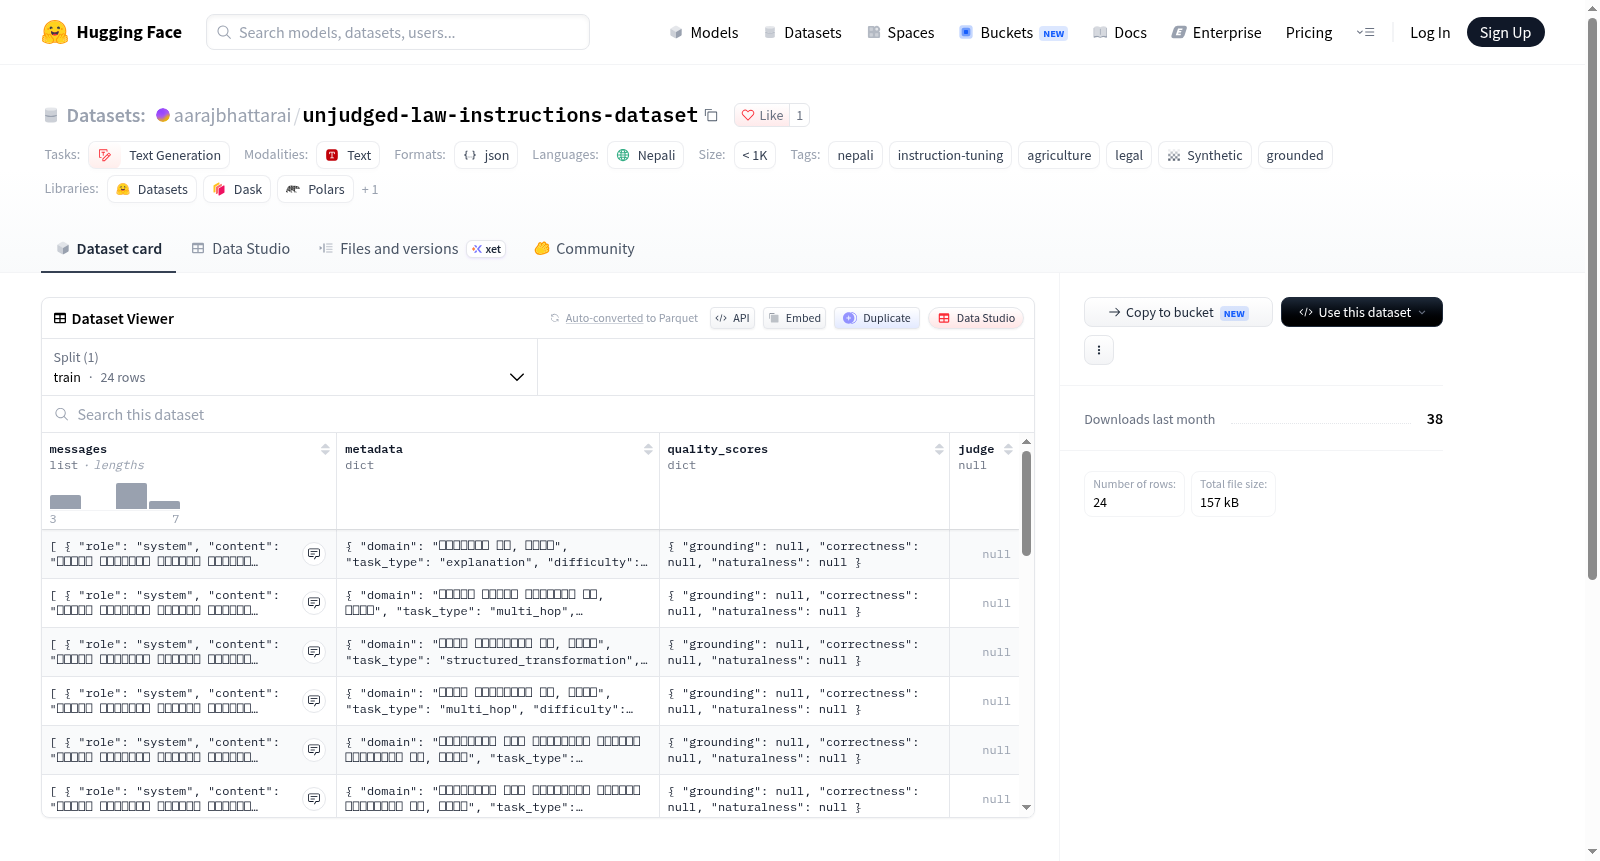
该数据集是一个合成的尼泊尔语指令调优数据集,名为“Nepali Source-Grounded Instruction Dataset — UNJUDGED”。数据由 NVIDIA NeMo Data Designer 从权威尼泊尔文档(包括农业手册和法律文本)自动生成。每条指令的回答严格基于源文档内容,对于无法从给定来源回答的问题,模型会明确拒绝回答。数据记录的格式采用聊天消息结构(messages),并附带元数据(metadata)以及每条记录的质量评分(quality_scores,包含 grounding、correctness、naturalness 三个维度,评分范围为1-5分,由LLM作为裁判给出)。但当前版本所有对话的LLM裁判调用均已失败,因此每条记录的 quality_scores 均为 null。每个源文档对应一个数据分片文件(data/train-<shard>.jsonl),分片在重新运行时会被幂等覆盖。该数据集不推荐直接用于指令调优。数据集的适用任务包括文本生成、指令微调等,特别关注尼泊尔语的农业和法律领域。
This dataset is a synthetic Nepali instruction tuning dataset named Nepali Source-Grounded Instruction Dataset — UNJUDGED. The data is automatically generated by NVIDIA NeMo Data Designer from authoritative Nepali documents, including agricultural manuals and legal texts. Each instructions response is strictly grounded in the source document content, and for questions that cannot be answered from the given source, the model explicitly refuses to answer. The data records are formatted as chat message structures (messages), accompanied by metadata and quality scores (quality_scores, including three dimensions: grounding, correctness, and naturalness, scored from 1 to 5 by an LLM judge). However, in the current version, all LLM judge calls have failed, resulting in null quality_scores for every record. Each source document corresponds to a data shard file (data/train-<shard>.jsonl), and shards are idempotently overwritten on re-run. The dataset is not recommended for direct instruction tuning. Applicable tasks include text generation, instruction fine-tuning, etc., with a particular focus on Nepali agricultural and legal domains.
Nepali Source-Grounded Instruction Dataset — UNJUDGED
数据集基本信息
- 数据集地址:https://huggingface.co/datasets/aarajbhattarai/unjudged-law-instructions-dataset
- 语言:尼泊尔语(ne)
- 任务类别:文本生成(text-generation)
- 标签:nepali、instruction-tuning、agriculture、legal、synthetic、grounded
数据集描述
该数据集为合成的尼泊尔语指令微调数据,由 NVIDIA NeMo Data Designer 基于权威尼泊尔语文档(农业手册、法律文本)生成。
- 答案严格基于源文档内容(grounded)。
- 对于无法回答的问题,会给出明确的拒绝回答(explicit refusal)。
- 每条记录采用聊天
messages格式,并附带metadata以及每条记录的quality_scores(grounding / correctness / naturalness,评分范围 1-5,由 LLM-as-judge 进行评判)。 - 每个源文档对应一个
data/train-<shard>.jsonl文件;分片在重新运行时会被幂等地覆盖。
注意事项
- 该数据集包含 LLM 评判调用失败的生成对话(其
quality_scores为 null)。 - 在任何使用之前需要重新进行评判(re-judge)。
- 请勿按原样用于指令微调(instruction tuning)。