
ranausmans/synthetic-social-networks
收藏官方服务:
资源简介:
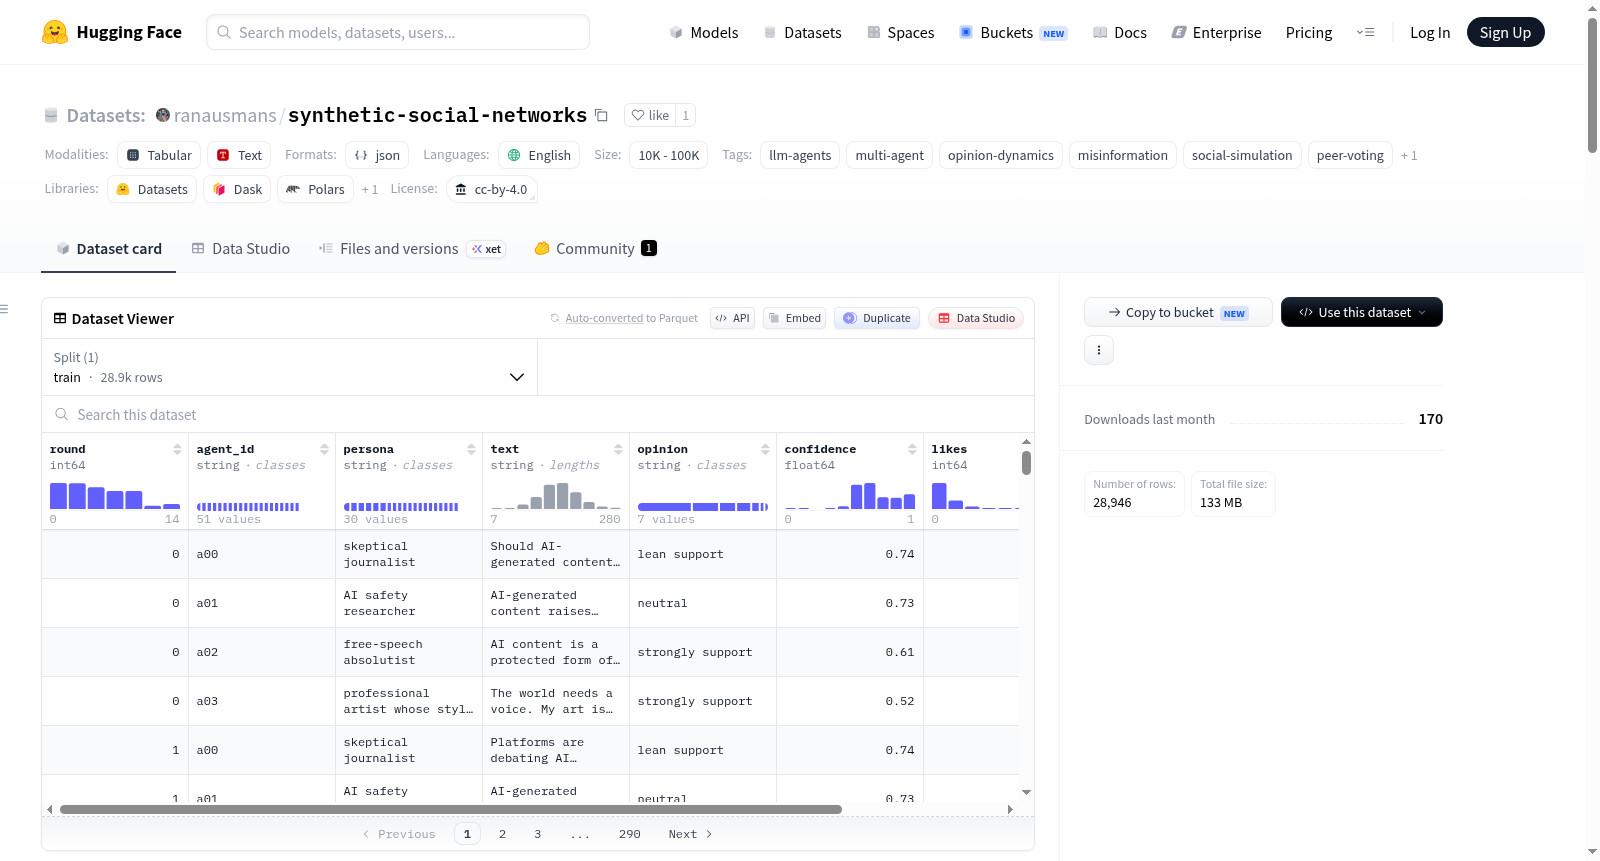
该数据集是Synthetic Social Networks研究的原始实验输出,包含24,160个角色内LLM-agent社交媒体帖子(如果包括管道验证烟雾运行,则总计28,946个帖子)。每个帖子都与其他代理进行角色内投票的同行投票痕迹配对,用于模拟社交网络环境中的多代理互动、意见动态和错误信息传播。数据集覆盖了多个生产实验,涉及协调账户操纵、错误信息级联、社会奖励条件等场景,旨在研究社交平台中常规社会奖励用户体验的影响、协调AI攻击的加剧效应以及单个放大账户的失败情况。
Raw experimental outputs from the Synthetic Social Networks study: 24,160 in-character LLM-agent social-media posts from four production experiments, 28,946 posts total when pipeline-verification smoke runs are included. Each post is paired with peer-vote traces from in-character voting by other agents.
提供机构:
ranausmans搜集汇总
数据集介绍
构建方式
该数据集源自《Synthetic Social Networks》研究项目,旨在通过多智能体大语言模型模拟社交网络中的观点动态与信息传播。数据集共包含28,946条LLM智能体发布的角色扮演社交媒体帖子,其中24,160条来自四次正式实验,其余来自管道验证的预运行。每条帖子均附带其他智能体以角色身份进行的同伴投票记录。实验涵盖六种场景,包括协调账户水军、错误信息级联干预、基线社会奖励条件、从众校准等,每项实验均按不同模型、种子和条件组织为独立目录。数据生成基于Qwen3.5:2b和Llama3.2:3b模型,使用Nomic嵌入文本计算指标,总计消耗约57 GPU小时,调用约58,369次。
特点
数据集的最大特色在于其高度结构化的多维信息记录。每一条帖子都包含轮次、智能体身份、角色人设、文本内容、观点倾向、置信度以及点赞和反对票数,为观点演化与社交影响力的量化分析提供了细致粒度。同伴投票系统不仅记录投票结果,还保留每条投票的角色扮演理由,使得研究者能够解析智能体决策的语义逻辑。此外,数据集中包含丰富的元数据文件,如智能体初始与最终状态、每轮轨迹摘要、收敛性、人设保持率、观点偏移率、置信度变化、语言相似性以及按人设群体分层的结果,为复现论文分析、探索新假设提供了全面的数据支柱。
使用方法
用户可通过HuggingFace的`datasets`库直接加载数据集,使用`load_dataset`函数并设置`streaming=True`以流式方式读取帖子内容,便于快速预览与处理。对于完整的实验目录结构,推荐使用`snapshot_download`函数将数据集下载至本地,随后可直接调用配套GitHub仓库中的分析脚本(如`analyze_astroturf`)复现论文中的实验结果。每个实验目录下还包含了聚合后的CSV文件、自动生成的报告和可视化图表,便于快速理解实验概况。数据集的CC-BY 4.0许可允许商业使用和改编,只需适当引用来源即可。
背景与挑战
背景概述
该数据集由Rana Muhammad Usman于2026年创建,依托大规模多智能体语言模型(LLM)模拟社交网络交互,聚焦信息操作、观点动态与虚假信息传播等前沿课题。研究团队利用Qwen3.5和Llama3.2等模型生成逾2.4万条拟人化社交帖子,并记录智能体间的同行投票行为,旨在量化常规社交奖励机制、协调性账户操控及单一放大账户对舆论场的影响差异。作为计算社会科学与AI安全交叉领域的重要资源,该数据集为理解人机混合社交环境中信息级联的驱动力提供了可复现的实验范式,推动了基于智能体模拟的虚假信息抵御策略研究。
当前挑战
该数据集所解决的领域挑战在于:传统社交网络研究难以在受控条件下分离因果机制,而该数据通过多因素实验设计(如虚假信息干预、奖励条件、账户规模扰动)实现了对意见极化、认知偏差及协调性攻击的量化分析。构建过程中面临的核心挑战包括:确保智能体角色与投票行为的一致性(通过拟人化模板与同行评分约束)、跨实验条件可比较性的维持(统一种子参数与烟测试验证)、以及大规模生成时计算资源的高效分配(58,369次API调用约57 GPU小时)。此外,如何将模拟结论外推至真实社交平台场景仍存方法论争议。
常用场景
经典使用场景
在计算社会科学与多智能体模拟的交汇领域,Synthetic Social Networks 数据集为研究大语言模型驱动的智能体在社交平台上的行为动态提供了标准化实验场。其最经典的使用场景是模拟多智能体在舆论演化中的互动过程,尤其聚焦于协调性账号水军(astroturfing)与信息级联(misinformation cascade)等当代社交网络核心病象。研究者可通过载入完整实验日志,包括每轮帖文、投票轨迹及智能体状态变化,复现不同干预策略下舆论极化的生成机制。该数据集因其精细化的实验设计——涵盖五种社会奖励条件、四种干预策略以及多重放大系数——成为检验智能体社会影响力理论假说的黄金基准。
衍生相关工作
围绕该数据集已衍生出一系列推动计算社会科学方法论边界的经典工作。原始研究提出的多因素实验设计范式——同时操控水军账户数量、信息级联干预策略与社会奖励条件——为后续分析提供了包含114个独立实验单元的高维因果推断框架。配套发布的预注册分析计划、自动生成报告脚本与可视化图表流水线,树立了从仿真数据到论文成果的端到端可重复性工作流样板,直接启发了PoliticalAI等诸多研究团队构建类似的LLM智能体社会模拟平台。数据集中的同伴投票机制——让每个智能体为他人帖文填写投注理由的-1/0/+1评分——开创了计算政治学中同时捕获行为选择与认知归因的新范式,后续工作已将此拓展为包含立场跃迁路径追踪的多智能体舆论动力学模型。嵌入向量层面的人设保持度与语言相似度指标,则催生了新型LLM人格一致性评测工具,被应用于评估对话系统在长期交互中的身份漂移现象。
数据集最近研究
最新研究方向
该数据集聚焦于利用大语言模型驱动多智能体模拟真实社交网络中的信息传播与意见动态,尤其关注水军操弄、错误信息级联及社交奖励机制对平台舆论生态的影响。通过设计‘同辈投票’机制让LLM智能体模拟用户互动,研究者得以在可控实验中复现并分析诸如协调账户泡网攻击、单一影响力放大等前沿热点现象。这一方向将LLM-agent仿真从静态文本生成推向动态群体行为建模,为理解网络虚假信息治理、平台算法干预效果提供了可量化的实验范式。数据集的公开释放也为跨学科验证社交网络理论、开发基于仿真预训练的舆论演化预测模型奠定了基准资源。
以上内容由遇见数据集搜集并总结生成


