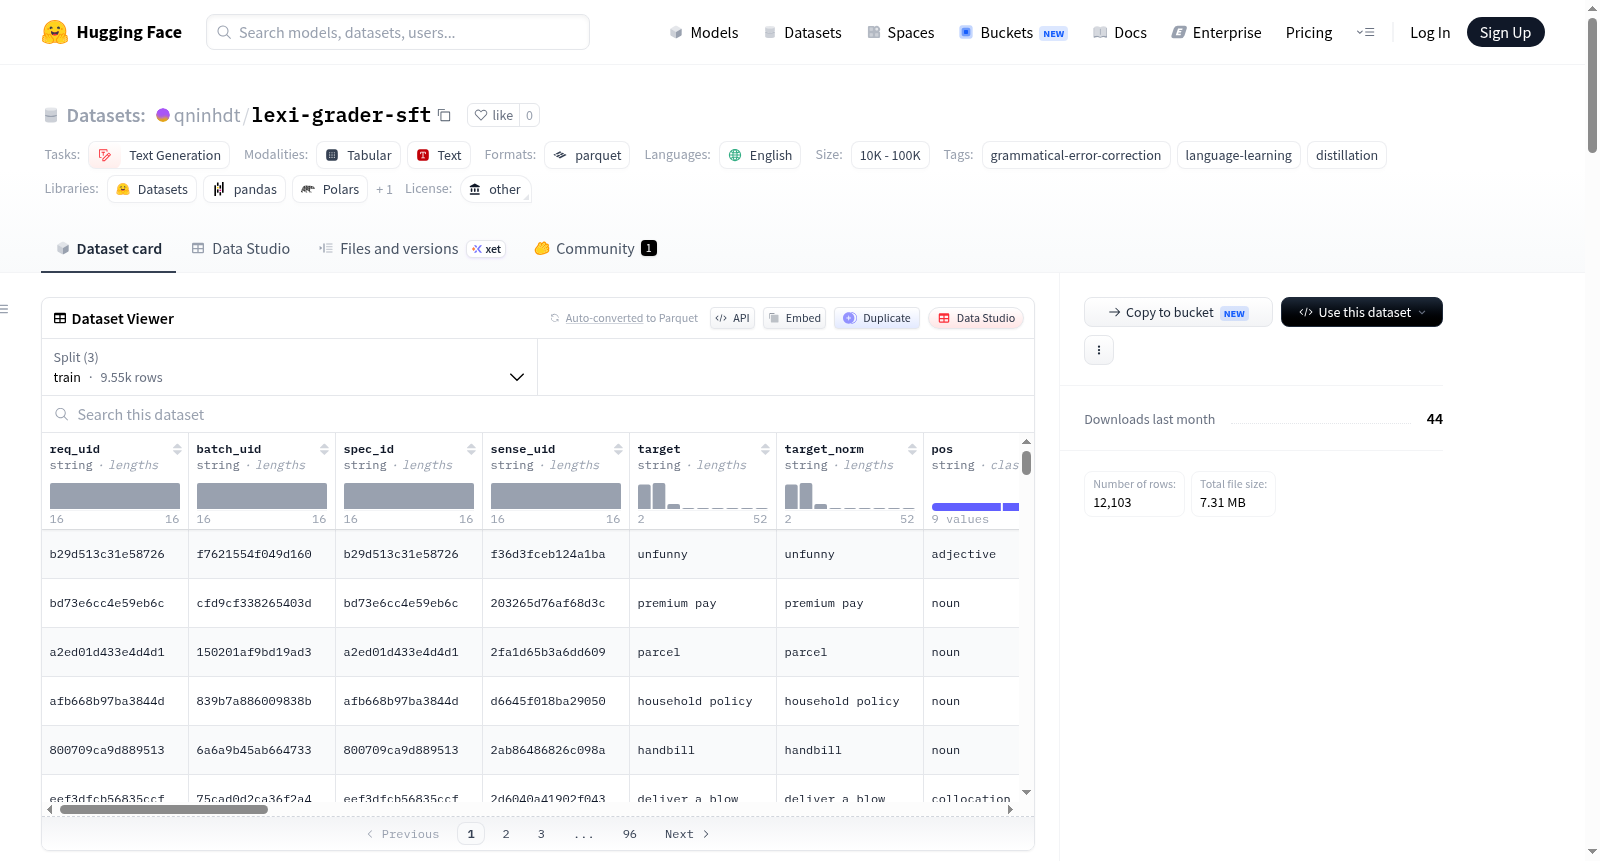
lexi-grader-sft
收藏资源简介:
该数据集名为 qninhdt/lexi-grader-sft,由教师模型生成的句子评分训练数据组成。数据集的目标是训练一个句子评分器:给定一个学习者的英语句子和一个目标词的特定词典义项,模型应生成内联纠错、一个意义等级(0-4)以及一行反馈。数据构建分为两步:首先,Diversifier 根据学习者的背景、目标等级和错误配方等规范生成类似于学习者风格的句子;然后,Grader 只看到{目标词、义项、文本}并输出答案。数据集包含 12454 个生成的学习者句子,其中 12103 个被接受的评分,覆盖 2000 个不同的词典义项。数据分为训练集(9545 行)、验证集(1251 行)和测试集(1307 行),按目标词分组,不同划分之间没有重叠句子。每个样本包含三个字段:correction(内联纠错,使用标记语法如 [speak>speaks:agr] 表示替换,[the>:art] 表示删除,[>to the:art] 表示插入)、meaning(0-4 的整数等级,含义分别为 0: 16.7%, 1: 21.6%, 2: 1.1%, 3: 18.8%, 4: 41.9%)、feedback(一行文本反馈)。错误标签分布包括 art、prep、agr、tense、word、form、num、order、unnat、coll、pron、poss、sp、punc、part、other 等。注意事项:数据没有人工黄金集,所有标签都是教师模型的观点;句子是模型模仿学习者错误生成的,并非真实学习者数据;等级未校准(band_config.json 中 calibrated 为 false);反馈未评估;语法和自然度等级基于纠错标签的公式计算,但未校准。数据集许可证为 other,适用于文本生成任务,语言为英语。
This dataset is named qninhdt/lexi-grader-sft, consisting of sentence scoring training data generated by a teacher model. The goal of the dataset is to train a sentence scorer: given a learners English sentence and a specific dictionary sense of a target word, the model should generate inline corrections, a meaning level (0-4), and a line of feedback. The data construction is divided into two steps: first, the Diversifier generates sentences similar to the learners style based on specifications such as the learners background, target level, and error recipe; then, the Grader only sees {target word, sense, text} and outputs the answer. The dataset contains 12,454 generated learner sentences, of which 12,103 are accepted scores, covering 2,000 different dictionary senses. The data is split into training set (9,545 rows), validation set (1,251 rows), and test set (1,307 rows), grouped by target word, with no overlapping sentences between splits. Each sample includes three fields: correction (inline corrections using markup syntax such as [speak>speaks:agr] for replacement, [the>:art] for deletion, [>to the:art] for insertion), meaning (integer level 0-4, with percentages: 0: 16.7%, 1: 21.6%, 2: 1.1%, 3: 18.8%, 4: 41.9%), and feedback (a line of text feedback). Error tag distribution includes art, prep, agr, tense, word, form, num, order, unnat, coll, pron, poss, sp, punc, part, other, etc. Notes: The data has no human gold standard; all labels are the teacher models perspective; the sentences are generated by the model imitating learner errors, not real learner data; the levels are not calibrated (band_config.json shows calibrated as false); feedback is not evaluated; grammar and naturalness levels are computed based on a formula of error tags but are not calibrated. The dataset license is other, suitable for text generation tasks, and the language is English.
数据集概述:qninhdt/lexi-grader-sft
基本信息
- 任务类型:文本生成(text-generation)
- 语言:英语
- 标签:语法错误纠正、语言学习、知识蒸馏
- 许可证:其他(other)
- 数据规模:1K-10K 样本
数据集内容
该数据集用于训练句子评分器:给定学习者的英语句子和一个目标词的具体词典义项,生成:
- 行内纠错(inline correction)
- 含义等级(meaning band,0-4)
- 一条反馈(feedback)
包含:
- 12,454 条生成的学习者句子(
raw/raw_texts.parquet) - 12,103 条被接受的评分结果(
raw/raw_labels.parquet) - 2,000 个不同的词典义项
数据划分
| 划分 | 行数 |
|---|---|
| train | 9,545 |
| val | 1,251 |
| test | 1,307 |
按目标词分组,不同划分间无句子重叠,验证阶段未拒绝任何样本。
数据格式
纠错使用标签语法,例如: json { "correction": "He [speak>speaks:agr] very [eloquent>eloquently:form].", "meaning": 3, "feedback": "Right sense, but the verb needs to agree with the subject." }
纠错操作包括:
- 替换:
[A>B:tag] - 删除:
[A>:tag] - 插入:
[>B:tag]
干净句子原样输出;不可读句子返回 correction: null。grammar 和 naturalness 根据纠错标签计算,而非模型生成。
构建方法
采用两步式流程:
- 多样化器:根据规范生成学习者风格文本
- 评分器:仅基于
{target, sense, text}生成答案
关键参数:
- 教师模型:
zm1/zyloo/gemini-3.1-pro-preview(通过端点报告,未独立验证) - 端点:
https://api.vilao.ai/v1 - 格式有效性:0.9475
- 批量多样性 (distinct-2):0.9367
数据分布
含义等级分布
| meaning | 行数 | 占比 |
|---|---|---|
| 0 | 2,017 | 16.7% |
| 1 | 2,611 | 21.6% |
| 2 | 128 | 1.1% |
| 3 | 2,281 | 18.8% |
| 4 | 5,066 | 41.9% |
中段等级(1-3)占总行数的 42.69%。
错误标签分布
常见标签包括:art (4,317)、prep (3,018)、agr (2,202)、tense (2,110)、word (2,055)、form (1,905)、num (1,800)、order (1,355),以及其他15个标签。
质量限制
- 无人工金标准:所有标签均来自教师模型输出
- 真实学习者分布未验证:句子为模型模拟的学习者错误
- 等级未校准:
band_config.json中"calibrated": false - 反馈质量未评估:无相关指标
- grammar 和 naturalness 未校准:基于设计猜测,非语料库惩罚分布;由于81%行无 usage 错误,校准产生重复切点
未包含内容
W&I+LOCNESS 转换的 A 阶段纠错格式数据不包含在此数据集中,因其许可证禁止向第三方再分发。