
tech-skills-br
收藏官方服务:
资源简介:
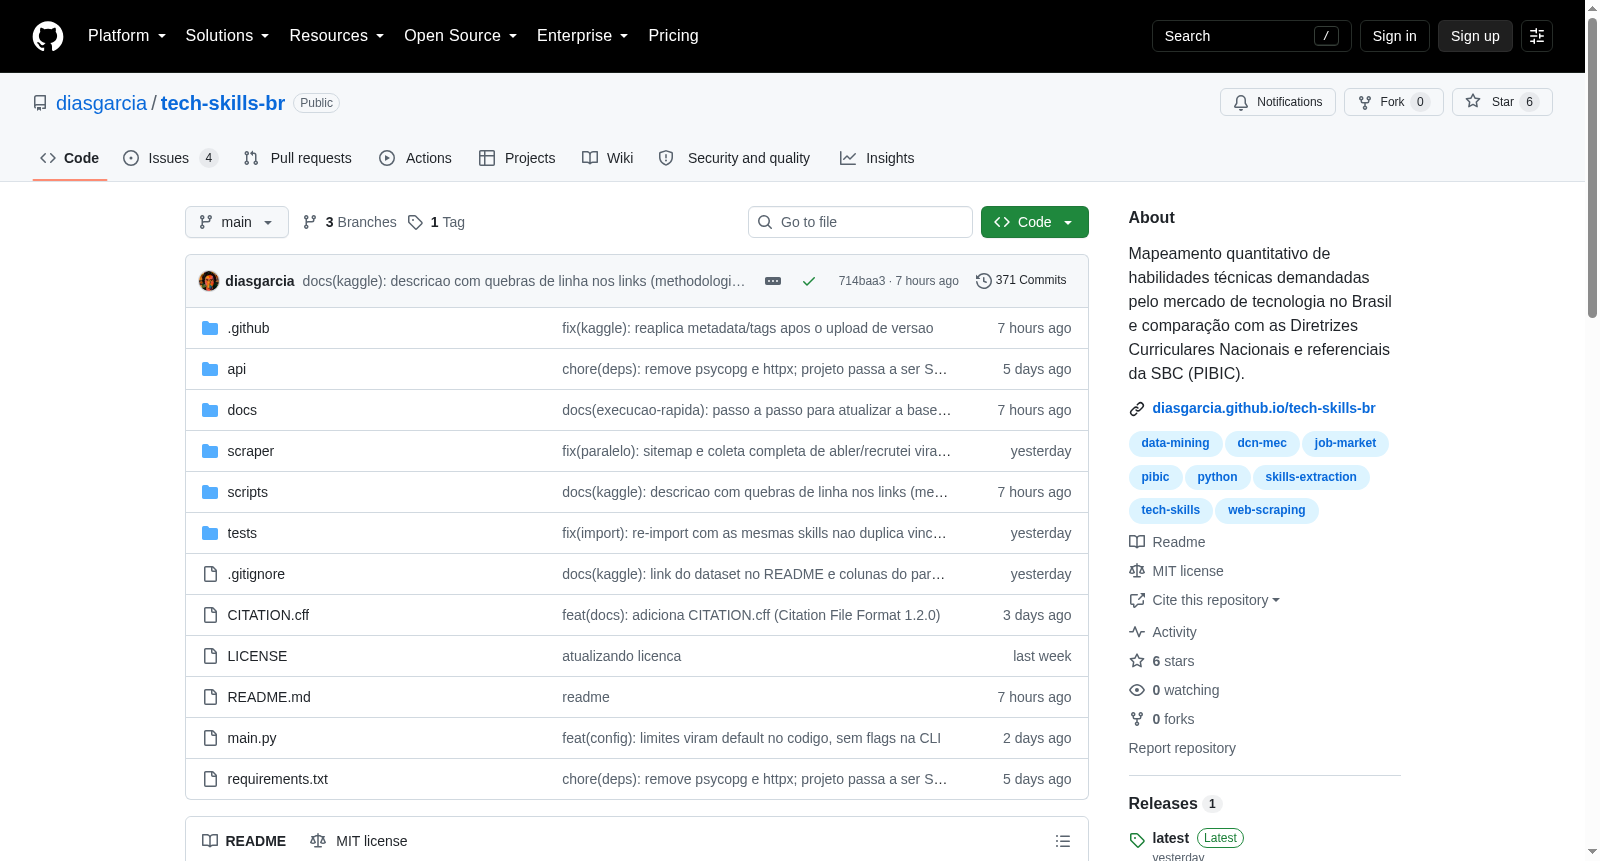
一个收集和提取巴西技术市场所需技术技能的数据集,用于与国家课程指南和SBC参考进行比较分析。
This dataset collects and extracts technical skills required by the Brazilian technology market, and is intended for comparative analysis against national curriculum guidelines and SBC references.
创建时间:
2026-08-22
原始信息汇总
数据集概述
该数据集来源于一项名为“Mapeamento de Skills em Tecnologia no Brasil (PIBIC)”的科学研究项目,旨在收集并提取巴西科技市场所需的技术技能,以便后续与巴西教育部(MEC)的国家课程指导方针以及巴西计算机学会(SBC)的参考框架进行对比分析。
核心信息
- 研究背景:这是PIBIC(科学启动计划)框架下的科研项目,侧重实证与可复现的数据分析。
- 研究问题:探究MEC课程指导方针和SBC参考框架在多大程度上使计算机专业的毕业生能够满足巴西劳动力市场对技术和技能的需求。
- 数据内容:涵盖巴西科技招聘市场中的技能、技术、领域等数据。
技术与工具
| 项目 | 描述 |
|---|---|
| 编程语言 | Python 3.12 或更高版本 |
| 数据库 | SQLite(使用SQLAlchemy 2.0作为ORM) |
| 持续集成 | 通过GitHub Actions实现 |
| 文档 | 详细文档托管在项目的Wiki中,内容包括使用手册、系统架构、数据管道、数据模型、分类方法以及自动化流程。 |
数据获取方式
-
GitHub Pages公开API与面板
- 项目在GitHub Pages上发布了一个极简网页面板和静态JSON API(已启用CORS)。
- 基础URL:
https://diasgarcia.github.io/tech-skills-br/ - 可用的API端点包括:
/api/resumo.json/api/areas.json/api/tecnologias.json/api/vagas.json
-
Kaggle数据集
- 数据也发布在Kaggle平台,提供每日生成的Parquet格式快照。
- 访问地址:
https://www.kaggle.com/datasets/rafaeldiasgarcia/tech-skills-br
数据处理流程
项目运行一个多源数据采集管道,其核心步骤包括:
- 多来源数据抓取。
- 基于经整理的分类法(taxonomy)进行技术提取。
- 进行去重处理。
- 执行统计分析。
访问与运行
为便于快速上手,用户可参考项目中的快速开始文档(文件路径:docs/execucao-rapida.md),其中列出了所有必要指令。
搜集汇总
数据集介绍
构建方式
该数据集依托于巴西国家科学与技术发展委员会资助的PIBIC科研项目,旨在系统性地采集巴西科技市场所需的技术技能。其构建过程采用多源数据收集管道,涵盖职位发布、行业报告等,并依据精心整理的分类学对技术术语进行标准化提取与去重处理,辅以SQLite数据库进行数据存储与管理,最终实现数据的结构化整合。
特点
该数据集的核心特色在于其严谨的科研导向与跨领域比较价值。它不仅仅是技能列表,更是将市场技能需求与巴西教育部国家课程指南及巴西计算机学会参考框架相对照的桥梁。此外,项目提供了可视化仪表盘和具备CORS支持的静态JSON API,并每日在Kaggle平台发布Parquet格式快照,确保了数据的可访问性、时效性与可复现性。
使用方法
数据使用者可直接访问GitHub Pages提供的公共API端点获取核心摘要、领域分类、技能清单及职位数据,便于快速集成应用;亦可利用Kaggle平台下载历史快照进行深度离线分析。对于希望复现研究流程的学者,项目维护了详尽的Wiki文档,涵盖架构、管道及数据模型说明,支持按步骤执行整个数据采集与处理流程。
背景与挑战
背景概述
随着信息技术的迅猛发展,巴西科技人才市场对技能的需求日益变化,对应届毕业生的职业准备提出了严峻考验。在此背景下,巴西国家科学与发展委员会(CNPq)资助的PIBIC项目“tech-skills-br”由研究人员Rafael Dias Garcia主导,旨在通过系统化的数据采集与分析,量化评估巴西高等教育机构(遵循MEC国家课程指南及巴西计算机学会(SBC)参考标准)所培养的计算机专业毕业生的技能与市场需求之间的匹配度。该项目自2023年启动,构建了一套多源数据采集流水线,整合SQLite数据库与Kagle公开数据集,并利用GitHub Pages提供静态API,实现了对科技职位技能标签的持续提取与监测。该数据集不仅为巴西高等教育政策制定者提供了实证依据,也为同类发展中国家探索教育与就业市场衔接提供了方法论参考,具有重要的社会影响力和学术价值。
当前挑战
该数据集在核心研究问题上面临重大挑战:如何高信度地实时映射巴西科技岗位的技能需求图谱,并与国家课程指南及SBC参考框架进行动态比对,以揭示教育与产业间的鸿沟。在数据构建过程中,首要挑战是多源异构数据的采集与规范化,需应对不同招聘平台的格式差异、数据噪声及时效性问题。其次,技能提取依赖于人工策划的术语表,需持续维护以覆盖新兴技术,同时避免同义技术(如“Java”与“Java语言”)的重复统计,这要求复杂的数据去重算法。第三,隐私与版权条款限制了程序化爬取,需在合规前提下设计高效的请求频率和反爬策略。此外,数据标注工作庞大,自动化分类的准确性需定期人工校验,以确保统计推断的可复现性和可靠性。
常用场景
经典使用场景
该数据集聚焦于巴西科技行业对技术技能的动态需求,为研究者提供了一个结构化的多源实时语料库。其经典使用场景在于运用爬虫与自然语言处理技术,从招聘公告、职业平台等渠道系统性地采集岗位信息,并通过预设的技能分类体系进行标注与去重,进而量化分析不同技术栈、行业领域及地域对人才技能的具体诉求。研究者可借此开展劳动力市场的技能供需匹配度评估,追踪新兴技术的渗透趋势,或构建技能演化图谱,为教育课程调整与人才战略制定提供实证基础。
实际应用
在实际应用中,该数据集具有广泛的决策支持价值。对于高等教育机构,其可为计算机及相关专业的课程体系改革提供前瞻性指引,辅助识别教学大纲中的冗余或缺失模块;对于职业培训机构,该数据有助于设计高匹配度的技能进阶路线;而企业人力资源部门则能借此优化职位描述与候选人评估模型,提升招聘效率。此外,公共政策制定者可通过持续监控技能演进,制定更加精准的科技人才培养与引进政策,从而增强国家在数字经济时代的竞争力。
衍生相关工作
围绕这一数据资产,一系列衍生研究与实践得以展开。一方面,研究者利用其时间序列快照构建技能需求预测模型,或将技能共现网络应用于职业路径推荐系统的开发;另一方面,数据集也为教育数据挖掘领域提供了基准测试语料,用于比较不同机器学习算法在岗位技能分类任务上的效能。同时,该项目所设计的开源采集与分析管道本身亦成为方法学贡献,激励了更多面向区域劳动力市场的类似数据基础设施构建,形成了以开放数据驱动教育—产业联动的良性学术生态。
以上内容由遇见数据集搜集并总结生成


