
LeeTrent/items_prompts_full
收藏官方服务:
资源简介:
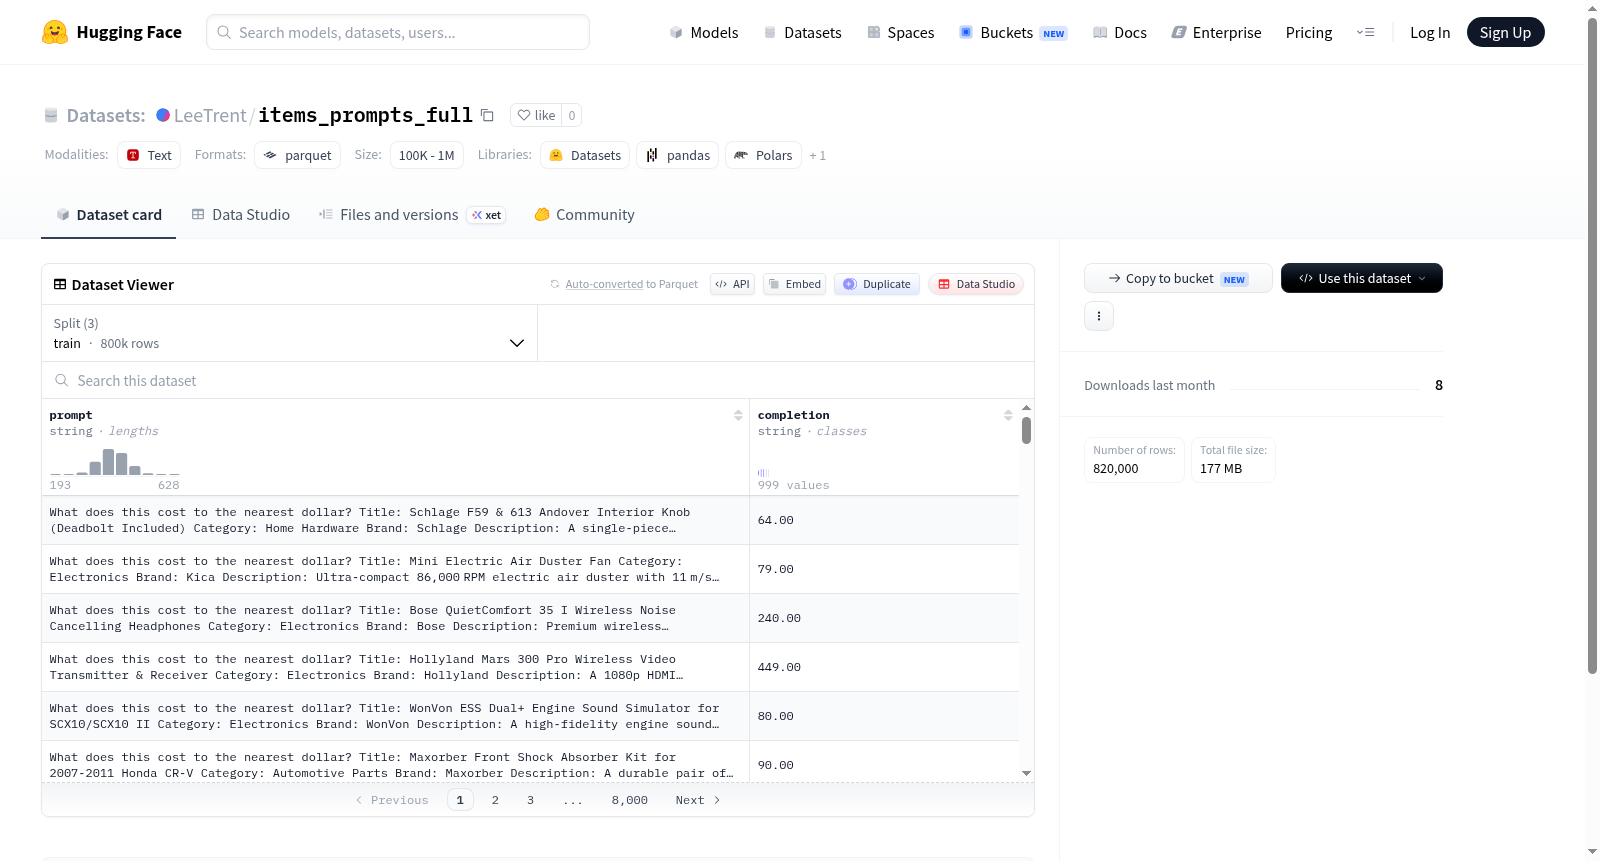
该数据集由800000条训练样本、10000条验证样本和10000条测试样本组成,每个样本包含一个提示字段(prompt)和一个完成字段(completion),总数据量约为351MB。提示字段可能代表用户输入或指令,完成字段代表预期的模型输出或回答,常用于训练语言模型进行指令遵循或文本生成任务。
The dataset consists of 800,000 training samples, 10,000 validation samples, and 10,000 test samples. Each sample contains a prompt field and a completion field, with a total dataset size of approximately 351MB. The prompt field likely represents user input or instructions, while the completion field represents the expected model output or response, commonly used for training language models in instruction following or text generation tasks.
提供机构:
LeeTrent搜集汇总
数据集介绍
构建方式
items_prompts_full数据集以文本对形式构建,每条样本包含一个提示(prompt)和对应的补全(completion)字符串。数据集被划分为训练集(80万条)、验证集(1万条)和测试集(1万条),分别存储于独立的文件中,便于训练、调优与评估流程的分离。数据以分片形式组织,支持高效加载。
特点
该数据集规模庞大,总计约82万条文本对,总大小超过350MB,覆盖丰富的自然语言指令与响应场景。双字段结构(prompt与completion)使其天然适配生成式模型的微调与评估任务。分片存储设计降低了内存占用,便于分布式处理。
使用方法
用户可通过HuggingFace Datasets库加载数据集,指定配置名称为default,并选择所需的划分(train、val或test)。例如,使用load_dataset函数读取数据,即可获得包含prompt和completion字段的样本。该格式可直接用于训练序列到序列模型或进行文本生成任务的测试。
背景与挑战
背景概述
在自然语言处理与生成式人工智能迅猛发展的背景下,指令微调数据集成为提升语言模型遵循人类意图能力的关键资源。items_prompts_full数据集于近期构建,由相关研究团队开发,包含80万条训练样本、1万条验证样本及1万条测试样本,每条数据由提示(prompt)与对应完成(completion)组成,专注于指令遵循任务的监督微调。该数据集旨在弥补通用语料在具体指令执行上的不足,通过大规模、高质量的提示-完成配对,推动模型在对话、任务解析及内容生成等场景的精准对齐,对提升大语言模型的实用性与可控性具有重要影响力。
当前挑战
该数据集面临的核心挑战包括领域问题与构建难点两方面。在领域层面,尽管指令微调提升了模型表现,但如何确保提示涵盖多样化真实场景、避免过拟合于有限指令模式,仍是亟待解决的问题,且数据集中隐含的偏差可能影响模型公平性。构建过程中,挑战在于收集与筛选大量自然、逼真的提示-完成对,需平衡数据规模与质量控制,同时处理长尾指令覆盖不足、完成文本的语义一致性及噪声过滤等难题,这对团队的数据工程能力提出了严苛要求。
常用场景
经典使用场景
在自然语言处理与指令微调的交汇领域,items_prompts_full数据集凭借其精心设计的提示-完成对应结构,成为训练大型语言模型执行多样化指令任务的基石。该数据集汇聚了八十万条训练样本及各一万条的验证与测试样本,覆盖了从简单问答到复杂推理的广泛场景,为模型提供了丰富的指令遵循学习素材。研究者常利用此数据集进行监督式微调,使预训练语言模型能够更好地理解人类意图,并生成符合上下文的精准回复,从而提升模型在对话系统、文本生成等核心任务上的泛化能力。
衍生相关工作
围绕items_prompts_full数据集,学术界涌现出一系列创新性工作。部分研究者以此为基础,探索了数据增强与课程学习策略,旨在通过动态调整提示难度来优化微调过程的收敛速度与性能上限。另一些工作则聚焦于指令冲突与歧义消解,构建了多轮对话中的动态指令理解框架。此外,该数据集还启发了针对低资源语言的指令对齐研究,通过迁移学习方法将高效指令遵循能力从资源丰富语言推广至小语种,从而拓展了多语言智能系统的应用边界,成为连接理论与实践的桥梁。
数据集最近研究
最新研究方向
该数据集聚焦于指令微调与文本生成任务的联合优化,通过大规模提示-补全对(80万训练样本)为语言模型的强化学习与少样本对齐提供数据支撑。当前前沿方向涵盖基于人类反馈的强化学习(RLHF)与特定领域指令遵循能力的泛化性研究,例如在对话系统与代码生成等场景中,利用此数据集探索模型对复杂指令的语义解析与因果推理能力。其庞大的样本规模与标准化分割(训练/验证/测试)使其成为评估模型在非平衡分布下的鲁棒性的重要基准,尤其推动了低资源语言与多任务学习中的提示工程进展。
以上内容由遇见数据集搜集并总结生成


