
ai4collaboration/MaCroScope-Biology-Chemistry-23k
收藏官方服务:
资源简介:
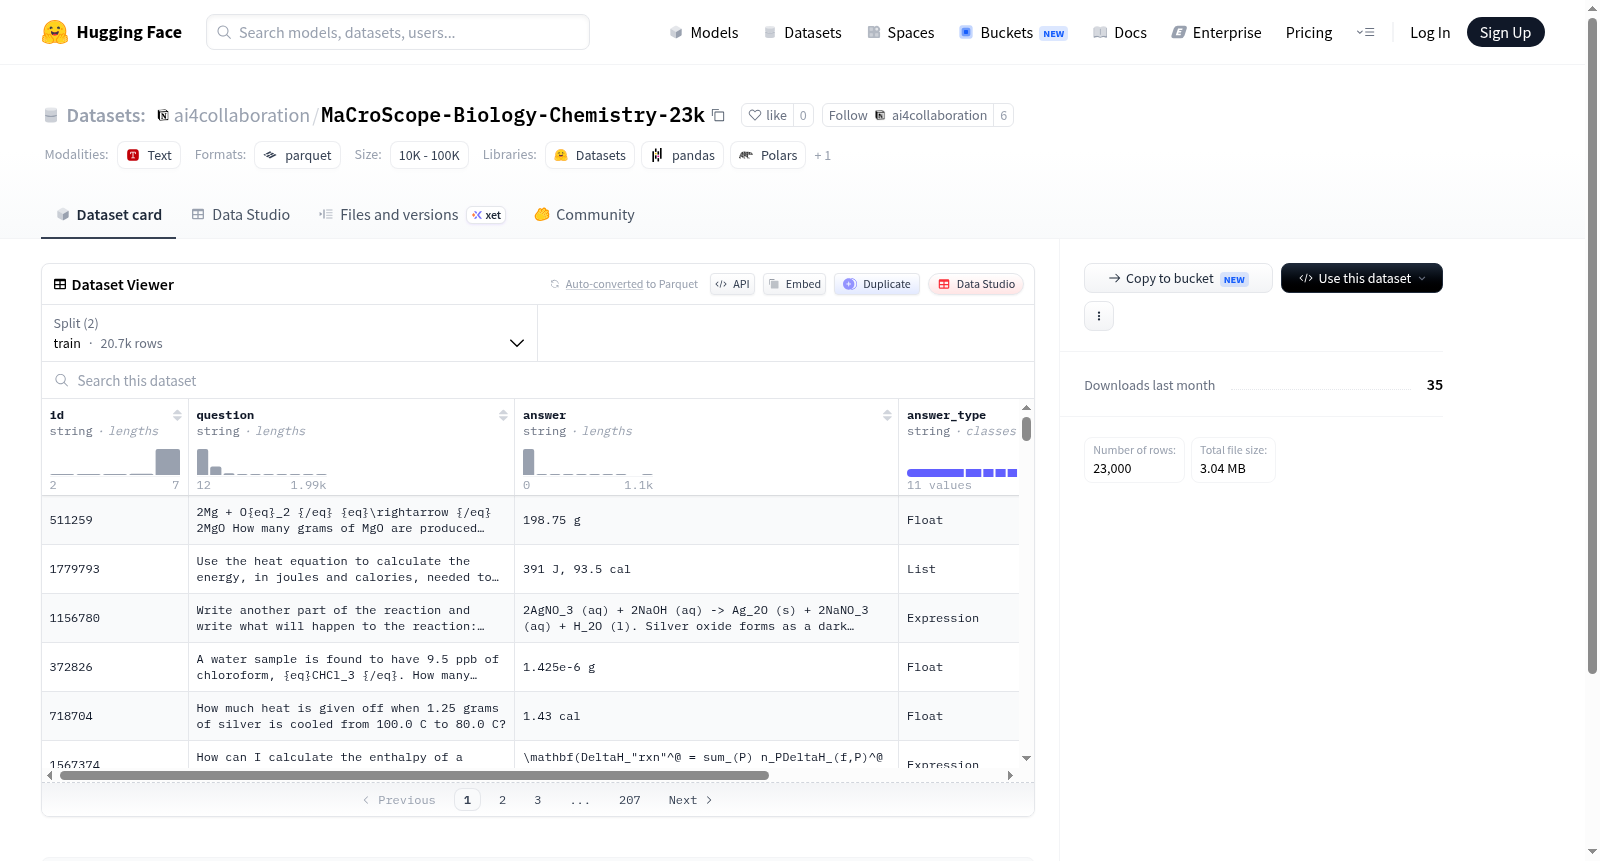
这是一个问答数据集,包含id、问题、答案、答案类型、类别和难度等字段,用于训练和测试,具体应用场景和背景信息未在README中说明。
This is a question-answering dataset with fields including id, question, answer, answer_type, category, and difficulty, intended for training and testing, but specific application context and background information are not described in the README.
提供机构:
ai4collaboration搜集汇总
数据集介绍
构建方式
MaCroScope-Biology-Chemistry-23k数据集专为生物学与化学交叉领域的科学问答而设计,其构建过程严谨而系统。数据来源于权威科学文献、教科书及专业数据库,经过专家团队精心筛选与标注,形成了涵盖分子生物学、生物化学、有机化学等多学科知识的问答对。每条数据包含唯一标识、问题、答案、答案类型、学科类别及难度等级六个字段,其中答案类型可支持事实性、解释性或计算性等不同回答形式。数据集按照9:1的比例划分为训练集(20700条)与测试集(2300条),确保了模型训练与评估的充分性与可靠性。
使用方法
MaCroScope-Biology-Chemistry-23k可直接通过Hugging Face Datasets库加载,默认配置下训练集与测试集分别对应data/train-*和data/test-*路径下的文件。使用者可根据研究需求,将数据组织为问答格式用于语言模型的微调或零样本评估。例如,可将问题字段作为输入,答案字段作为目标输出,构建监督学习任务;也可直接对模型生成答案与真实答案进行语义相似度或准确率比较。推荐使用7B以上参数的预训练模型在此数据集上测试,以充分评估模型在专业科学知识问答上的表现。数据集支持多轮实验,其结构化字段(如难度、类别)便于进行细粒度的性能分析与消融研究。
背景与挑战
背景概述
MaCroScope-Biology-Chemistry-23k数据集诞生于生物与化学交叉领域对大规模、高质量问答数据日益迫切的需求之际。该数据集由相关研究机构构建,旨在整合生物学与化学领域的复杂知识与推理任务,为模型在多学科融合场景下的科学问答能力提供基准。其核心研究问题聚焦于如何使语言模型准确理解并回答涉及分子结构、化学反应机理、生物通路等专业内容。自发布以来,该数据集通过提供经过精细标注的2.3万样本(涵盖训练集与测试集),显著推动了科学领域语言模型评估与训练的发展,成为检验模型在窄域知识掌握与多步推理能力的重要资源。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性上:生物学与化学的交叉问题常涉及长程依赖的因果推理(如代谢通路中的酶促反应级联)、专业符号的语义解析(如分子式与反应条件),以及多模态知识的隐含整合,远超传统问答任务的难度。在构建过程中,挑战同样严峻:专家需要从海量文献中提取并人工校验问答对,确保事实准确性并避免知识过时;同时,对问题难度进行分级时需兼顾科学严谨性与评测一致性,且训练集与测试集的比例与内容分布需精心设计,以防止数据泄露与模型过拟合。
常用场景
经典使用场景
在生物与化学交叉研究领域,MaCroScope-Biology-Chemistry-23k数据集常被用于训练和评估大规模语言模型在科学问答任务上的表现。该数据集包含约2.3万条精心构建的问答对,覆盖从分子生物学到有机化学的广泛主题,尤其擅长处理需要多步推理和领域术语理解的问题。研究者通常利用其训练集对模型进行领域适应微调,再通过测试集检验模型在生物化学知识问答、概念解释及实验方案设计等任务上的泛化能力,成为衡量科学大模型专业素养的标杆之一。
解决学术问题
该数据集精准解决了学术界长期困扰的跨学科知识问答基准缺失问题。传统数据集往往局限于单一学科,难以评估模型对生物与化学交叉领域复杂问题的理解力。MaCroScope-Biology-Chemistry-23k通过融合两大核心自然科学的核心概念与推导逻辑,为模型在分子机制解析、化学反应路径预测、生物活性物质设计等前沿课题上的表现提供了标准化评估框架。其引入的难度分级和答案类型标签,更推动了可解释性推理与证据链溯源研究的发展。
实际应用
在实际应用场景中,该数据集驱动的模型能够直接辅助科研人员与工业从业者。例如,在药物研发环节,模型可基于数据集习得的化学反应与生物靶标知识,快速回答关于合成路径合理性、官能团相容性等问题,显著加速先导化合物优化流程。在实验室自动化与智能教育场景中,该系统能实时解答学生或技术员关于实验原理、安全规范及异常结果分析的疑问,降低人为错误风险,提升跨学科协作效率。
数据集最近研究
最新研究方向
在当前生命科学与化学交叉领域,大规模高质量问答数据集的需求与日俱增,MaCroScope-Biology-Chemistry-23k应运而生,其以23,000条涵盖从基础分子机制到复杂有机反应的多维度问答实例,为生物化学方向的大型语言模型微调与评测提供了坚实的数据基石。该数据集细分为训练集和测试集,并通过难度与类别标签支持精细化评估,正被前沿研究用于探索模型在跨学科知识融合与推理能力上的表现,尤其在药物发现、酶工程及代谢通路解析等热点议题中展现出驱动智能化知识问答系统迈向更精确、更可靠层次的潜力,其意义在于填补了该垂直领域标准化基准的空白,并为未来AI辅助科研决策的落地推广奠定了重要基础。
以上内容由遇见数据集搜集并总结生成


