
eurhope
收藏官方服务:
资源简介:
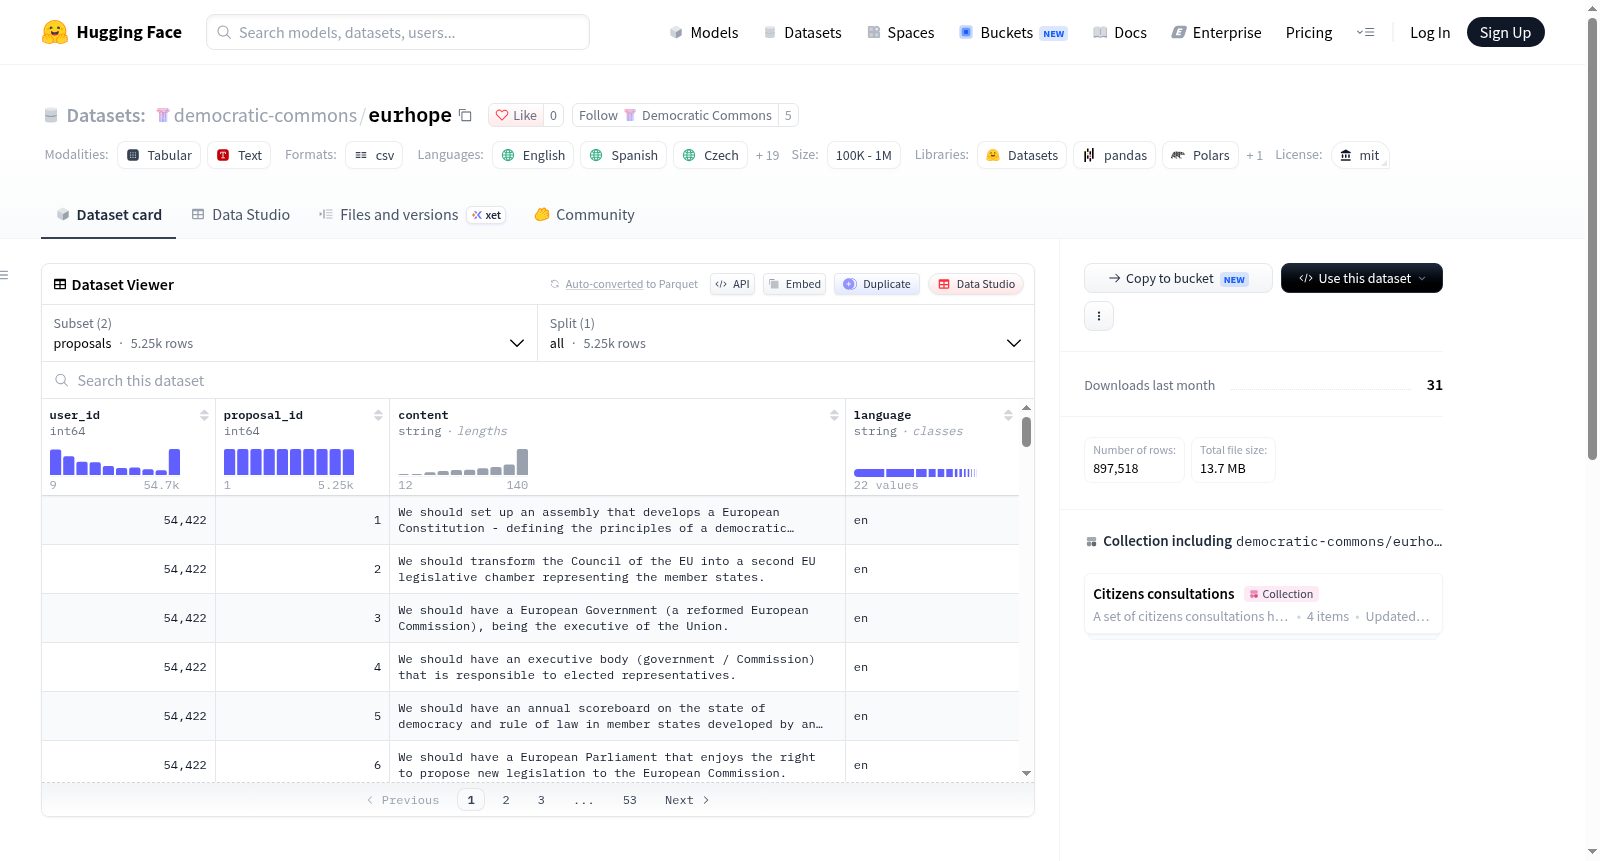
Eurhope是一个面向欧盟未来的多语言公民咨询数据集,于2024年举行。该数据集包含两个子集:提案(proposals)和投票(votes)。提案子集包含用法语撰写的书面提案,每个提案有文本内容(content)、作者标识符(author_id)、唯一提案标识符(proposal_id)以及语言列(language),覆盖22种欧洲语言。投票子集包含用户对提案的投票记录,每个投票包含用户标识符(user_id)、提案标识符(proposal_id)和投票值(vote),取值为1(同意)、0(中立)或-1(反对)。数据集规模介于1,000到10,000条记录之间,来源于Make.org与青年欧洲联邦主义者合作举办的真实公民咨询项目,适用于多语言自然语言处理、公民参与分析、意见挖掘等研究任务。
创建时间:
2026-09-02
搜集汇总
数据集介绍
构建方式
该数据集源于2024年由Make.org与欧洲青年联邦主义者合作发起的泛欧公民咨询项目Eurhope,旨在汇聚欧盟公民对欧洲未来议题的书面提案与投票意见。数据采集通过多语言在线平台完成,提案以法语撰写,并由系统自动标注其原始语言,覆盖22种欧洲语言。每条提案记录包含唯一标识符、作者匿名ID、文本内容及语言标签;投票数据则记录用户对提案的赞成、中立或反对态度,形成提案与用户互动的结构化档案。
特点
数据集以多语言、大规模公民参与为核心特征,包含提案与投票两个子集,提案文本以法语为主并附带22种语言标记,投票数据提供三值离散反馈,反映公众意见的极性分布。数据规模适中,介于1千至1万条之间,覆盖欧盟多国语言与文化背景,为研究跨国政治参与、意见挖掘及多语言自然语言处理提供了真实且丰富的语料资源。
使用方法
研究者可通过HuggingFace datasets库加载该数据集,分别访问proposals与votes配置。提案子集适用于文本分析、语言识别、主题建模等任务;投票子集可用于协同过滤、意见预测或社会网络分析。数据以CSV格式存储,字段清晰,便于直接读取与预处理。使用时应遵循MIT许可,注明数据来源,并注意匿名化处理以保护参与者隐私。
背景与挑战
背景概述
2024年,Make.org与欧洲青年联邦主义者合作开展了名为Eurhope的欧盟范围多语言公民咨询,旨在汇聚民众对欧洲未来的见解。该数据集收录了公民以22种语言撰写的提案及其投票记录,为计算社会科学与多语言自然语言处理提供了珍贵资源。作为反映欧洲公民政治参与和语言多样性的真实世界数据,它推动了跨语言立场检测、民主协商分析及低资源语言处理等研究,对理解欧盟公共舆论与决策机制具有重要价值。
当前挑战
该数据集所应对的核心领域问题在于大规模多语言政治协商中的意见挖掘与聚合,其挑战包括语言覆盖不平衡、文本噪声与拼写变异,以及投票行为中潜在的社会期望偏差。构建过程中,参与者匿名性导致元数据缺失,提案内容的主观性增加了标注一致性难度;此外,投票数据稀疏且用户群体代表性有限,可能影响模型泛化能力。这些因素共同制约了基于该数据集的公平且鲁棒的分析与建模。
常用场景
经典使用场景
在计算社会科学与计算语言学的交叉领域中,eurhope数据集最为经典的使用场景当属面向多语言政治文本的意见挖掘与立场分析。研究者依托其涵盖二十二种欧洲语言的公民提案语料,结合用户对提案的赞同、中立或反对投票记录,构建跨语言的立场检测模型与意见聚合系统。该数据集特有的提案-投票二元结构,使得研究者能够将文本语义表征与群体偏好信号进行联合建模,从而在 multilingual 环境下探索政治意见的形成机制与极化现象。
解决学术问题
该数据集有效回应了欧洲政治传播研究中长期存在的若干学术难题,包括跨国比较研究中多语言语料匮乏、公民政治参与数据的稀疏性与偏差校正,以及意见动态演化建模中的跨语言对齐问题。其真实世界的大规模公民咨询属性,为检验协商民主理论、沉默螺旋效应和群体极化假说提供了可复现的实证基础。数据集的公开亦推动了低资源语言政治文本处理技术的发展,具有方法论层面的示范意义与跨学科影响力。
衍生相关工作
基于eurhope数据集,学界已衍生出一系列围绕多语言意见挖掘、跨文化政治立场检测和协商民主计算分析的经典工作。部分研究将其作为基准,评估多语言预训练模型在政治文本上的迁移能力;另一些工作则利用投票矩阵开展矩阵分解与社区发现,揭示欧洲公众意见的潜在维度结构。这些衍生研究不仅丰富了计算政治学的实证文献,也为后续大规模公民咨询数据的标准化采集与分析树立了参照范式。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


