
遇见数据集

osm-polygon-wikidata-sentence-relevance

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

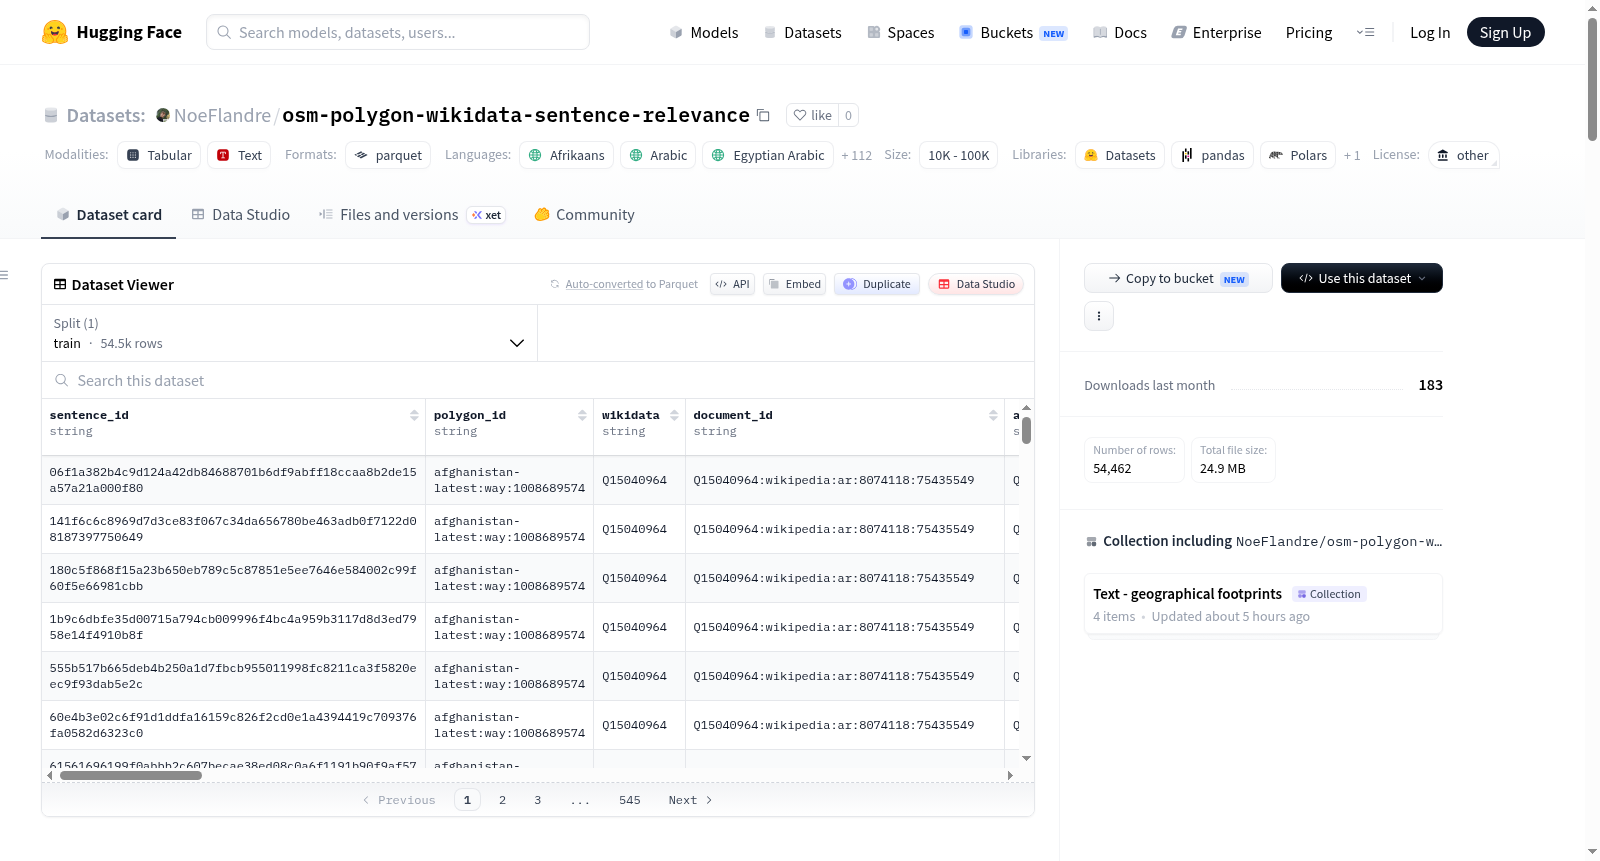
OSM多边形Wikidata句子相关性数据集是一个从OpenStreetMap(OSM)多边形及其关联的维基百科/Wikivoyage页面提取的规范化句子集合。每个数据行代表一个在特定多边形、语言和内容哈希范围内去重后的句子出现。当前版本仅覆盖阿富汗地区,包含54,462个句子行,涉及161个唯一多边形、154个唯一Wikidata实体、1,680个唯一文档和115种语言。数据主要来源于维基百科(54,152行)和Wikivoyage(310行)。句子经过多语言模型分割、边界修复、文本规范化等处理,并在同一多边形和语言内精确去重。该数据集适用于多语言语料库分析以及研究不同语言下对地点的描述方式,但并非标注的相关性、相似性或分类数据集。数据遵循上游数据源的许可条款,包括OpenStreetMap的ODbL许可和维基媒体的CC BY-SA许可。

The OSM Polygon Wikidata Sentence Relevance Dataset contains normalized sentences extracted from OpenStreetMap (OSM) polygons and their associated Wikipedia/Wikivoyage pages. Each data row represents a deduplicated sentence occurrence, scoped to a specific polygon, language, and content hash. The current version only covers the Afghanistan region (afghanistan shard). The dataset includes 54,462 sentence rows, involving 161 unique polygons, 154 unique Wikidata entities, 1,680 unique documents, and 115 languages. Data is primarily sourced from Wikipedia (54,152 rows) and Wikivoyage (310 rows). Each sentence undergoes processing such as multilingual model segmentation, boundary fixing, text normalization, and exact deduplication within the same polygon and language. The dataset is suitable for multilingual corpus analysis and studying descriptions of places across languages, but it is not an annotated relevance, similarity, or classification dataset. Data follows the licensing terms of upstream sources, including ODbL for OpenStreetMap and CC BY-SA for Wikimedia.

创建时间:
2026-07-15
搜集汇总
数据集介绍
osm-polygon-wikidata-sentence-relevance 数据集图片
构建方式
该数据集从OpenStreetMap(OSM)多边形及其关联的Wikipedia与Wikivoyage页面中提取句子,构建流程严谨且可复现。首先,每个与OSM多边形关联的Wikipedia或Wikivoyage章节被逐一处理,保留章节顺序及语言信息。随后,采用多语言句子分割模型`segment-any-text/sat-12l-sm`推断句子边界,并施加一个保守的残差边界修复规则,通过二次确定性扫描处理特定标点符号的切分问题。每个分割片段经过规范化处理,包括Unicode NFC标准化、零宽字符去除及空白压缩。句子按章节顺序索引,并基于多边形标识、语言及规范化文本的SHA-256哈希生成唯一句子标识符。最后,在相同多边形和语言范围内进行精确去重,并通过发布审计确保无可疑边界残留,从而生成包含54462行、覆盖115种语言的可靠语料库。
使用方法
该数据集以独立的Parquet表格形式提供,可通过Hugging Face Datasets库便捷加载。用户可使用`load_dataset`函数,指定配置名为`default`,从默认路径加载训练集分割的全部数据。加载后的数据集包含34个字段,其中`sentence_text_raw`与`sentence_text_normalized`分别提供原始与规范化句子文本,适用于文本分析任务;`language`字段支持按语言进行子集筛选;`lat`与`lon`字段则可用于地理空间可视化或区域研究。对于需要复用句子标识的场景,`sentence_id`可作为唯一键使用。需要注意的是,数据集当前仅覆盖阿富汗区域,且不包含相关性标签,因此典型用途包括多语言语料库统计、跨语言文本比较以及地理实体的描述模式分析。研究人员还可依据`source`字段区分Wikipedia与Wikivoyage来源,进行细粒度的来源对比实验。
背景与挑战
背景概述
该数据集由研究者Noe Flandre构建,于2024年首次发布,旨在从开放地理数据与多语言百科知识之间搭建桥梁。研究核心聚焦于如何从OpenStreetMap(OSM)多边形地理实体与其关联的维基百科、维基导游页面中,提取并规范化多语言句子,以支持地理语义的跨语言理解与分析。数据集当前涵盖阿富汗区域,包含161个多边形、154个维基数据实体及115种语言的约5.4万条去重句子,展现了地理信息与自由文本描述之间的复杂映射关系。其在自然语言处理与地理信息系统交叉领域具有重要价值,为探索如何利用众包百科内容丰富地理实体描述、推动多语言地理信息检索与知识图谱构建提供了宝贵的基础资源。
当前挑战
该数据集解决的核心领域挑战在于,地理实体(如机场、建筑物)的文本描述分布于不同语言、不同来源的百科页面中,缺乏统一的、经过句子级分割与规范化处理的语料库,难以支持细粒度的跨语言地理语义分析。构建过程中面临多重困难:首先,需处理115种语言的句子边界检测,采用自动分割模型后仍需设计保守的边界修复规则以应对缩略词、数字及混合脚本的歧义;其次,多源文本(维基百科与维基导游)的去重依赖精确哈希匹配,无法处理语义相似但表达不同的冗余内容;最后,数据仅覆盖阿富汗区域,且上游OSM与维基媒体数据的可用性与语言分布不均衡,限制了模型的泛化能力与地域拓展性。
常用场景
经典使用场景
该数据集的核心应用在于多语言地理实体描述的语料分析。通过将OpenStreetMap(OSM)中的地理多边形与维基百科、维基导游中对应页面的句子进行对齐,研究者能够获得一个跨越115种语言、涵盖161个独特地理实体的细粒度平行语料库。每一行数据都精确保留了句子的原始上下文、所属章节、文档来源以及对应的OSM标签与坐标信息,从而为跨语言地理信息检索、多模态地理知识图谱构建以及多语言自然语言处理任务提供了结构严谨、语义丰富的基准数据。尤其在没有明确标签标注的情况下,该数据集极适合用于探索不同语言社群如何描述同一地理对象的语言现象差异。
解决学术问题
该数据集解决了地理实体描述研究中长期存在的跨语言对齐难题。在传统资源中,同一地点的多语言描述往往分散于不同平台且缺乏统一的结构化关联,导致多语言地理信息检索、跨语言地名消歧以及多源地理知识融合等任务难以开展。通过将OSM的多边形标识与维基百科、维基导游的句子进行确定性映射,该数据集为上述任务提供了可靠的数据基础。其意义在于,它不仅促进了多语言地理语料库的标准化建设,还为评估多语言语义相似度模型、跨语言地理实体链接系统以及地域性文化表达分析等学术议题提供了可重复验证的实验平台,进而推动了地理空间信息学与计算语言学的交叉融合。
实际应用
在实际应用中,该数据集能够为一系列地理信息服务提供语料支撑。例如,基于多语言地理描述训练出的语义检索模型,可以服务于国际旅行导航平台,使得用户能够使用母语搜索到特定地点的详细描述;在灾害应急响应系统中,利用不同语言版本的地理语料,可以快速融合来自多元信息源的灾后现场描述,辅助决策者掌握全局态势;此外,该数据集还可用于增强地图应用的自动标签翻译与多语言地名解析功能,提升全球用户的无障碍体验。对于诸如众包地图质量评估、多语言维基旅游内容推荐等商用场景,该数据集同样提供了宝贵的多语言语料基准。
数据集最近研究
最新研究方向
该数据集聚焦于地理空间实体与多语言百科文本的语义对齐,为地理信息检索与跨语言知识图谱构建提供了精细化的语料基础。当前研究前沿集中于利用大规模OpenStreetMap多边形与维基百科、维基导游的关联文本,探索地域描述的多模态表征与跨源一致性。该数据集以阿富汗区域为试点,整合了115种语言、5.4万余条归一化句子,并对句子边界进行了基于深度学习模型的精准分割与去重,确保了文本质量与可复现性。其独特之处在于保留了完整的上下文、哈希指纹与来源版本信息,支持可溯源的语料分析与模型训练。在地理信息科学领域,该资源推动了从静态地图标注到动态文本理解的范式演进,尤其对于低资源语言的地名解析与知识补全具有里程碑意义。此外,与开放地理数据及维基媒体项目的紧密耦合,为构建可解释、多语言的地理问答系统与位置感知语言模型提供了高质量的训练与评估基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

