
Textual Frequency Paired Dataset (TFPD)
收藏资源简介:
TFPD是由FaceMind公司和香港中文大学联合构建的文本频率配对数据集,包含数学推理(GSM8K)、机器翻译(FLORES-200)、常识推理和工具调用四个任务。数据集通过GPT-4o-mini生成高频和低频表达的句子对,并经过严格的人工语义一致性验证,最终保留738对数学推理和526对机器翻译数据。该数据集旨在研究文本频率对大型语言模型提示和微调的影响,为解决模型在语义相同但表达频率不同的文本上表现差异的问题提供基准。
TFPD is a text frequency paired dataset jointly constructed by FaceMind and The Chinese University of Hong Kong. It encompasses four tasks: mathematical reasoning (GSM8K), machine translation (FLORES-200), commonsense reasoning, and tool calling. Sentence pairs with high-frequency and low-frequency expressions were generated via GPT-4o-mini for this dataset, followed by rigorous manual semantic consistency validation. Ultimately, 738 pairs of data for mathematical reasoning and 526 pairs of machine translation data were retained. This dataset aims to investigate the impact of text frequency on prompting and fine-tuning of large language models (LLMs), and provides a benchmark for addressing the performance discrepancies of models when processing texts with identical semantics but varying expression frequencies.
FrequencyLaw 数据集概述
数据集基本信息
- 数据集名称:FrequencyLaw: Textual Frequency Law on Large Language Models
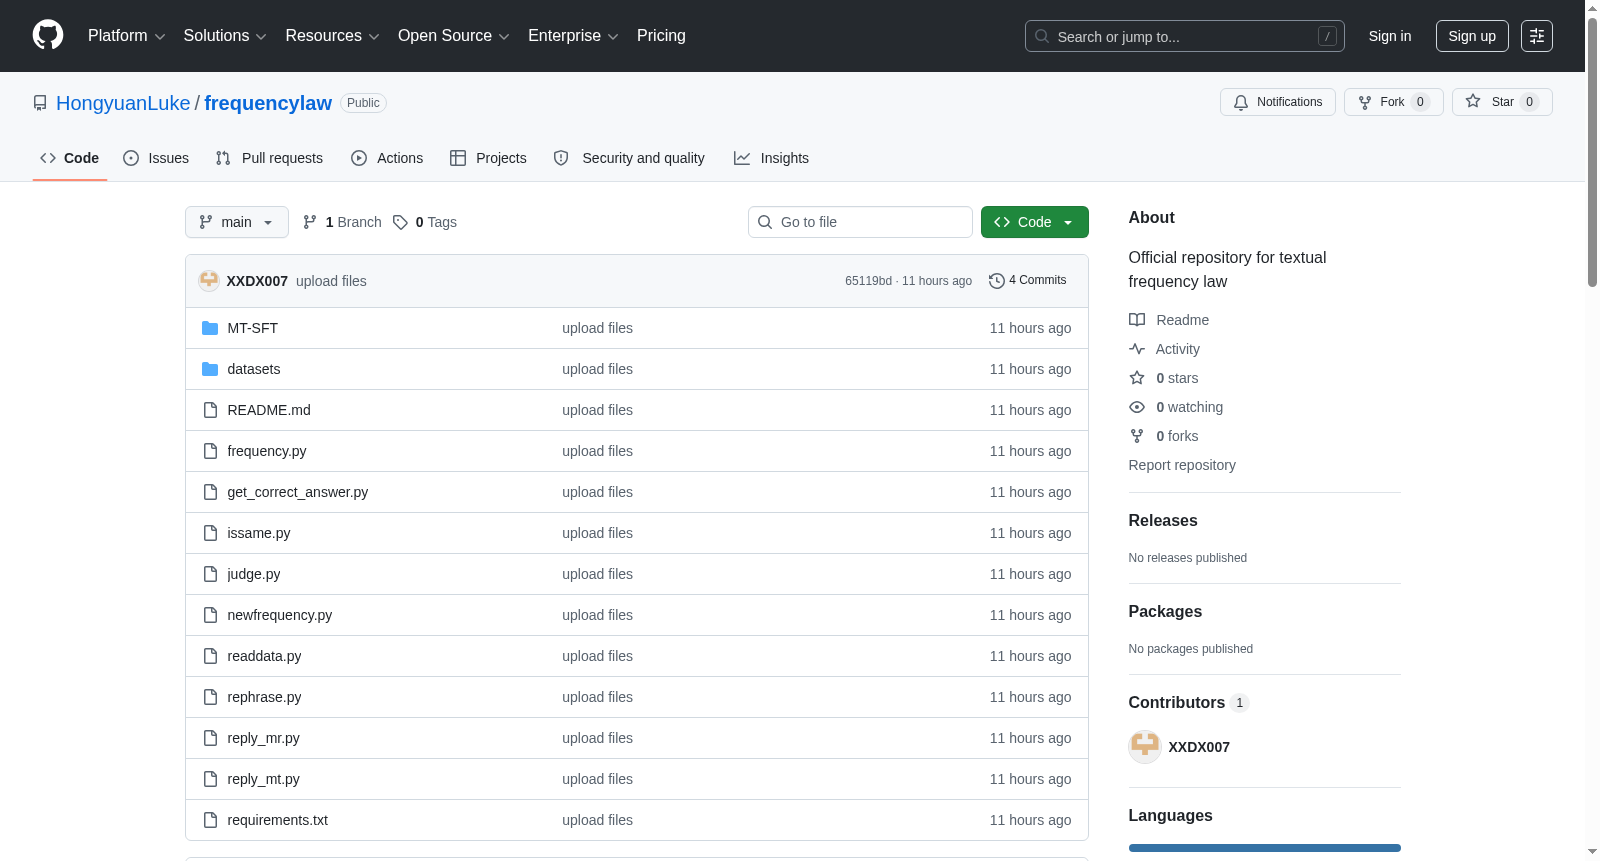
- 官方代码库地址:https://github.com/HongyuanLuke/frequencylaw
- 关联论文:Textual Frequency Law on Large Language Models
数据集核心内容与目的
该数据集是论文《Textual Frequency Law on Large Language Models》的官方代码库及数据资源。其核心目的是验证文本频率对大语言模型在数学推理和机器翻译任务上的优化效果。数据集基于GSM8K(数学推理)和FLORES-200(机器翻译)构建了文本频率配对数据集,用于支持论文中提出的三种核心方法的实现与实验复现。
数据集包含的核心方法
- 文本频率定律:文本频率的计算方法。
- 文本频率蒸馏:通过蒸馏优化文本频率。
- 课程文本频率训练:基于频率的课程学习训练策略。
数据集文件结构
数据集主要包含以下文件与目录:
核心数据集文件 (datasets/)
csqa-highfrequency.txt:CSQA高频数学问题。csqa-lowfrequency.txt:CSQA低频数学问题。gsm8k-highfrequency.txt:GSM8K高频数学问题。gsm8k-lowfrequency.txt:GSM8K低频数学问题。
机器翻译微调模块 (MT-SFT/)
data/:机器翻译任务数据存储目录。merge.py:数据合并脚本。sort_frequency.py:频率排序工具。runmodel.py:运行微调后的模型权重。
核心功能脚本
frequency.py:文本频率计算核心脚本(实现TFL)。newfrequency.py:TFD蒸馏后重新计算频率。get_correct_answer.py:数学推理答案验证。issame.py:语义一致性检查(用于数据集构建)。judge.py:模型输出自动评估。readdata.py:数据集加载工具。rephrase.py:文本释义生成(高/低频版本)。reply_mr.py:数学推理模型推理。reply_mt.py:机器翻译模型推理。
支持的任务
- 数学推理
- 机器翻译
环境依赖
- Python: 3.9+
- PyTorch: 2.0+
- 核心库: Hugging Face Transformers/Datasets/Accelerate, NumPy/Pandas, LoRA (peft)
- 1Adam's Law: Textual Frequency Law on Large Language ModelsFaceMind公司; 香港中文大学 · 2026年



