
imageomics/TreeOfLife-200M-Embeddings
收藏官方服务:
资源简介:
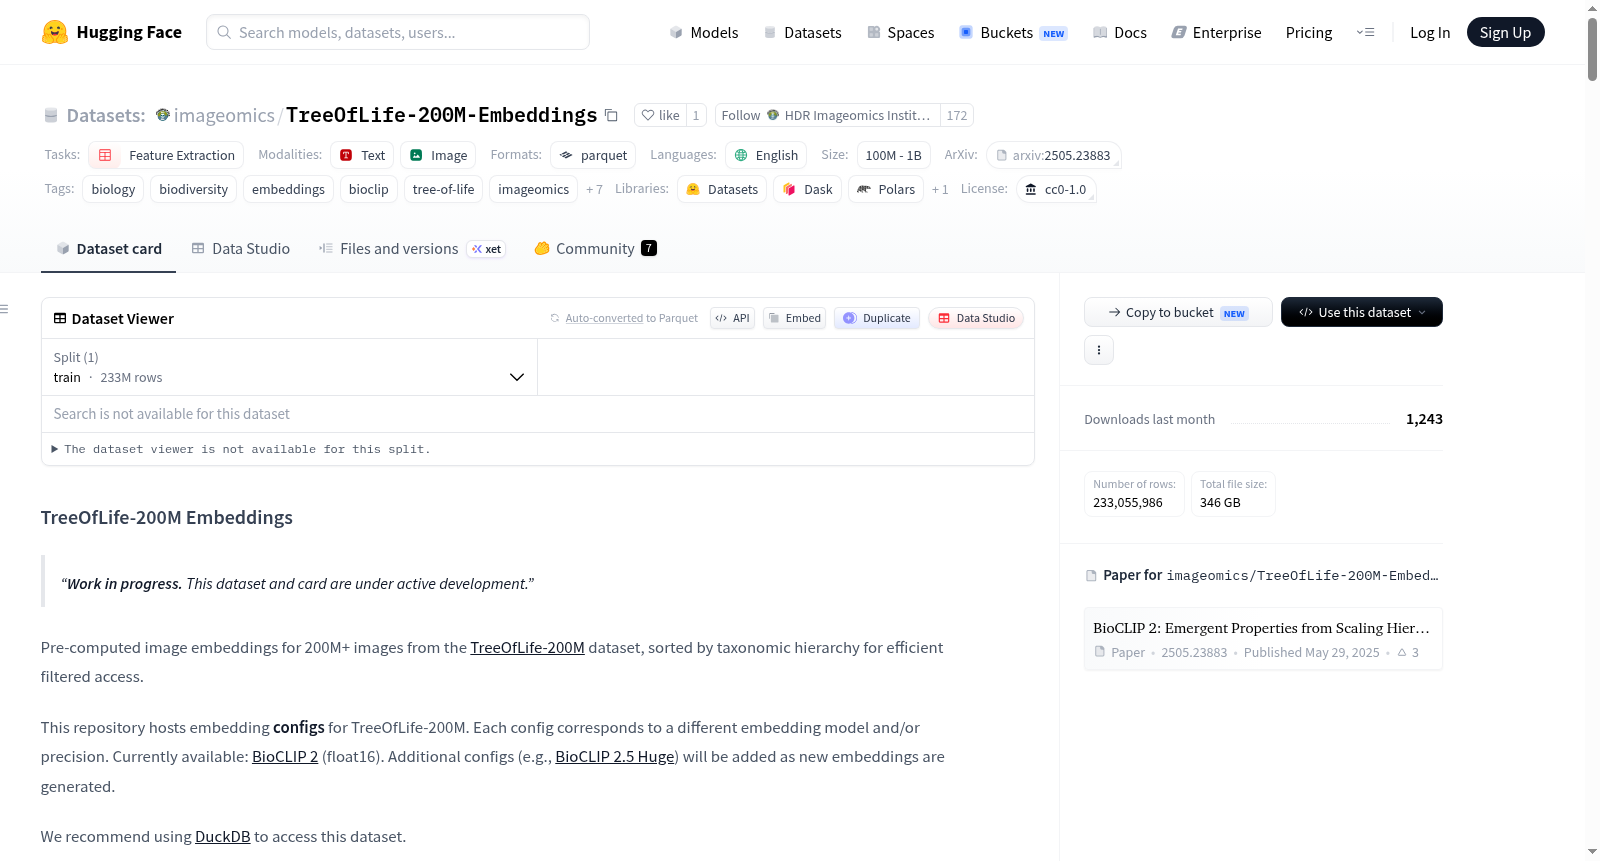
TreeOfLife-200M Embeddings 是一个预计算的图像嵌入数据集,基于 TreeOfLife-200M 数据集中的超过2亿张图像生成。该数据集按分类学层级(如界、门、纲、目、科、属、种)排序,以支持通过 DuckDB 进行高效过滤访问。数据集不存储原始图像,仅包含预计算的嵌入向量和相关的分类学元数据。每个嵌入向量对应一个图像的唯一标识符(uuid),并附带来源数据集、分类学信息(如科学名称、俗名)、发布者等元数据字段。支持多种嵌入模型配置(如 BioCLIP 2 的 float16 版本),嵌入维度为768。数据集旨在用于特征提取、分类学过滤检索、下游训练(如微调分类器)和精确相似性计算等任务。数据以 Parquet 格式存储,使用 ZSTD 压缩,并包含页面索引以优化查询性能。
Pre-computed image embeddings for 200M+ images from the TreeOfLife-200M dataset, sorted by taxonomic hierarchy for efficient filtered access via DuckDB. Multiple embedding model configs supported. No images stored.
提供机构:
imageomics搜集汇总
数据集介绍
构建方式
本数据集基于TreeOfLife-200M数据集中的逾两亿张生物图像,通过视觉基础模型(如BioCLIP 2)提取固定维度的嵌入向量。所有嵌入向量与原始图像的元数据(包括分类学层级信息、数据来源等)一一关联,并按照数据来源、界、门、纲、目、科、属、种等分类学层级进行全局排序,使得分类学上相近的图像在物理存储上彼此相邻。数据以Parquet格式存储,采用ZSTD级别3压缩,每个行组包含五万行并附有页索引,最终生成约666个文件,总计约346GB,仅包含嵌入向量与元数据,不保留任何原始图像。
特点
该数据集的核心优势在于其规模与可检索性。它提供了超过2.3亿条预计算嵌入向量,覆盖动物、植物、真菌等多个生物界,并支持多种嵌入模型配置(如float16精度的BioCLIP 2)。通过全局分类学排序与Parquet页索引的设计,用户能够利用DuckDB等工具实现高效的分类学过滤查询,例如在数秒内提取整个猫科或灵长目对应的嵌入子集。此外,数据集采用CC0 1.0许可协议,便于学术研究中的二次使用与分发。
使用方法
推荐使用DuckDB进行本地或远程查询。本地使用时,可通过Hugging Face下载工具将整个配置下载至本地,随后使用DuckDB的Parquet读取函数进行快速过滤与提取,如提取特定物种或科级分类单元的嵌入向量。远程查询则直接通过hf://协议访问Hugging Face存储,适用于聚合统计与小规模数据获取。用户需注意,order与class为SQL保留字,查询时应加引号处理。对于大规模批量访问,建议优先下载至本地以避免网络传输中断问题。
背景与挑战
背景概述
TreeOfLife-200M-Embeddings数据集由俄亥俄州立大学Imageomics研究所的Net Zhang、Elizabeth Campolongo、Matthew Thompson和Jianyang Gu等研究人员于2025年创建,旨在破解大规模生物图像特征提取的算力困局。该数据集基于包含逾2亿张生物图像的TreeOfLife-200M源数据集,预先计算并存储了由BioCLIP 2等视觉基础模型生成的图像嵌入向量,并依据界、门、纲、目、科、属、种等完整的分类学层级进行全局排序。作为连接大规模生物图像与下游机器学习应用的关键枢纽,该数据集为分类器微调、相似性检索及生物多样性分析提供了高效的特征存储与访问方案,在计算机视觉与生态学交叉领域产生了深远影响。
当前挑战
该数据集面临多维度挑战。在领域问题层面,需解决从海量、类别高度不平衡的生物图像中提取通用特征表示的难题:源数据中约60%的公民科学图像偏向常见物种与活跃地区,造成分类学覆盖不均与地理采样偏差,同时社区贡献的分类标签存在不完整或未解析情形。在构建过程中,需应对92TB原始图像经BioCLIP 2模型推理生成768维嵌入向量的巨大计算开销,并设计全局排序与Parquet格式的存储方案以支持高效过滤访问;此外,远程查询时通过Hugging Face CDN传输超过20MB的嵌入切片常遭遇TProtocolException中断,迫使用户采用本地下载策略,而310GB以上的完整配置下载又对存储与带宽提出了苛刻要求。
常用场景
经典使用场景
TreeOfLife-200M-Embeddings数据集为生物多样性研究提供了超越2亿张生物图像预计算嵌入向量的宝贵资源,其核心使用场景在于无损耗地提取分类学引导的特征表示。借助DuckDB高效的分页索引谓词下推机制,研究者能够依据王国、门、纲、目、科、属、种等分层分类等级,快速检索并获取指定生物类群的图像嵌入。这一设计免除了重复运行庞大视觉模型(如BioCLIP 2)的需求,使得大规模生物图像的特征检索与分析变得经济且迅捷,是生物成像领域中特征工程的重要基础设施。
实际应用
在实际应用中,TreeOfLife-200M-Embeddings可无缝嵌入生物多样性监测与生态保护工作流。例如,公民科学平台(如iNaturalist)上传的海量观测图像可通过该嵌入索引,实现基于相似性搜索的物种自动识别与验证。野生动物摄影师或生态学家能够使用该数据构建自定义的图像检索系统,在数百毫秒内从数百万张图像中找到与目标物种形态最接近的记录。此外,博物馆标本数字化项目与生物影像数据库可以利用这些嵌入向量进行跨源数据的快速匹配与去重,显著提升大规模生物数据管理的准确性与效率。
衍生相关工作
该数据集直接衍生并支持了一系列重要的学术工作,其中最引人注目的是BioCLIP 2系列视觉模型的训练与评估。这些工作利用TreeOfLife-200M-Embeddings作为下游任务的嵌入源,系统探究了层次化对比学习在生物分类理解上的涌现属性。与之紧密关联的bioclip-image-search-lite数据集则进一步构建了FAISS索引与DuckDB元数据整合的相似性搜索工具,为高通量的生物图像检索奠定了实践基础。这些衍生研究不仅验证了预计算嵌入在多层级分类学任务中的有效性,更推动了以数据驱动的方式理解生命树形态多样性的前沿探索。
以上内容由遇见数据集搜集并总结生成


