
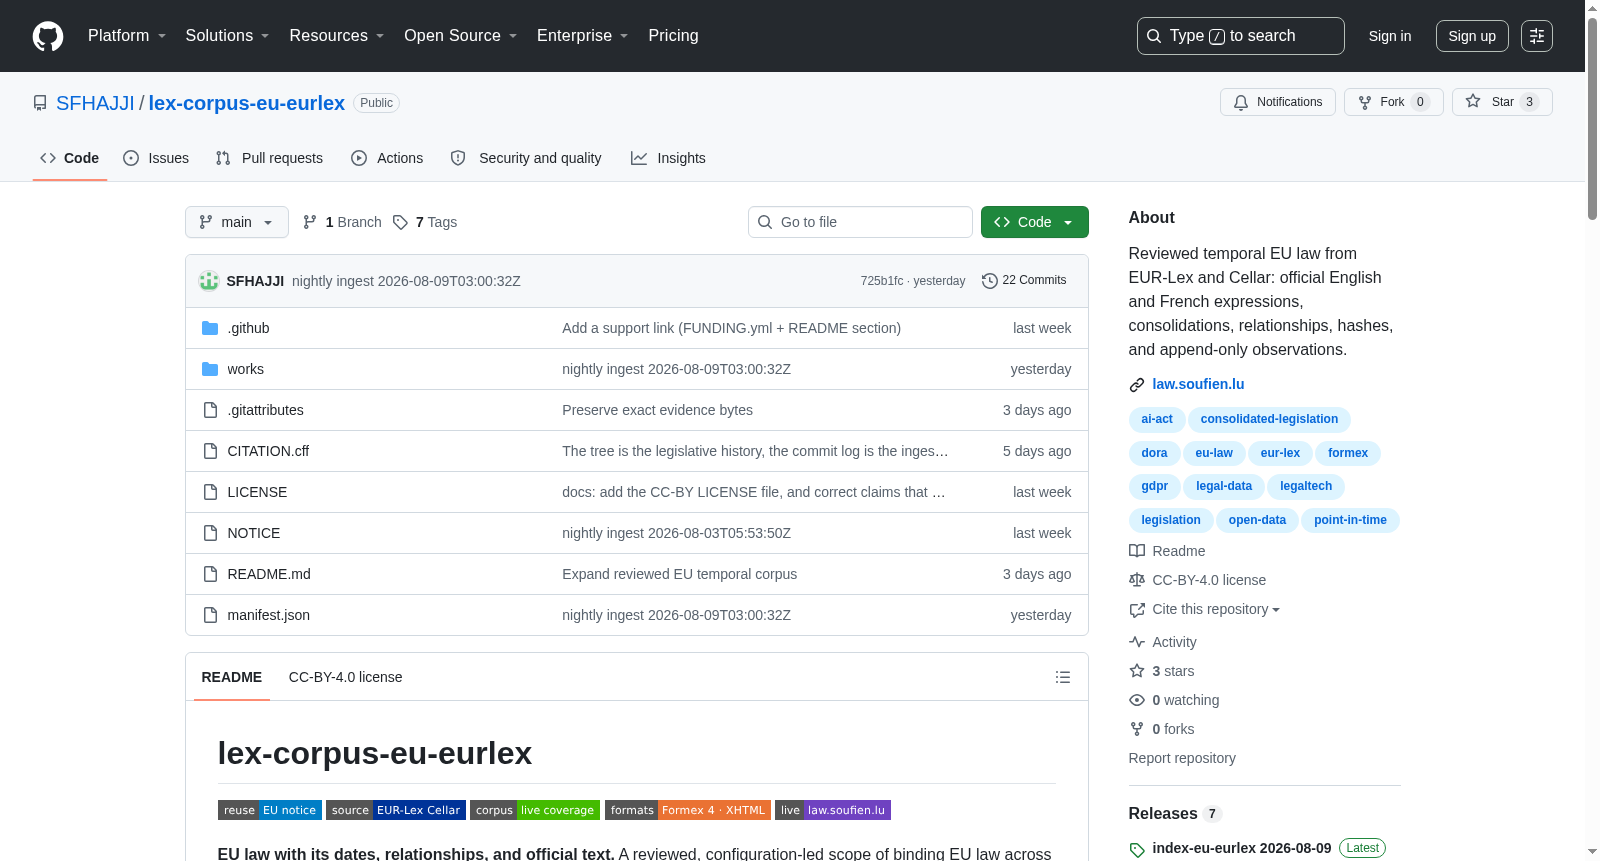
lex-corpus-eu-eurlex
收藏官方服务:
资源简介:
一个经过审查的欧盟法律时间序列语料库,包含官方英法文原始和合并表达,以及修正、勘误、废止、前身、后继、法律依据、授权和实施关系,用于解释时间线。
A curated EU legal time-series corpus containing original and combined official English and French language expressions, as well as relationships including amendments, corrigenda, repeals, predecessors, successors, legal bases, authorizations and implementation connections, which is used to explain the legal timeline.
创建时间:
2026-08-01
原始信息汇总
lex-corpus-eu-eurlex 数据集详情
数据集概述
该数据集收录欧盟具有约束力的法律文本,覆盖对卢森堡从业者最有用的多个领域,包含英文和法文的官方原始版本与合并版本,并存储修正、勘误、废止、前身、后继、法律依据、授权和实施等关系,以解释法律文本的时间线。
数据来源与权威性
- 来源:EUR-Lex Cellar(https://eur-lex.europa.eu)
- 权威性:仅收录具有约束力的欧盟文书(条例直接适用,指令需转换);合并版本为非权威工作文本,不具有法律效力,只有官方公报发布的文书才具有真实性
- 检索方式:通过 Cellar SPARQL 和 REST 内容协商实现机械化获取
数据内容与格式
- 覆盖范围:约束性条例、指令、决定、基础法律及其可用原始和合并表达
- 文件格式:Formex 4 和 XHTML,正文以逐字逐句方式存储,未经任何改动
- 数据结构:按
works/<法规编号>/versions/<日期>/组织,每个版本包含meta.json及对应正文文件;正文超过 4 MB 时仅保留元数据和链接 - 版本保留:所有被取代的版本均被保留,每个合并版本可通过 CELEX 号访问
许可与再利用
- 文本再利用:允许,需注明出处,依据欧盟委员会第 2011/833/EU 号决定
- 元数据再利用:同样允许,依据相同法律依据
更新机制
- 每日夜间自动运行一次计划任务,无人工发布步骤
- 包含异常检测门控(数据量下降超过 5% 时丢弃并拒绝提交)、确定性检查、索引签名、安全部署和状态报告等完整流程
- 每次索引均带有构建时间和来源提交记录的时间戳,用于审计溯源
搜集汇总
数据集介绍
构建方式
该数据集以欧盟官方法律数据库EUR-Lex为权威来源,通过配置驱动的范围选择,系统性地采集具有法律约束力的法规、指令、决定及基础法律文本,并完整收录其法文与英文的原始版本与合并版本。数据构建采用自动化流水线,每日定时执行,从Cellar SPARQL接口及REST内容协商机制获取数据,严格逐字存储,确保内容完整性与不可篡改性。每个版本均附带详尽的元数据,包括生效日期、法律事件及SHA256哈希校验值,并依据出版者自身的顺序推导失效日期。对于超过4MB的文本体,采用元数据与链接保留的策略。所有数据存放于Git仓库中,利用其不可变性保证数据的可追溯性与审计性。
特点
该数据集独一无二地融合了时间维度与法律演进脉络,每个文档均保存完整的版本历史,并标注修订、更正、废止、前序、后继及法律基础等相互关系,清晰揭示法律时效性。数据以Formex 4与XHTML等多种格式提供,方便不同场景下进行解析与复用。数据集的Git仓库不仅提供数据,还作为完整的证据层,通过内置哈希记录保证每个字节的真实性。此外,数据集的构建过程具备严谨的异常检测与确定性保障机制,任何异常情况均会中止提交,避免污染数据。更为重要的是,数据集明确区分法律权威文本与非官方合并文本,并附有法律效力声明,确保数据使用的严谨性。
使用方法
使用者可以通过Git克隆整个仓库,立即获得完整且可验证的数据集,无需API密钥或数据库账户。数据以works/<slug>/versions/<date>/的目录结构组织,便于浏览特定法律文件在特定日期的状态。每个版本的meta.json文件提供了该版本的有效期、事件及哈希值等元数据,而XHTML或Formex 4文件则包含全文或指向大体积版本的链接。对于开发应用,提供了实时演示站点与MCP端点,允许远程查询。此外,数据集附带一个清单文件(manifest.json),记录了所有文件的哈希与大小,并采用Azure Key Vault签名的P-256密钥进行完整性验证,确保数据在分发过程中的可靠性。同时,提供每条款级别的派生数据集,便于进行深度法律文本分析。
背景与挑战
背景概述
lex-corpus-eu-eurlex数据集由Soufien Hajji于2026年创建,旨在系统化整理欧盟约束性法律文本及其时间线关系。该数据集依托EUR-Lex Cellar的SPARQL接口与REST内容协商机制,以配置驱动的方式精选对卢森堡实务界最具价值的法律领域,收录法规、指令、决定及基础条约的原始与整合版本,并涵盖修正、勘误、废止、继承、法律依据及授权关系等元数据。其核心研究问题在于构建一个可验证、可追溯且具备版本完整性的法律语料库,以支持法律信息检索、文本挖掘及时间线推理等应用。该数据集采用Git仓库作为存储与分发媒介,通过sha256哈希确保内容完整性,并以不可变提交记录维护观测历史,在欧盟法律数字化领域树立了透明性与可复现性的新标杆,对法律科技研究与合规分析具有重要参考价值。
当前挑战
该数据集面临的核心挑战之一是法律文本的合法性与时效性:仅官方公报发布的文本具有法律效力,整合版本仅为工作文本,需在呈现时明确标注并链接至EUR-Lex原始页面。构建过程中需应对大规模数据处理的工程难题,例如超过4MB的正文文件仅存储元数据链接,需通过Formex 4格式的清单文件承载全文,同时采用身份验证机制确保版本日期与文件内容一致。此外,数据集的持续更新依赖于夜间自动化管线,须处理上游响应异常导致的计数下降(超过5%即视为部分响应,丢弃本次结果),以及派生输出在源文件未变时出现变化所引发的非确定性失败。这些挑战要求数据集在内容准确性、系统稳定性和法律合规性之间取得精细平衡,确保长期运行的可靠与可信。
常用场景
经典使用场景
lex-corpus-eu-eurlex数据集作为欧洲联盟法律文本的结构化语料库,其经典应用场景聚焦于法律信息检索与自然语言处理研究。该语料库以CELEX编号体系组织,完整收录了条例、指令、决定等约束性法律文件的原始与合并版本,并精心标注了修订、更正、废止等法律效力关联关系。研究者常利用其层次分明的版本文档结构与双语对照特性,开展跨语言法律文本对齐、法律术语抽取及法律条文时间演化分析等前沿课题,为计算法学领域提供了坚实的数据基石。
解决学术问题
该数据集切实解决了法律人工智能领域中长期存在的训练语料匮乏与法律时效性建模难题。通过提供带有精确有效日期和版本关系的法律全文,它使研究者能够追踪法律规范的动态演变过程,支撑起法律变迁预测、引用网络分析及合并文本自动生成等研究。其公开透明的出处记录与可复现的构建流程,又为法律数据科学的实验可重复性设立了标杆,显著推进了法律知识图谱构建与法律文本摘要等核心议题的实证研究深度。
衍生相关工作
该数据集催生了一系列衍生性工作,其中最为瞩目的是基于同一数据引擎构建的按条文细粒度切分的lex-articles数据集,它极大便利了针对具体法律条款的深度学习建模。此外,配套的lex索引版本与向量化方案,为法律文本的语义检索与相似度计算提供了即用型基础。构建过程中所采用的不可变存储与可验证签名机制,亦启发了数字档案保存领域的相关研究,推动了法律数据治理与长期保存技术的发展。
以上内容由遇见数据集搜集并总结生成


