energy-eval-filtered_responses_multichoice_cemig-nlp-releases_enregy-gpt-regulatorio-v2_v4
收藏资源简介:
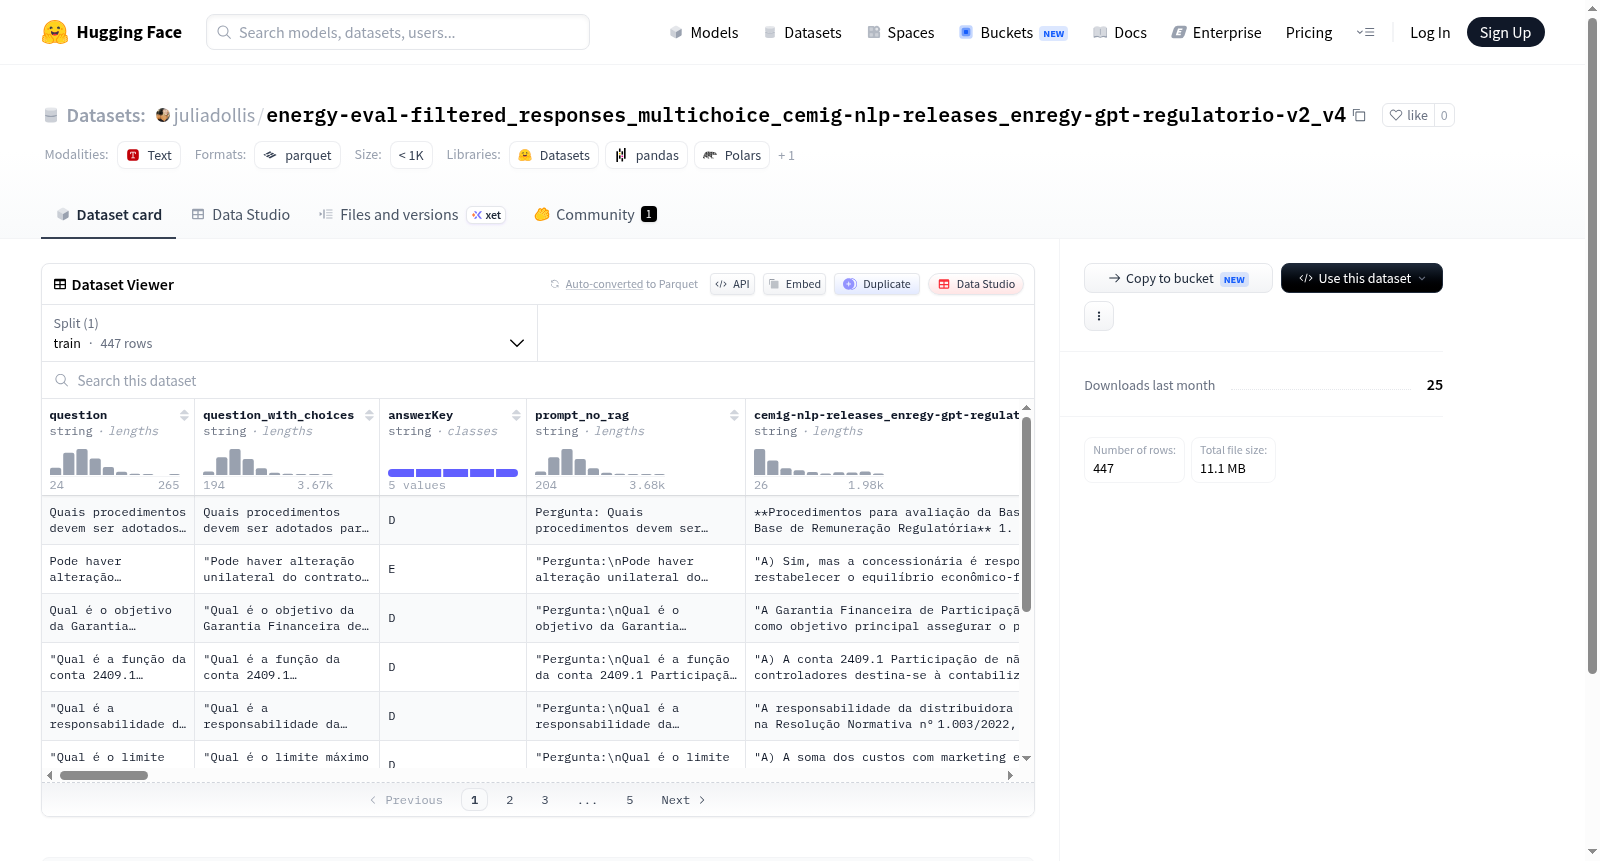
该数据集是一个专为能源监管领域问答任务设计的数据集,用于评估检索增强生成(RAG)技术。它包含447个训练样本,每个样本提供原始问题(question)、带选项的问题(question_with_choices)和正确答案(answerKey)。数据集重点提供了不同RAG配置下生成的提示词(prompt),包括基础的无RAG提示词(prompt_no_rag)以及一系列应用了RAG的提示词,这些提示词字段反映了复杂的实验配置,涉及开关RAG功能、使用不同的嵌入模型(如multilingual-e5-small-ft、multilingual-e5-large-ft-v2、qwen3-embedding-0.6B-ft)和可选的重排序器(如bge-reranker-v2-m3-ft及其变体)。部分字段(带有`_context`后缀)可能存储检索到的相关上下文信息。该数据集适用于研究RAG pipeline在特定垂直领域(能源监管)的性能,并比较不同嵌入和重排序策略对问答系统提示工程的影响。
This dataset is designed for question-answering tasks in the energy regulation domain, specifically for evaluating Retrieval-Augmented Generation (RAG) technology. It contains 447 training samples, each providing the original question (question), the question with options (question_with_choices), and the correct answer (answerKey). The dataset emphasizes the generated prompts under different RAG configurations, including a basic no-RAG prompt (prompt_no_rag) and a series of RAG-applied prompts. These prompt fields reflect complex experimental setups, involving toggling RAG functionality, using different embedding models (e.g., multilingual-e5-small-ft, multilingual-e5-large-ft-v2, qwen3-embedding-0.6B-ft), and optional re-rankers (e.g., bge-reranker-v2-m3-ft and its variants). Some fields (with the `_context` suffix) may store retrieved relevant context information. The dataset is suitable for researching the performance of RAG pipelines in a specific vertical domain (energy regulation) and comparing the impact of different embedding and re-ranking strategies on prompt engineering for question-answering systems.
数据集概述:energy-eval-filtered_responses_multichoice_cemig-nlp-releases_enregy-gpt-regulatorio-v2_v4
基本信息
- 数据集地址:https://huggingface.co/datasets/juliadollis/energy-eval-filtered_responses_multichoice_cemig-nlp-releases_enregy-gpt-regulatorio-v2_v4
- 下载大小:11,094,893 字节(约10.6 MB)
- 数据集大小:34,712,247 字节(约33.1 MB)
- 配置:默认配置(default),数据文件路径为
data/train-*
数据集划分
- 训练集(train):包含 447 个样本,占用 34,712,247 字节
特征字段
该数据集包含以下特征字段:
基本字段
- question (string):问题文本
- question_with_choices (string):包含选项的问题文本
- answerKey (string):正确答案键值
- prompt_no_rag (string):无检索增强生成(RAG)的提示文本
- prompt_rag (string):有检索增强生成(RAG)的提示文本
模型响应字段(无RAG)
- cemig-nlp-releases_enregy-gpt-regulatorio-v2_RAG-FALSE_ENC-none_RR-none (string):无检索增强生成模式下,模型的响应结果
模型响应字段(含RAG,使用不同编码器与重排序器组合)
该数据集包含多种RAG配置下的模型响应及其上下文信息,具体包括:
使用 multilingual-e5-small-ft 编码器
- 无重排序器:响应字段及对应的上下文字段
- 使用
bge-reranker-v2-m3-ft重排序器:响应字段及对应的上下文字段 - 使用
bge-reranker-v2-m3-ft-v2重排序器:响应字段及对应的上下文字段
使用 multilingual-e5-large-ft-v2 编码器
- 无重排序器:响应字段及对应的上下文字段
- 使用
bge-reranker-v2-m3-ft重排序器:响应字段及对应的上下文字段 - 使用
bge-reranker-v2-m3-ft-v2重排序器:响应字段及对应的上下文字段
使用 qwen3-embedding-0.6B-ft 编码器
- 无重排序器:响应字段及对应的上下文字段
- 使用
bge-reranker-v2-m3-ft重排序器:响应字段及对应的上下文字段 - 使用
bge-reranker-v2-m3-ft-v2重排序器:响应字段及对应的上下文字段
使用 qwen3-embedding-0.6B-ft-v2 编码器
- 无重排序器:响应字段及对应的上下文字段
- 使用
bge-reranker-v2-m3-ft重排序器:响应字段及对应的上下文字段 - 使用
bge-reranker-v2-m3-ft-v2重排序器:响应字段及对应的上下文字段
说明
- 所有模型响应字段以
cemig-nlp-releases_enregy-gpt-regulatorio-v2开头,命名规则体现了不同的RAG配置(RAG-TRUE/FALSE)、编码器(ENC)和重排序器(RR)组合。 - 每个RAG配置下的响应字段均带有
_context后缀的对应上下文字段,用于存储检索到的相关上下文信息。