
wikidata-federated-overlap-dataset
收藏官方服务:
资源简介:
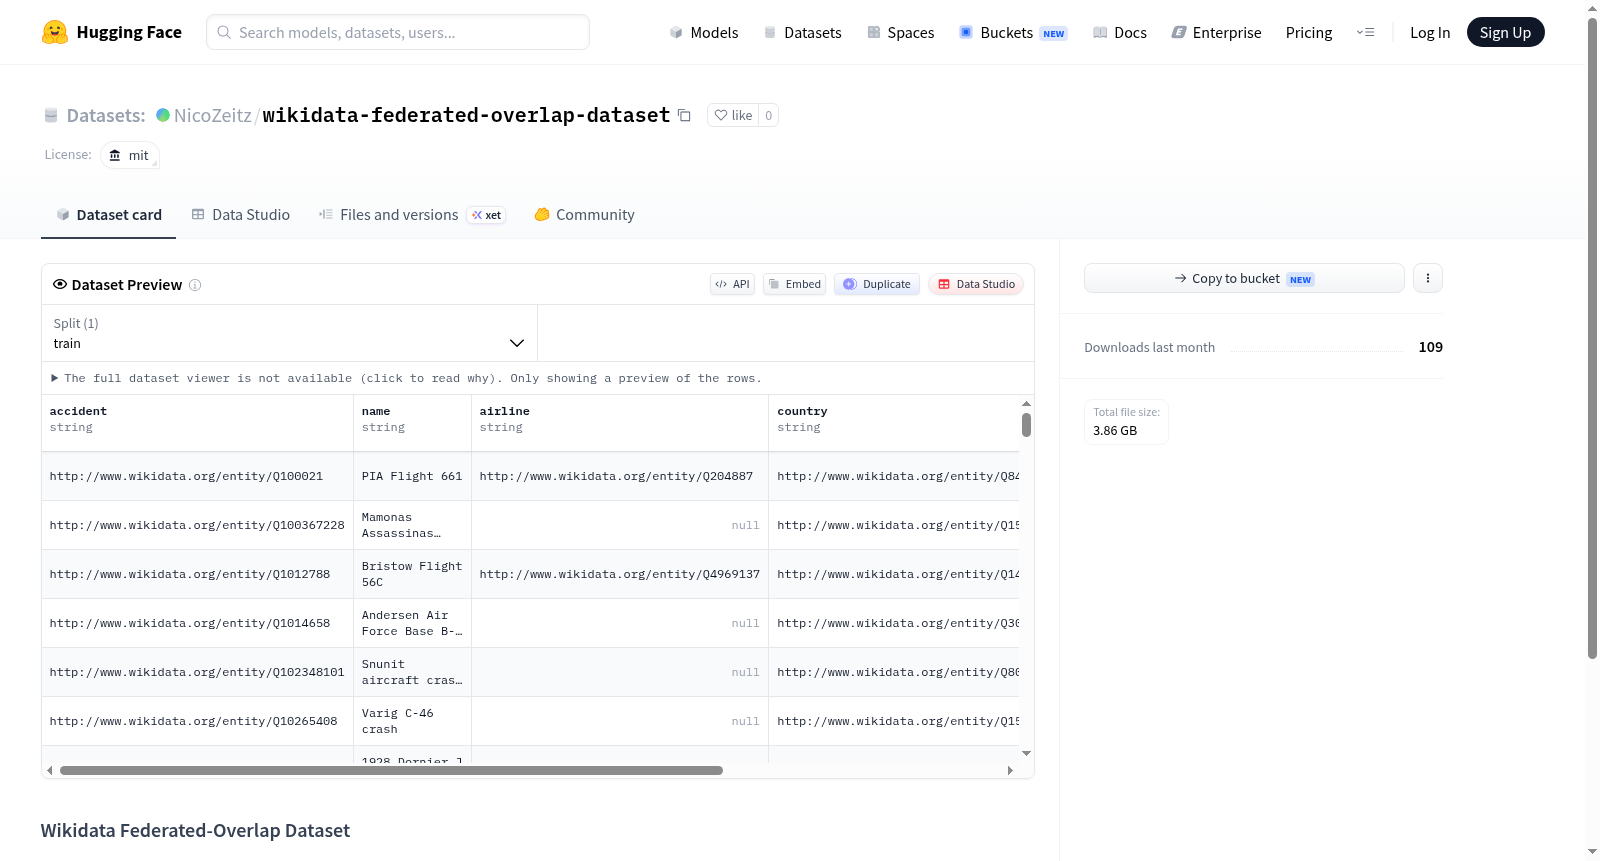
Wikidata Federated-Overlap Dataset 是一个基于 Wikidata 构建的数据集,其设计目的是将数据分布到多个联邦数据库中,并且这些数据库之间存在重叠的分区。该数据集采用 MIT 许可证发布。
Wikidata Federated-Overlap Dataset is a dataset built on Wikidata, designed to distribute data across multiple federated databases with overlapping partitions. It is released under the MIT license.
创建时间:
2026-08-17
原始信息汇总
Wikidata Federated-Overlap Dataset 数据集详情
基本信息
- 许可证:MIT 许可证
- 数据集类型:从 Wikidata 派生的数据集
- 分布方式:跨联邦数据库分布,包含重叠分区
数据特点
该数据集基于 Wikidata 数据构建,其核心特征在于数据被分布到多个联邦数据库中,并且各分区之间存在重叠部分。这种设计主要用于研究或测试联邦学习、分布式数据库查询以及数据去重等相关场景。
相关资源
- GitHub 仓库:更多详细信息请参见 https://github.com/NicoZeitz/wikidata-federated-overlap-dataset
搜集汇总
数据集介绍
构建方式
该数据集源于全球知名的知识图谱Wikidata,通过精心设计的联邦学习架构,将庞大的语义网络数据切分为多个相互关联的数据库分区。每个分区在保留独立完整性的同时,与其他分区存在特定的重叠部分,这种重叠设计旨在模拟真实世界分布式数据环境的复杂性。数据构建过程遵循标准的本体论框架,确保知识表示的准确性与一致性,从而为联邦学习研究提供高度仿真的数据基础。
特点
该数据集的核心特征在于其独特的重叠分区结构,这使其能够真实反映联邦学习场景中数据非独立同分布(Non-IID)的特性。每个数据库分区不仅包含其特有的知识三元组,还共享一部分公共数据,这种设计使得模型训练能够模拟跨域知识融合与冲突消解的挑战。此外,数据集基于Wikidata的真实语义关系,具备丰富的实体类型和关系种类,为评估联邦学习算法的泛化能力与鲁棒性提供了优质的数据支撑。
使用方法
该数据集的使用便捷,支持主流联邦学习框架的直接集成。用户可通过提供的GitHub仓库获取详细的构建脚本与数据加载接口,轻松将数据划分为训练集、验证集与测试集。在进行联邦学习实验时,每个client可被分配至一个数据分区,从而在分布式环境下训练模型,实现知识共享与隐私保护的平衡。该数据集特别适合用于研究联邦学习中的数据异质性、通信效率及模型聚合策略等关键问题。
背景与挑战
背景概述
wikidata-federated-overlap-dataset由Nico Zeitz等人创建,旨在应对知识图谱数据在联邦学习与分布式存储场景下的挑战。该数据集源自Wikidata,通过设计具有重叠分区的联邦数据库结构,模拟真实世界中数据分散且共享部分信息的复杂环境。其核心研究问题在于评估和优化联邦学习算法在知识图谱上的性能,特别是在数据非独立同分布及跨域协作的背景下。这一数据集的发布为联邦知识图谱学习提供了一个标准化的评估平台,促进了相关领域的研究进展,对分布式人工智能和知识工程具有重要的推动意义。
当前挑战
该数据集所解决的领域问题涵盖联邦学习在知识图谱上的数据异构性与隐私保护,其构建过程需处理来自Wikidata的海量三元组,并设计合理的重叠分区策略以模拟真实场景,这涉及数据采样的代表性、联邦一致性维护以及跨节点关联性保持等复杂问题。具体挑战包括:如何确保重叠部分能反映真实世界实体间的多维度关联,而不引入偏差;如何在保持各分区自治性的同时,实现全局知识的有效融合;以及如何提供可扩展的数据结构,以适应不同规模的联邦学习实验需求。这些挑战的妥善处理对于推动联邦知识图谱学习的实证研究具有关键作用。
常用场景
经典使用场景
该数据集基于Wikidata构建,通过模拟联邦数据库环境中数据分区的重叠现象,为联邦查询处理、数据融合及分布式知识图谱推理等研究提供了标准化的评测基准。研究者常利用此数据集验证联邦学习框架在不完全分区场景下的查询效率与准确性,尤其关注跨库实体匹配与结果聚合的鲁棒性。其重叠设计能够有效测试算法对数据冗余和冲突的容忍度,是评估联邦图查询优化策略的理想平台。
衍生相关工作
基于该数据集,衍生出了一系列代表性工作,包括面向重叠分区的联邦查询优化器设计、基于图神经网络的跨库实体分辨率方法,以及分布式知识图谱中的增量更新机制。此外,它催生了针对数据重叠度的自适应分区策略研究和联邦学习下的鲁棒性攻击与防御框架。这些工作不仅深化了人们对联邦数据库动态性管理的理解,也将该数据集确立为评估联邦知识图谱系统性能的参照基准。
数据集最近研究
最新研究方向
该数据集聚焦于联邦数据库环境下重叠分区数据的分布特性,为知识图谱的分布式查询处理与联邦学习研究提供了真实场景基准。近期研究趋势指向利用此类数据集探索跨库实体对齐、稀疏数据补全以及隐私保护下的协同推理,尤其在Wikidata这一全球性多语言知识库中,重叠分区数据的有效管理对提升多源信息融合的准确性和鲁棒性具有重要意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


