
manan-u/Updesh_beta_math
收藏官方服务:
资源简介:
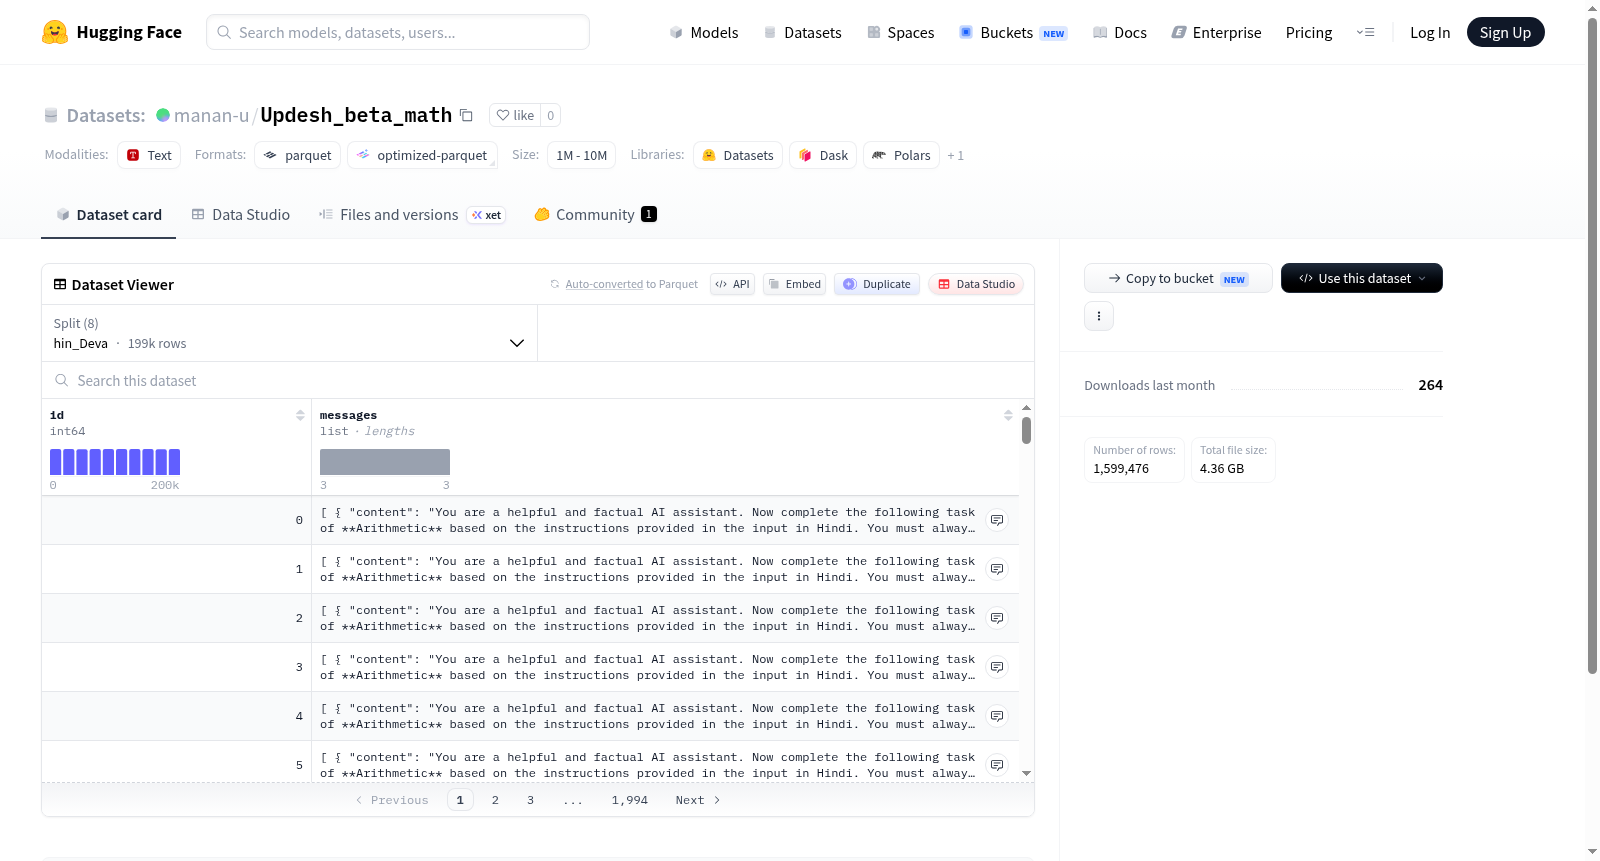
该数据集是一个多语言对话数据集,包含印地语、马拉地语、孟加拉语、阿萨姆语、马拉雅拉姆语、泰米尔语、卡纳达语和英语的对话数据。每条数据包含一个唯一的id和一个messages列表,messages列表中的每条消息包含content(内容)和role(角色)字段。数据集分为多个语言分支,每个分支都有对应的数据文件和统计信息,如字节大小和示例数量。
This dataset is a multilingual conversation dataset containing dialogue data in Hindi, Marathi, Bengali, Assamese, Malayalam, Tamil, Kannada, and English. Each entry includes a unique id and a messages list, where each message in the list contains content and role fields. The dataset is divided into multiple language branches, each with corresponding data files and statistical information such as byte size and number of examples.
提供机构:
manan-u搜集汇总
数据集介绍
构建方式
Updesh_beta_math数据集专为多语言数学推理任务而构建,涵盖八种语言子集,包括印地语、马拉地语、孟加拉语、阿萨姆语、马拉雅拉姆语、泰米尔语、卡纳达语和英语。每个子集均包含约20万条样本,以对话形式组织,每条数据含唯一的标识符和消息序列,消息由角色与内容字段构成。数据集划分清晰,各语言子集独立存储为分片文件,便于按需加载与处理。
使用方法
使用该数据集时,可通过Hugging Face Datasets库加载。指定配置名为'default',并按需选择语言子集,例如加载马拉雅拉姆语数据可使用'split='mal_Mlym''。数据处理时,可提取'messages'字段中的对话内容,用于数学推理任务的训练或评估。对于需要跨语言研究的场景,可依次遍历所有子集,利用统一的数据结构进行便捷的批量处理与模型微调。
背景与挑战
背景概述
在自然语言处理与数学推理的交汇领域,多语言数学数据集成为评估和提升语言模型符号理解与逻辑推导能力的关键资源。Updesh_beta_math数据集由印度语言研究团队于近年构建,涵盖了印地语、马拉地语、孟加拉语、阿萨姆语、马拉雅拉姆语、泰米尔语、卡纳达语以及英语八种语言,聚焦于数学领域的对话式推理任务。该数据集共计约160万条样本,规模宏大,旨在解决低资源印度语种在数学推理任务中训练数据匮乏的问题,为多语言大模型的公平性与泛化性研究提供了坚实的数据基础,对推动南亚地区多语言AI技术的落地具有重要影响力。
当前挑战
该数据集面临的核心挑战在于多语言数学推理的领域难题:不同语种对数学术语的表述差异、数字系统的书写习惯不一,以及语法结构对逻辑表达的影响,均增加了模型跨语言理解与推理的难度。构建过程中,团队需克服低资源语种标注人才稀缺、数学问题形式多样难以统一标注标准,以及确保各语种样本数量与难度均衡的困境。此外,英语样本虽作为参考基准,但其他七种印度语种的token化效率与语义保持亦是技术瓶颈,对最终数据集的可用性形成了严峻考验。
常用场景
经典使用场景
在数学推理与语言多样性的交叉研究领域,Updesh_beta_math数据集以其丰富的多语种数学问答对而著称。该数据集涵盖了印地语、马拉地语、孟加拉语、阿萨姆语、马来亚拉姆语、泰米尔语、卡纳达语以及英语等八种语言,每个语种均包含约20万条精心构建的样本。其最经典的使用场景聚焦于探究多语言环境下数学问题求解能力,研究者常借助此数据集训练和评估大语言模型在跨语言数学推理任务上的泛化表现,从而检验模型是否真正掌握数学逻辑而非仅依赖语言模式。
解决学术问题
该数据集有效应对了多语言人工智能研究中数学推理能力评估匮乏的困境。在过往学术探索中,数学问答资源多以英语为主体,导致非英语语言的模型性能评估存在偏差。Updesh_beta_math的诞生填补了这一空白,使学界能够系统性地探究语言差异对数学推理能力的影响。其意义在于为多语言自然语言处理与数学逻辑推理的融合研究提供了标准化基准,显著推动了跨语言人工智能模型的公平性与鲁棒性评测,助力探索语言无关的数学思维表征。
实际应用
在实际应用层面,Updesh_beta_math展现出广阔的价值。它可直接用于优化多语言教育科技产品,如智能数学辅导系统,使其能够以用户母语提供精准的解题指导。此外,在智能客服、机器翻译等涉及数学内容的场景中,该数据集有助于提升模型对数学表达式的理解与转换能力。对于印度等语言多样性极为丰富的国家和地区,这一资源更是赋能本土化人工智能助手、降低数字鸿沟的关键基础,使数学知识的获取不再受限于语言障碍。
数据集最近研究
最新研究方向
当前,多语言数学数据集Updesh_beta_math的构建与应用正成为自然语言处理领域的前沿热点。该数据集涵盖印地语、马拉地语、孟加拉语、阿萨姆语、马拉雅拉姆语、泰米尔语、卡纳达语及英语八种语言,每个语种均包含约20万条带角色标注的对话样本。这一资源对于推动低资源语言中数学推理能力的提升至关重要,尤其在大型语言模型(LLM)的跨语言泛化研究中具有深远意义。随著印度多语种AI助手和智能教育平台需求的激增,Updesh_beta_math为模型在复杂数学问题上的多语言对齐训练提供了高质量基准,其大规模、均衡语种分布的设计有效缓解了数据稀疏性问题,进而赋能对话系统在数学辅导、学术问答等场景的精准表现,对促进AI技术的普惠性与包容性产生了积极影响。
以上内容由遇见数据集搜集并总结生成


