
遇见数据集

immortal3/wordmaze

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

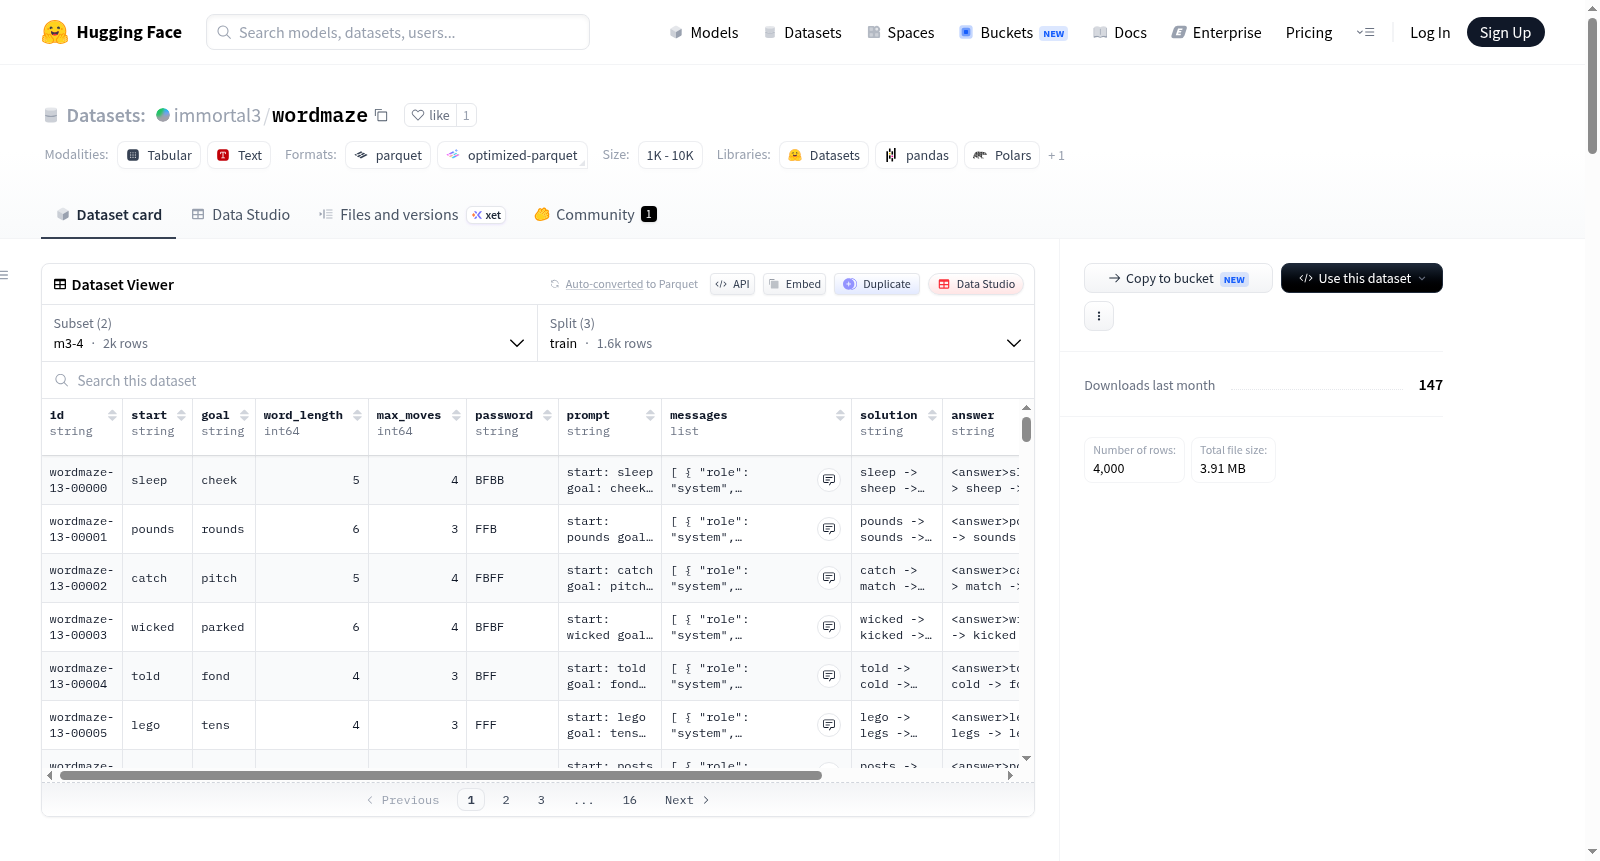
Wordmaze是一个合成单词梯子谜题数据集,专为强化学习实验(特别是小语言模型上的GRPO)设计,旨在提供一种一次尝试、易于评分且需要较多规划的任务。每个数据行包含一个谜题及其已知解决方案路径,无需人工标注即可用于训练或评估。谜题规则包括:从起始词开始,每次改变恰好一个字母,所有单词必须是给定长度的真实英语单词,在恰好max_moves步内到达目标词,并匹配密码模式(密码由字母变化方向F(向前)或B(向后)组成)。数据集包含两个配置:m3-4(单词长度3-4,步数3-4)和m4-6(单词长度4-6,步数4-6),每个配置有2,000个示例,分割为训练集(1,600)、验证集(200)和测试集(200)。字段包括id、start、goal、word_length、max_moves、password、prompt、messages、solution、answer、path和num_moves。数据集基于wordfreq英语前10,000个词条生成,排除专有名词,通过随机游走在单词图中采样路径。适用于约束遵循基准测试、基于验证器的强化学习训练以及符号约束跟踪研究。注意:词典有限,密码约束可能对应多个解,难度随单词长度增加,且内容为结构化提示而非自然语言故事。

Wordmaze is a synthetic word-ladder puzzle dataset with an extra password constraint, built for RL experiments (GRPO on small LMs) to offer a one shot, easy to grade task that requires more planning. Each row contains a puzzle and a known solution path, enabling training or evaluation without human labels. The puzzle involves changing exactly one letter per step, using real English words of a given length, reaching the goal in exactly max_moves steps, and matching a password pattern (composed of F for forward or B for backward letter changes). The dataset includes two configurations: m3-4 (word lengths 3-4, moves 3-4) and m4-6 (word lengths 4-6, moves 4-6), each with 2,000 examples split into train (1,600), validation (200), and test (200). Fields include id, start, goal, word_length, max_moves, password, prompt, messages, solution, answer, path, and num_moves. It is generated from wordfreqs top 10,000 English lemmas (excluding proper nouns) by sampling random walks on a word graph. Suitable for benchmarking constraint-following, verifier-based RL training, and studying symbolic constraint tracking. Limitations: limited dictionary, non-unique solutions, variable difficulty by word length, and structured prompts only (no natural language).

提供机构:
immortal3
搜集汇总
数据集介绍
immortal3/wordmaze 数据集图片
构建方式
Wordmaze数据集的构建依托于wordfreq词频库中排名前10,000的英文词汇,经过去除专有名词等预处理后,按指定词长构建无向图——图中相邻节点仅相差一个字母。通过随机采样指定长度的无重复简单路径,从路径中推导出起始词、目标词与密码模式(即每一步字母变动的方向序列:前进记作F,后退记作B)。随后对(起始词, 目标词, 密码, 词长, 步数)进行去重,打乱后按80%、10%、10%划分为训练集、验证集与测试集,生成共计2000条样本。
特点
该数据集的核心特色在于引入了密码约束作为额外的符号化规则:模型需在逐字转换路径中精准匹配预定义的F/B序列,这使其有别于经典的字梯谜题。每个样本均附带完整参考答案、结构化消息格式以及严格的验证器,便于自动化评分。数据覆盖4至6字母长度的单词,路径步数可调(4至6步),各组合均衡分布。生成过程完全可复现(种子42),且提供了无删减的词表,研究者可根据需要自行过滤敏感内容。
使用方法
Wordmaze设计用于强化学习和指令微调场景,尤适合GRPO等依赖可验证奖励的算法。加载时可通过Hugging Face datasets库直接调用,或从本地JSONL文件读入。模型输入可采用系统提示与用户查询结合的messages字段,输出需严格遵循<answer>词1 -> 词2 -> ... -> 词n</answer>格式。评估时可依据起始词、目标词、密码、词长和步数五个约束对路径进行逐项检查,生成二元或分步奖励信号。附带的参考评分器(grading.py)支持格式验证、词典匹配和密码校对。
背景与挑战
背景概述
Wordmaze数据集诞生于大型语言模型在符号推理与约束满足能力评估需求日益增长的背景下,由独立研究者于近期的强化学习实验中创建,专注于词梯谜题的变体。其核心研究问题在于探索模型如何在遵循精确字母变更步数、单词合法性及密码模式(记录每次变更中字母在字母表上前进或后退的方向)等多重约束下,规划并生成一条从起始词到目标词的有效路径。该数据集通过引入密码约束,为评估模型跟踪符号性边条件的能力提供了新范式,对研究小型指令模型在结构化图搜索中的规划行为具有重要启发意义。
当前挑战
该数据集所应对的领域挑战在于,传统语言基准大多聚焦于自然语言理解或生成,而Wordmaze则要求模型在离散符号空间中执行多重约束的路径规划,考验其组合推理与符号模式记忆能力。构建过程中,生成算法需从词汇图中随机采样特定长度的简单路径,并确保每条路径对应的密码模式唯一化,这在高维稀疏图(如六字符词图)中常遭遇死胡同,导致采样效率低下。此外,词汇来源基于词频列表而未经严格审查,可能引入不当词语,需使用者额外过滤,构成了数据质量控制上的另一重挑战。
常用场景
经典使用场景
Wordmaze数据集专为评估和训练语言模型的规划与约束遵循能力而设计,其核心任务是一种受密码约束的词梯谜题。模型需要从起始词出发,每步仅改变一个字母,在恰好规定的步数内抵达目标词,且每一步字母变化的字母表方向必须与预设的密码模式完全一致。该经典场景完美融合了词汇搜索、路径规划和符号约束跟踪,为探究小型指令模型的推理深度提供了理想的试验场。
实际应用
在实际应用中,Wordmaze数据集主要服务于基于强化学习的语言模型训练与评估,尤其适用于GRPO和RLVR等可验证奖励的算法框架。开发者可以直接利用数据集中预设的起始词、目标词和密码约束,构建严格的二进制奖励函数,无需人工标注即可实现大规模训练。此外,该数据集还可作为小模型在低资源条件下的规划能力筛选基准,为教育类AI和逻辑推理应用的模型选型提供可靠参考。
衍生相关工作
围绕Wordmaze数据集的特性,衍生了一系列专注于符号约束推理的经典工作方向。研究者借鉴其密码验证机制,开发了多步推理过程的梯度奖励分配策略,推动了可解释路径追踪方法的发展。同时,该数据集激发了在稀疏图环境下强化学习探索效率的研究,促进了诸如课程学习和结构化的回放机制等算法的改进。此外,单词空间搜索与外部知识库结合的方法也受益于Wordmaze提供的清晰反馈信号,为神经符号融合领域带来了新的实验范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

