baulab/openai-comic-strips
收藏资源简介:
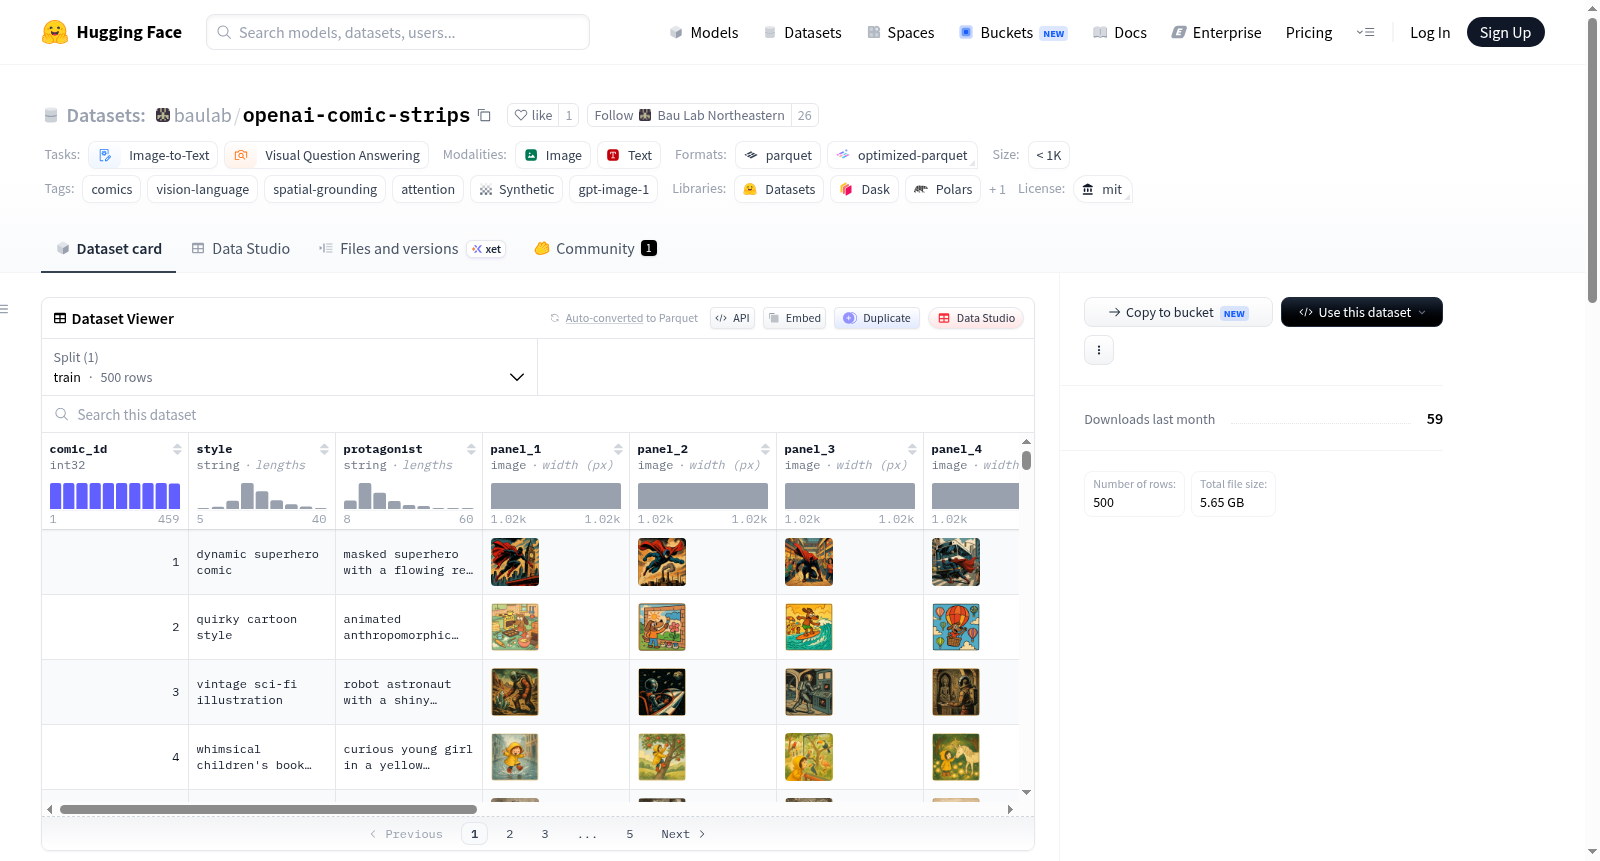
OpenAI漫画条数据集包含500个六面板漫画条(共3,000张图像),由OpenAI的gpt-image-1生成,每个条配有结构化元数据:艺术风格、一个重复出现的主角以及每个面板的一句话标题。该数据集旨在研究视觉语言模型中的空间基础,特别是模型注意力如何跟踪多面板图像中当前描述的面板。由于每个条以六个离散面板布局,并已知每个面板的内容,因此为面板级视觉问答和注意力重定向实验提供了清晰、可控的监督。数据集结构包括每行一个漫画条,字段包括comic_id(唯一ID)、style(艺术风格)、protagonist(主角描述)、panel_1到panel_6(1024x1024图像)和caption_1到caption_6(每个面板的标题)。
500 six-panel comic strips (3,000 images) generated with OpenAIs gpt-image-1, each paired with structured metadata: an art style, a recurring protagonist, and a one-sentence caption for every panel. The dataset was built to study spatial grounding in vision-language models: specifically, how a VLMs attention tracks which panel of a multi-panel image it is currently describing. Because each strip is laid out as six discrete panels with known per-panel content, it provides clean, controllable supervision for panel-level visual question answering and attention-redirection experiments.