
遇见数据集

kivi-1.5b-veri

收藏
Hugging Face2026-10-11 更新2026-10-12 收录
官方服务:

资源简介:

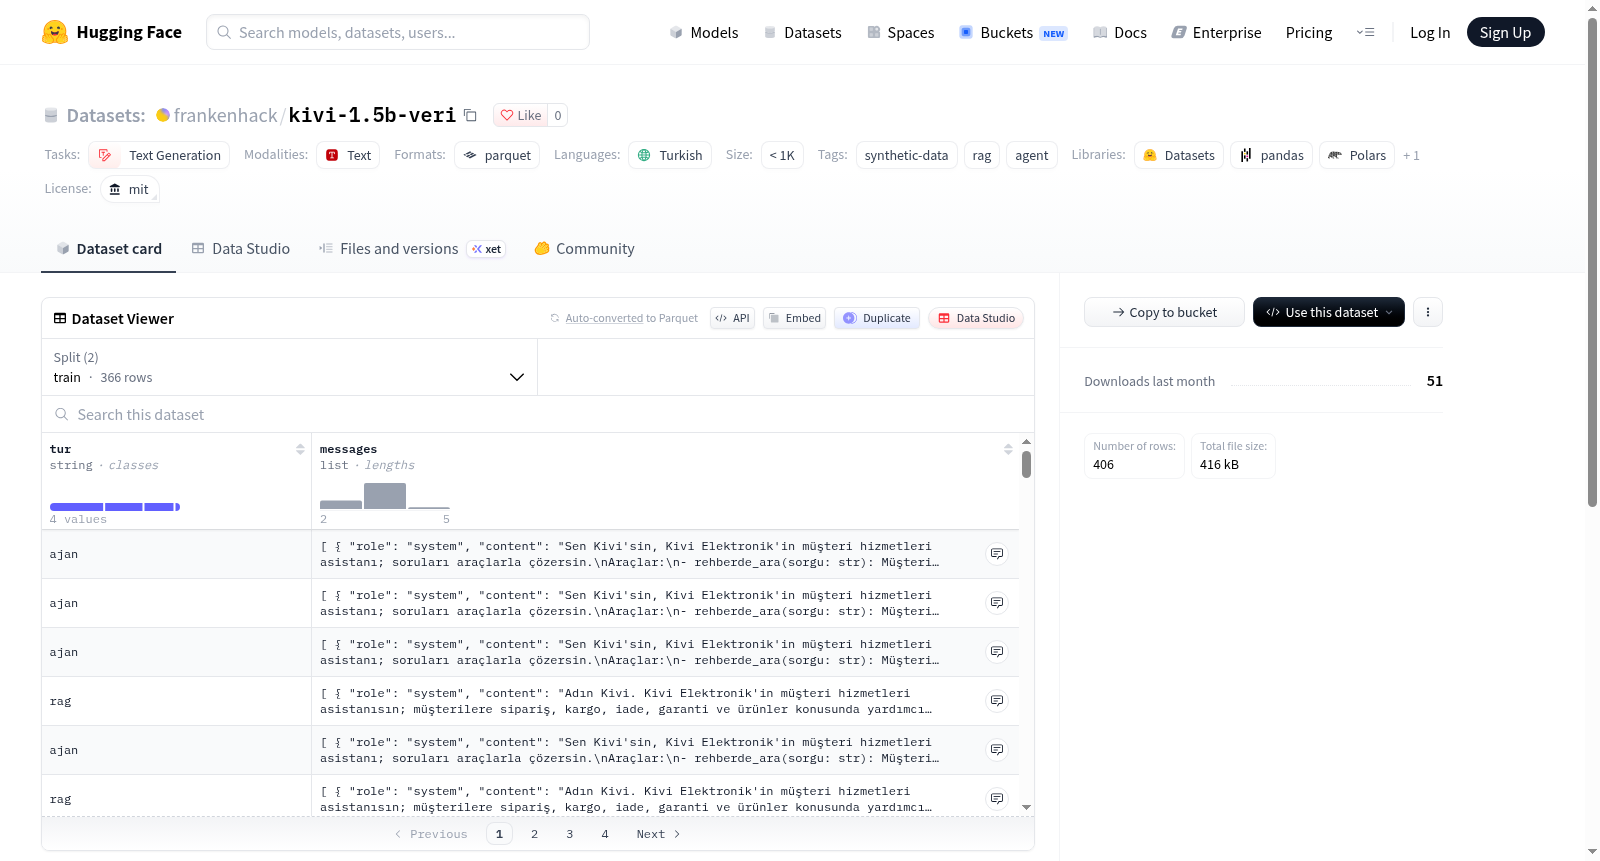
Kivi Elektronik Sentetik Eğitim ve Test Veri Seti(Kivi Elektronik 合成训练与测试数据集)是一个土耳其语合成文本生成数据集,采用 MIT 许可证,语言标记为 tr,标签包括 synthetic-data、rag 和 agent。该数据集在 Tech Istanbul 人工智能训练营毕业项目范围内创建,目的是微调 Qwen/Qwen2.5-1.5B-Instruct 模型。数据集共有 406 个样本,其中 366 个用于训练,40 个用于测试。样本类型包括约 99 个身份与风格对话、约 168 个基于指南的 RAG 示例、约 120 个单轮 ReAct 工具调用示例,以及约 19 个两轮观察与最终回答示例。数据内容围绕虚构的 Kivi Elektronik 客户服务场景组织,适用于文本生成、RAG、Agent/ReAct 工具调用等训练与测试任务。

Kivi Elektronik Synthetic Training and Test Dataset is a Turkish synthetic text generation dataset under the MIT license, with language tag tr and tags including synthetic-data, rag, and agent. It was created within the scope of the Tech Istanbul Artificial Intelligence Bootcamp graduation project, with the purpose of fine-tuning the Qwen/Qwen2.5-1.5B-Instruct model. The dataset contains 406 samples, with 366 used for training and 40 for testing. Sample types include about 99 identity and style dialogues, about 168 guideline-based RAG examples, about 120 single-turn ReAct tool-calling examples, and about 19 two-turn observation and final answer examples. The content is organized around a fictional Kivi Elektronik customer service scenario and is suitable for training and testing tasks such as text generation, RAG, and Agent/ReAct tool calling.
创建时间:
2026-10-11
搜集汇总
数据集介绍
kivi-1.5b-veri 数据集图片
构建方式
面向土耳其语客户服务场景的合成语料构建,源自Tech Istanbul Yapay Zekâ Bootcamp毕业项目,并以Qwen/Qwen2.5-1.5B-Instruct为基座模型生成监督微调与测试数据。数据围绕虚构企业Kivi Elektronik客户服务流程组织,涵盖身份与语体对话约99条、指南型RAG样本约168条、单轮ReAct工具调用约120条以及两轮观测与最终答复约19条。全库共406条,划分为366条训练样本与40条测试样本,旨在支持对话风格适配、检索增强推理与工具调用行为的联合训练,并为领域泛化评估保留独立测试集。
使用方法
该数据集主要用于Qwen/Qwen2.5-1.5B-Instruct等生成式语言模型的监督微调与领域适配。使用时可依据文本生成格式加载366条训练样本,围绕客户服务身份对话、RAG上下文应答、ReAct工具调用轨迹及两轮观测回复分别设计训练目标。40条测试样本适合作为留出集,评估模型在土耳其语客户服务场景中的响应质量、检索利用与工具决策能力。鉴于采用MIT许可,研究者可在标注来源的前提下将其用于学术与工程实验,并注意其合成属性带来的分布边界。
背景与挑战
背景概述
在土耳其语客户服务智能化与轻量级语言模型适配需求渐增的背景下,kivi-1.5b-veri 数据集诞生于 Tech Istanbul Yapay Zekâ Bootcamp Bitirme Projesi 项目周期内,旨在为 Qwen/Qwen2.5-1.5B-Instruct 模型的微调提供合成训练与测试语料。其建设主体为 Tech Istanbul 人工智能训练营,并围绕虚构的 Kivi Elektronik 客户服务实体展开。核心研究问题聚焦于:在土耳其语低资源场景中,如何借助身份与风格对话、指南驱动的 RAG 示例、单轮 ReAct 工具调用以及两轮观察与最终回答样本,使小参数模型习得客户服务所需的角色一致性、检索增强生成与代理式交互能力。数据集共含 406 条样本,其中训练集 366 条、测试集 40 条,为土耳其语智能客服与合成数据研究提供了可复用的实验基材。
当前挑战
面向土耳其语客户服务中的检索增强生成与代理式工具调用,该数据集所涉领域问题体现为:小参数模型需在有限样本下同时掌握身份风格维持、指南依据回答、ReAct 格式工具调用、观察信息整合与最终答复生成,且需兼顾土耳其语语用特征与多轮状态追踪。构建过程中的挑战亦十分显著,包括合成对话的身份与语气一致性、RAG 示例中指南与答案的事实对齐、工具调用参数与轮次结构的准确性、两轮观察与最终回答样本仅约 19 条所带来的类别不均衡、训练集与测试集划分对真实泛化能力的代表性,以及抑制模板化、幻觉与数据泄漏等问题。这些挑战共同决定了该数据集在微调评测中的价值边界与改进方向。
常用场景
经典使用场景
在土耳其语垂直领域对话系统与参数高效微调交汇处,kivi-1.5b-veri以合成客户服务语料为基座,经典用途在于对Qwen/Qwen2.5-1.5B-Instruct进行监督微调与测试。数据集覆盖身份和风格对话、指南驱动的RAG样例、单轮ReAct工具调用以及两轮观察与最终应答,共406条,其中366条用于训练、40条用于测试。模型借此学习在虚构Kivi Elektronik客服情境中保持统一人设、依据检索文档作答,并在需要时触发工具调用。该场景强调小参数模型在低资源土耳其语环境中的指令遵循、检索增强生成与轻量智能体行为,因而成为客服对话适配和智能体能力评测的典型用例。
解决学术问题
面向低资源语言与特定行业对话建模时,学术研究常受制于高质量标注数据稀缺、合成数据可信度不足,以及小型语言模型在RAG与ReAct任务中的协同表现难以评估。kivi-1.5b-veri以土耳其语客户服务为切口,将身份风格、检索指南、工具调用与多轮观察应答整合为可微调、可测试的资源,为研究合成数据驱动的领域适配提供了受控样本。其意义在于降低土耳其语客服智能体研究的准入门槛,支持比较指令微调、检索增强和工具使用策略,并为小参数模型在真实产业约束下的能力边界提供实证依据,推动低资源语言NLP与可复现智能体研究的发展。
实际应用
在电子零售与客户服务自动化实践中,该数据集可直接服务于土耳其语虚拟客服助手的开发与验证。基于它微调的模型能够处理客户身份问询、品牌语气维护、产品指南检索、订单或故障相关工具调用,并整合观察结果生成最终答复。对于资源有限的团队,Qwen/Qwen2.5-1.5B-Instruct的小尺寸特性与合成数据的低成本优势相结合,有利于快速迭代本地化客服机器人。该数据集还可用于回归测试、提示工程评估和RAG流水线调优,帮助企业在不依赖大规模人工标注的前提下,构建具备检索依据和工具执行能力的对话系统,提升响应一致性与任务完成率。
数据集最近研究
最新研究方向
在低资源语言智能体与企业级客户服务自动化交汇的前沿,kivi-1.5b-veri 的最新研究趋向于以合成数据驱动轻量指令模型的领域适配与工具增强。该数据集围绕土耳其语虚构客服场景,融合身份与风格对话、指南检索增强生成、单轮 ReAct 工具调用及双轮观察与最终回复轨迹,为 Qwen2.5-1.5B-Instruct 等小规模模型提供细粒度监督。相关热点包括检索增强生成与智能体工具学习在客服中的落地,以及合成数据对标注稀缺语言的补足。其意义在于构建可复现的土耳其语 RAG 与 Agent 评测资源,推动低资源语言下多轮工具调用、观察整合与风格一致性的研究,并为企业客服自动化提供轻量级微调范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

