
BSC-LT/XitXatTools
收藏官方服务:
资源简介:
XitXat Tools 是一个包含模拟加泰罗尼亚语呼叫中心对话的数据集。每个对话都标注有结构化的工具调用,使其适用于训练和评估具有函数调用能力的语言模型。
XitXat Tools is a dataset comprising simulated Catalan call center conversations. Each conversation is annotated with structured tool calls, making it suitable for training and evaluating language models with function-calling capabilities.
提供机构:
BSC-LT搜集汇总
数据集介绍
构建方式
XitXatTools数据集基于2022年开发的XitXat语料库构建而成,该语料库通过Wizard of Oz方法模拟了加泰罗尼亚语呼叫中心对话,涵盖十个不同领域共计950段人机交互记录。原始数据集中每段对话均标注了意图与槽位信息,研究团队利用DeepSeek V3模型将这些标注转化为标准化的函数调用结构,从而生成适用于工具调用场景的训练数据。经过DeepSeek的二次验证机制,确保对话中代理获取的所有关键信息均源自函数调用,最终形成容量不足千条的高质量JSON Lines格式数据集。
特点
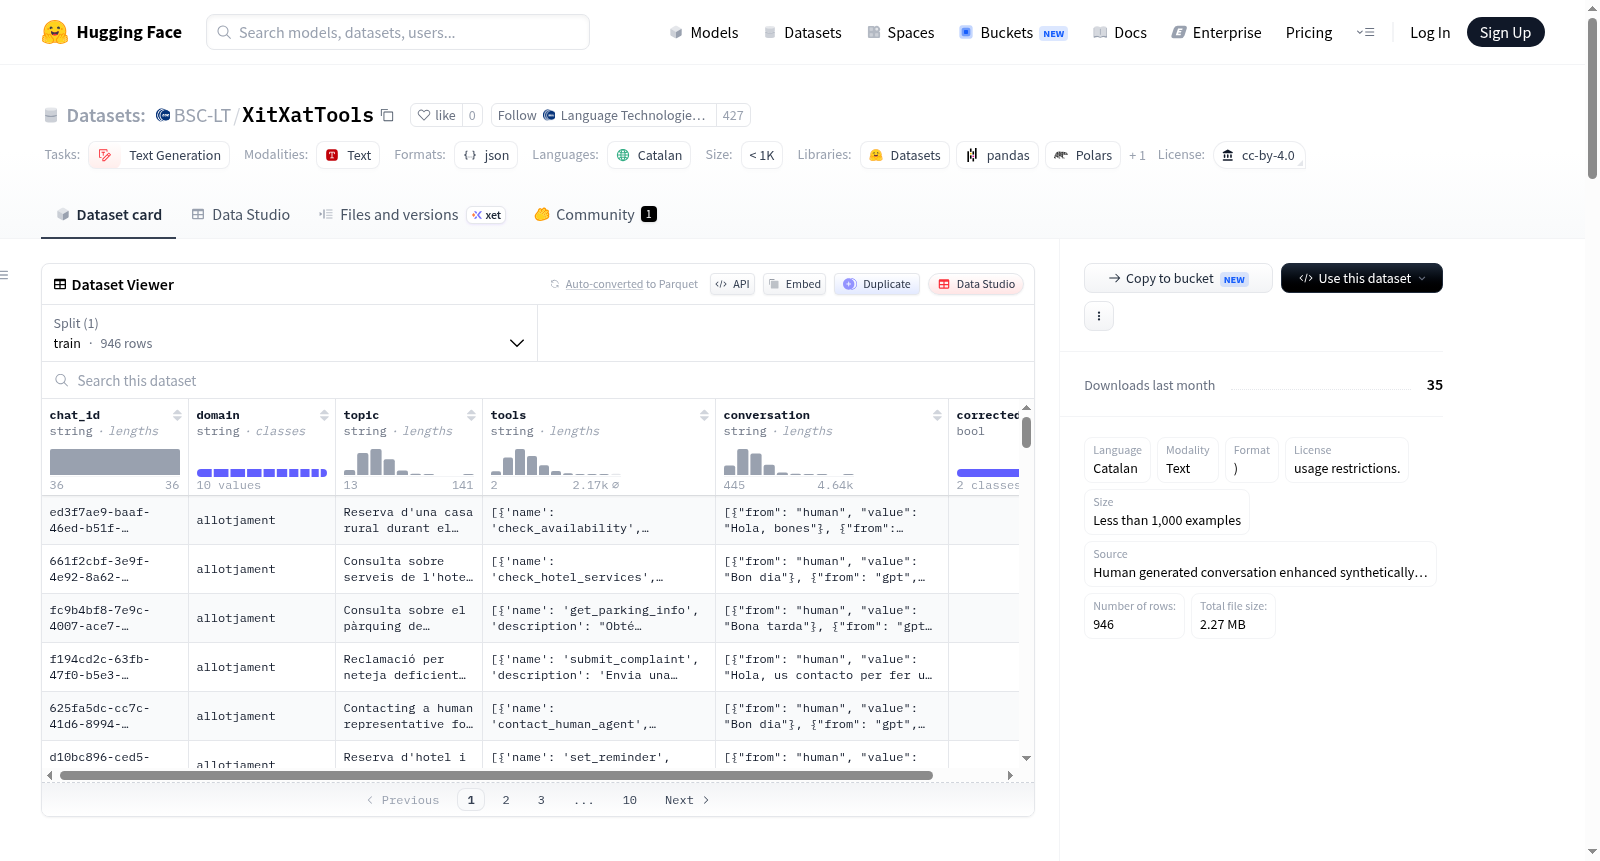
该数据集以结构化工具调用为核心特色,每条记录包含唯一对话标识符、领域标签、主题描述及详细的工具定义列表。每个工具模块均明确声明名称、功能描述以及参数规范,参数对象严格定义了属性类型、格式约束与必需字段。对话内容采用JSON字符串形式存储,完整呈现人类与代理之间的自然语言交互轮次。数据覆盖住宿、银行、保险、市政服务等十个实际业务场景,为训练语言模型的函数调用能力提供了领域多样化的加泰罗尼亚语资源。
使用方法
研究者可通过HuggingFace datasets库直接加载该数据集,使用load_dataset("BSC-LT/XitXatTools", name="default")即可获取默认配置。数据适用于训练具有函数调用能力的大语言模型,开发能够与结构化工具交互的对话代理系统,以及开展多语言和特定领域对话系统的学术研究。数据集采用CC BY 4.0许可协议,同时需遵守DeepSeek模型的使用限制,确保研究应用的合规性。
背景与挑战
背景概述
XitXatTools数据集由巴塞罗那超级计算中心(BSC)的语言技术团队于2024年创建,旨在推动加泰罗尼亚语对话系统与结构化工具交互的能力。该数据集基于2022年开发的XitXat(Wizard of Oz范式下的意图检测对话语料库),通过DeepSeek V3模型将950段涵盖10个领域(如银行、交通、医疗等)的模拟客服对话转化为带函数调用标注的格式。每个对话实例包含工具名称、描述及参数架构,为低资源语言的模型训练提供了关键资源,填补了加泰罗尼亚语在工具调用领域的空白,对多语言对话AI的研究具有重要推动作用。
当前挑战
该数据集面临的核心挑战在于模拟对话的真实性局限:尽管采用Wizard of Oz方法构建,但用户交互场景仍为人工设计,可能无法完全反映真实客服对话中的复杂语境与意外情况。其次,函数调用标注依赖DeepSeek V3的自动转换,虽经二次审核,仍可能存在工具调用逻辑与自然语言映射的偏差,尤其在参数依赖和槽位填充的精确性上。此外,不足千条的样本规模限制了模型对多样化查询的泛化能力,且CC BY 4.0协议结合DeepSeek特定使用条款的许可双重性,为研究和商业应用增加了额外的合规成本。
常用场景
经典使用场景
在加泰罗尼亚语自然语言处理的研究版图中,XitXatTools数据集以其独特的模拟客服对话与结构化工具调用标注而备受瞩目。该数据集源自经典的XitXat对话语料,经由DeepSeek模型将原始的用户意图与语义槽信息转化为精细的函数调用格式,构建出一套包含十个领域、近千条对话的高质量样本。其最经典的使用场景在于训练和评估具备函数调用能力的大语言模型,使模型能够在复杂的客服对话中准确理解用户需求并调用相应的API工具,例如查询民宿可用性、办理银行业务或预订车辆。这不仅为加泰罗尼亚语的多轮对话系统注入了新的训练资源,更为低资源语言的工具增强型AI研究提供了可复现的基准数据。
衍生相关工作
XitXatTools数据集的出现催生了一系列围绕低资源语言工具调用和对话系统增强的衍生研究。其中,BSC语言技术团队以此为基础,进一步探索了利用大型语言模型进行数据增强与课程学习的方法,旨在提升模型在少样本情况下的泛化能力。与此同时,该数据集也被用于评测DeepSeek、Llama等开源大模型在非英语环境下的函数调用准确性,推动了跨语言工具使用能力的基准评测发展。此外,受XitXatTools启发,部分研究者开始在类似框架下将语义解析与工具调用序列进行端到端联合建模,探索意图转化过程中的错误传播与纠错机制。这些衍工作不仅拓展了函数调用数据集的设计范式,也为今后构建更通用、更鲁棒的多语言智能助手提供了重要参考。
数据集最近研究
最新研究方向
XitXatTools数据集聚焦于加泰兰语对话系统中函数调用能力的训练与评估,其前沿研究方向在于将结构化工具调用嵌入多领域对话交互。该数据集通过模拟呼叫中心场景,结合Wizard of Oz方法生成的原始对话与DeepSeek V3的合成增强,构建了包含工具名称、参数与调用链的标注样本。这一工作顺应了大型语言模型在任务导向型对话中集成外部API和知识库的热点趋势,尤其为低资源语言的函数调用能力提升提供了稀缺资源。其意义在于推动对话式AI的可操作性与跨语言迁移,例如在金融服务、住宿预订等领域的实际部署,同时为研究者探索模型对结构化指令的泛化能力奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


