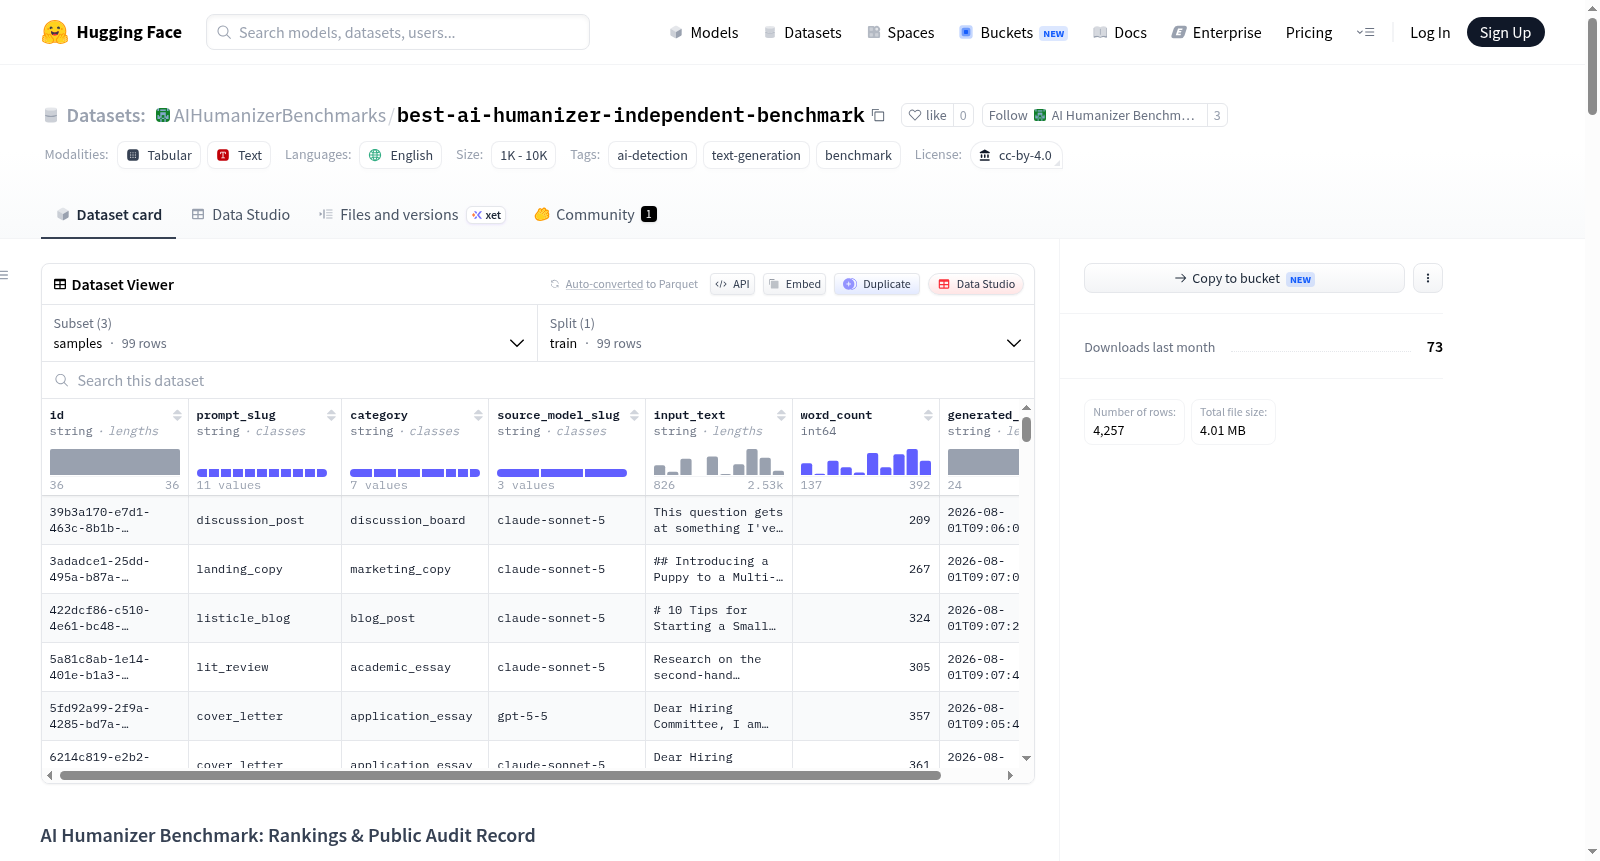
best-ai-humanizer-independent-benchmark
收藏资源简介:
该数据集是 AI Humanizer Benchmark(AI 文本人性化工具基准测试)的公开记录,每月更新,旨在客观评估和排名不同 AI 人性化工具在绕过主流 AI 检测器(包括 GPTZero、Originality.ai、Copyleaks、Winston AI 和 ZeroGPT)的同时保持原始文本含义和可读性的能力。数据集包含每个测试周期的完整透明数据:源样本(输入文本)、每个工具的人性化输出、所有五个检测器对每个输出的判决、以及用于计算综合评分的冻结评分算法。每个周期还包括承诺-揭示机制(commit-reveal scheme)文件,用于验证提示的不可预测性。数据存储为 JSON 格式,位于 data/cycles/ 目录下,每个周期包含 samples.json、tests.json、detector-scores.json、scoring.js 等文件。此外,data/humanizers/ 目录下包含每个工具的历史记录和评分细节。数据集适用于 AI 检测规避、文本生成质量评估、基准测试以及可重现性验证等任务。
This dataset is a public record of the AI Humanizer Benchmark, updated monthly, designed to objectively evaluate and rank different AI humanization tools in their ability to bypass mainstream AI detectors (including GPTZero, Originality.ai, Copyleaks, Winston AI, and ZeroGPT) while preserving the original text meaning and readability. The dataset includes complete transparent data for each test cycle: source samples (input text), humanized outputs from each tool, judgments from all five detectors on each output, and frozen scoring algorithms used to compute composite scores. Each cycle also includes commit-reveal scheme files to verify the unpredictability of prompts. Data is stored in JSON format under the data/cycles/ directory, with each cycle containing files such as samples.json, tests.json, detector-scores.json, scoring.js, etc. Additionally, the data/humanizers/ directory contains historical records and scoring details for each tool. The dataset is suitable for tasks such as AI detection evasion, text generation quality assessment, benchmarking, and reproducibility verification.
数据集概述
该数据集是一个独立基准测试的公开记录,旨在按月评估和排名各种AI人性化工具绕过主流AI检测器的能力。
评测范围与核心指标
- 检测器覆盖:评测针对5款主流AI检测器,包括GPTZero、Originality.ai、Copyleaks、Winston AI和ZeroGPT。
- 综合评分维度:总分100分,由四个子项加权构成:检测器绕过率(权重42%)、语义保留度(权重32%)、可读性(权重16%)、跨写作类别一致性(权重10%)。
- 惩罚机制:工具在语义偏离、长度膨胀(>1.4×原文)、长度缩减(<0.6×原文)、拒绝输出及输出未修改等质量失败情况下会被扣分(每类别最高扣10分),扣分已反映在综合评分中。
评测方法与透明度
- 操作方式:数据集的创建者自费购买每个工具的访问权限,并手动在工具宣传的“最不易检测”设置下运行每个工具,不涉及任何联盟合作或厂商提供数据。
- 数据公开:每次评测的输入文本、每个工具的输出、每个检测器的判定结果以及评分代码均完整发布在存储库中,任何人可以从零开始复现排名结果。
- 防篡改机制:采用“提交-揭示”方案,即周期开始前仅公开随机nonce的SHA-256哈希,周期结束后公布nonce本身,并运行5项独立校验(哈希承诺、算法重放、替换匹配、清单完整性、评分重放)以确保数据链条未被篡改。验证脚本已接入CI,任何对main分支的推送都会运行验证并将失败作为构建失败。
测试样本与类别
每个评测周期从7个写作类别(学术论文、申请文书、博客文章、商务邮件、讨论区帖子、营销文案、新闻文章)的11个提示模板中生成源样本,每个模板生成3个样本。
最近评测结果(2026年9月)
| 排名 | 工具 | 综合得分/100 | 绕过率 | 语义保留 | 可读性 |
|---|---|---|---|---|---|
| 1 | GPTHuman AI | 88.28 | 94% | 77% | 91% |
| 2 | Undetectable.ai | 82.53 | 82% | 87% | 69% |
| 3 | WriteHuman | 76.60 | 84% | 66% | 77% |
| 4 | NoteGPT | 69.79 | 88% | 60% | 78% |
| 5 | ZeroGPT Humanizer | 65.35 | 76% | 66% | 45% |
| 6 | UnAIMyText | 60.64 | 72% | 56% | 42% |
| 7 | HIX Bypass | 52.42 | 70% | 47% | 39% |
数据文件结构
存储库包含两个主要目录:
data/cycles/:每个已发布周期的文件,包括透明性捆绑包(nonce、提示模板、价值库、选择算法等)和可复现性捆绑包(样本、测试输出、检测器评分、冻结的计分算法以及最终排行榜)。data/humanizers/:每个工具跨周期的历史记录和现场笔记。
许可与争议处理
- 许可证:验证代码、工作流和配置采用MIT许可证;
data/目录下的周期数据采用CC BY 4.0许可证,允许在注明出处的情况下复制。 - 勘误与争议:若发现周期评分错误、工具记录过期或验证失败等问题,可通过GitHub问题追踪器报告,维护者承诺在一个周期内回应。