
BioLaySumm/BioLaySumm2025-LaymanRRG-opensource-track
收藏官方服务:
资源简介:
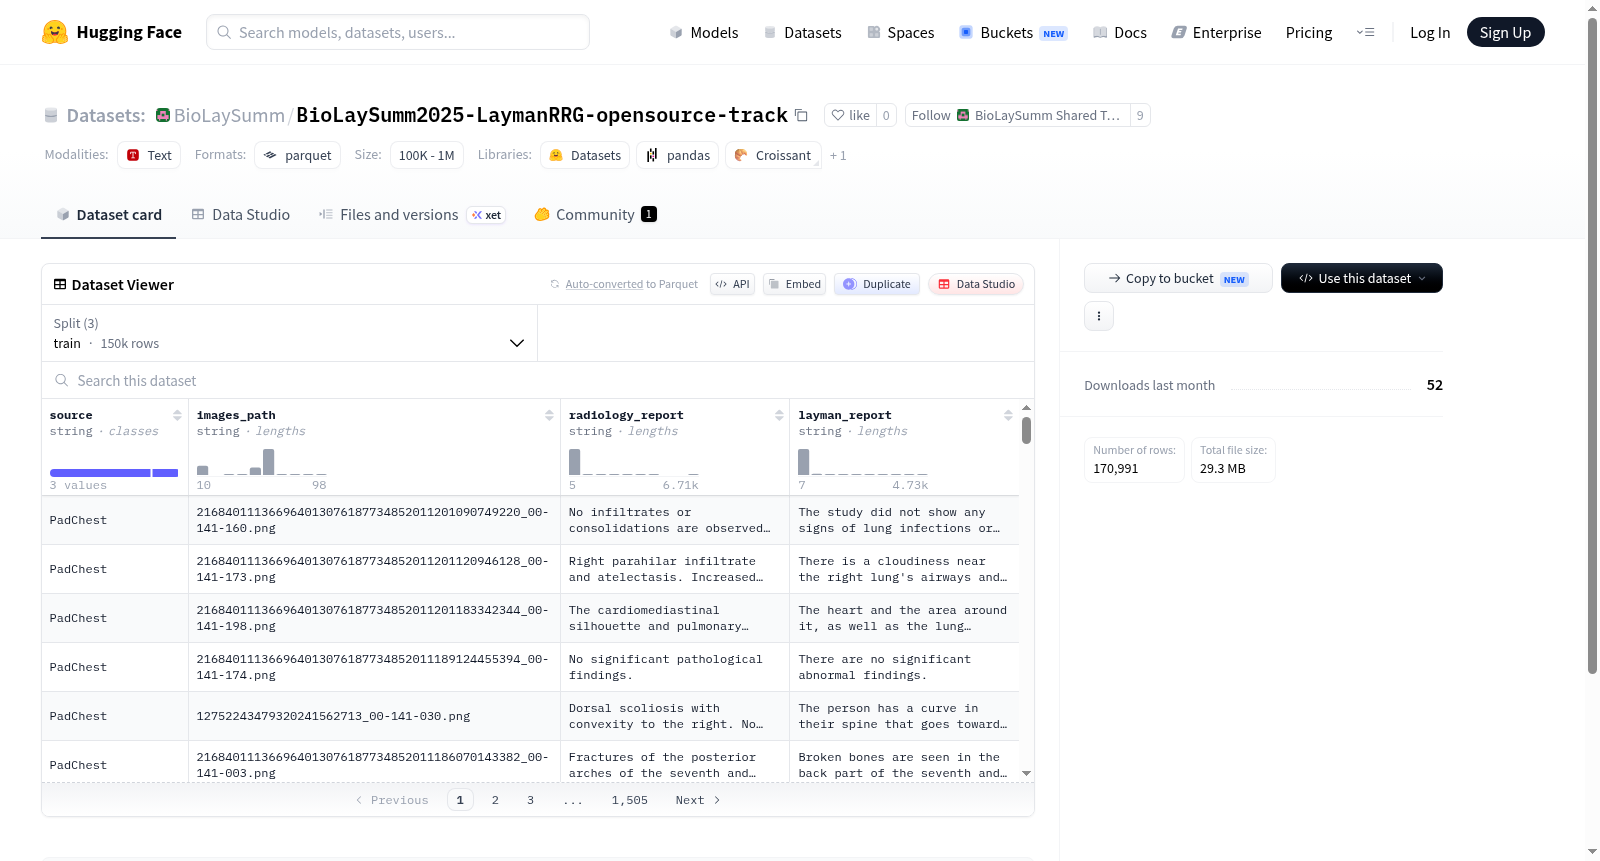
该数据集包含了医学影像的来源信息、影像路径、放射学报告和通俗报告。数据集分为训练集、验证集和测试集三个部分,分别用于机器学习的训练、验证和测试。每个部分包含的示例数量和大小都有详细的记录。
The dataset includes information on the source of medical images, image paths, radiology reports, and layman reports. The dataset is divided into three parts: training set, validation set, and test set, which are used for machine learning training, validation, and testing respectively. The number of examples and size of each part are recorded in detail.
提供机构:
BioLaySumm搜集汇总
数据集介绍
构建方式
在生物医学文本挖掘与自然语言处理交叉领域中,面向放射学报告的可读性提升与患者沟通优化已成为重要研究方向。BioLaySumm/BioLaySumm2025-LaymanRRG-opensource-track数据集应运而生,其构建过程严谨而系统。该数据集以大规模放射学报告为核心,每份样本均包含原始专业报告(radiology_report)及其对应的通俗语言改写版本(layman_report),并额外提供源文本(source)与图像路径(images_path)以支持多模态分析。数据划分上,训练集包含150454个样本,验证集与测试集分别包含10000和10537个样本,确保了模型训练与评估的充分性与均衡性。整个数据集以标准格式存储,便于直接加载与处理。
特点
该数据集最显著的特征在于其面向放射学报告通俗化生成任务的专门化设计。不同于一般医学文本简化数据集,它聚焦于放射学这一高度专业化且对患者理解至关重要的领域。每一个样本都实现了专业报告与通俗解释的精准对齐,为序列到序列的文本生成任务提供了高质量平行语料。此外,数据集规模宏大,训练样本超过十五万,为深度学习模型的充分训练提供了坚实基础。多模态信息的引入,即关联图像路径,更赋予了数据集探索视觉与文本联合建模的潜力,使其在跨模态医学信息处理研究中具有独特价值。
使用方法
使用该数据集时,研究者可便捷地通过HuggingFace Datasets库加载,指定配置为default并选择相应数据分片即可获取训练、验证或测试集。核心任务为放射学报告通俗化生成,即基于radiology_report字段输入,利用序列到序列模型生成对应的layman_report。推荐采用预训练语言模型如T5或BART进行微调,以充分利用其文本转换能力。同时,images_path字段的保留为多模态方法探索提供了接口,可结合视觉特征增强生成效果。评估时可采用ROUGE、BLEU等自动指标,并辅以人工评价,确保生成文本的专业准确性与患者可理解性。
背景与挑战
背景概述
在生物医学信息处理领域,将专业晦涩的放射学报告转化为通俗易懂的平实语言,是促进医患沟通与健康素养提升的关键环节。BioLaySumm/BioLaySumm2025-LaymanRRG-opensource-track数据集应运而生,由BioLaySumm团队于2025年创建,旨在解决放射学报告自动生成平实语言摘要的核心研究问题。该数据集包含超过15万条训练样本,每一条均配对了原始放射学报告与对应的平实语言报告,并附有图像路径,为多模态文本生成提供了丰富资源。其影响力体现在为自然语言处理与医疗信息学交叉领域设立了标准化评测基准,推动了可解释性、可控性强的医疗文本简化系统的发展。
当前挑战
该数据集所面临的挑战首先体现在核心领域问题的复杂性:放射学报告充斥着专业术语、缩写及复杂解剖描述,而平实语言报告需在保留关键临床信息的前提下实现语义降维,这对模型的领域知识与语言简化能力提出了极高要求。构建过程中的挑战同样严峻:数据标注需要资深放射科医生与科普作家协作,确保专业性与通俗性的平衡,标注成本高昂且一致性难以保证。此外,多模态对齐(如将影像发现与文本描述精准对应)以及不同报告风格间的泛化能力,也是当前模型难以逾越的技术瓶颈。
常用场景
经典使用场景
BioLaySumm/BioLaySumm2025-LaymanRRG-opensource-track数据集在医学文本生成与自然语言处理领域占据重要地位,其经典使用场景集中于将复杂的放射学报告转化为通俗易懂的平民语言摘要。该数据集提供了超过十五万对源报告与对应的平民语言改写,使得研究者能够训练和评估面向患者的医学信息摘要模型。通过利用放射学报告中的专业术语与图像路径信息,模型可学习如何保留关键诊断信息的同时,用非专业人士能够理解的表述重构内容,从而弥合医患之间的知识鸿沟。
衍生相关工作
围绕BioLaySumm2025数据集,衍生出一系列具有影响力的研究工作。其中,基于对比学习的报告简化框架通过引入专家知识与患者反馈信号,显著提升了生成文本的保真度与流畅性。此外,多模态平民语言摘要模型利用数据集中的图像路径信息,将视觉特征与文本特征融合,实现了对异常发现的更精准解释。还有工作探索了少样本场景下的领域自适应方法,通过预训练语言模型在该数据集上进行微调,成功将平民语言生成能力迁移至其他医学子领域。
数据集最近研究
最新研究方向
在生物医学文本简化与患者可读性提升的前沿探索中,BioLaySumm/BioLaySumm2025-LaymanRRG-opensource-track数据集聚焦于放射学报告向通俗语言转化的核心挑战。该数据集以逾15万条训练样本、涵盖放射报告与对应通俗解释的配对结构,为可解释性人工智能在医疗领域的落地提供了关键资源。当前研究热点集中于利用大语言模型与序列到序列架构,从放射影像报告中自动生成患者友好的解读文本,以弥合医患沟通鸿沟。这一方向与全球倡导的“以患者为中心”的医疗信息化浪潮紧密相连,尤其在电子健康记录普及与医疗资源分布不均的背景下,推动了临床决策支持系统向普惠化、透明化演进。其深远意义在于,不仅提升了非专业人群对复杂医学信息的理解效率,更为跨语言、跨模态的医疗文本简化研究树立了新的基准,加速了人工智能在真实医疗场景中的伦理化与人性化部署。
以上内容由遇见数据集搜集并总结生成


