
Amawal.net-Dataset
收藏官方服务:
资源简介:
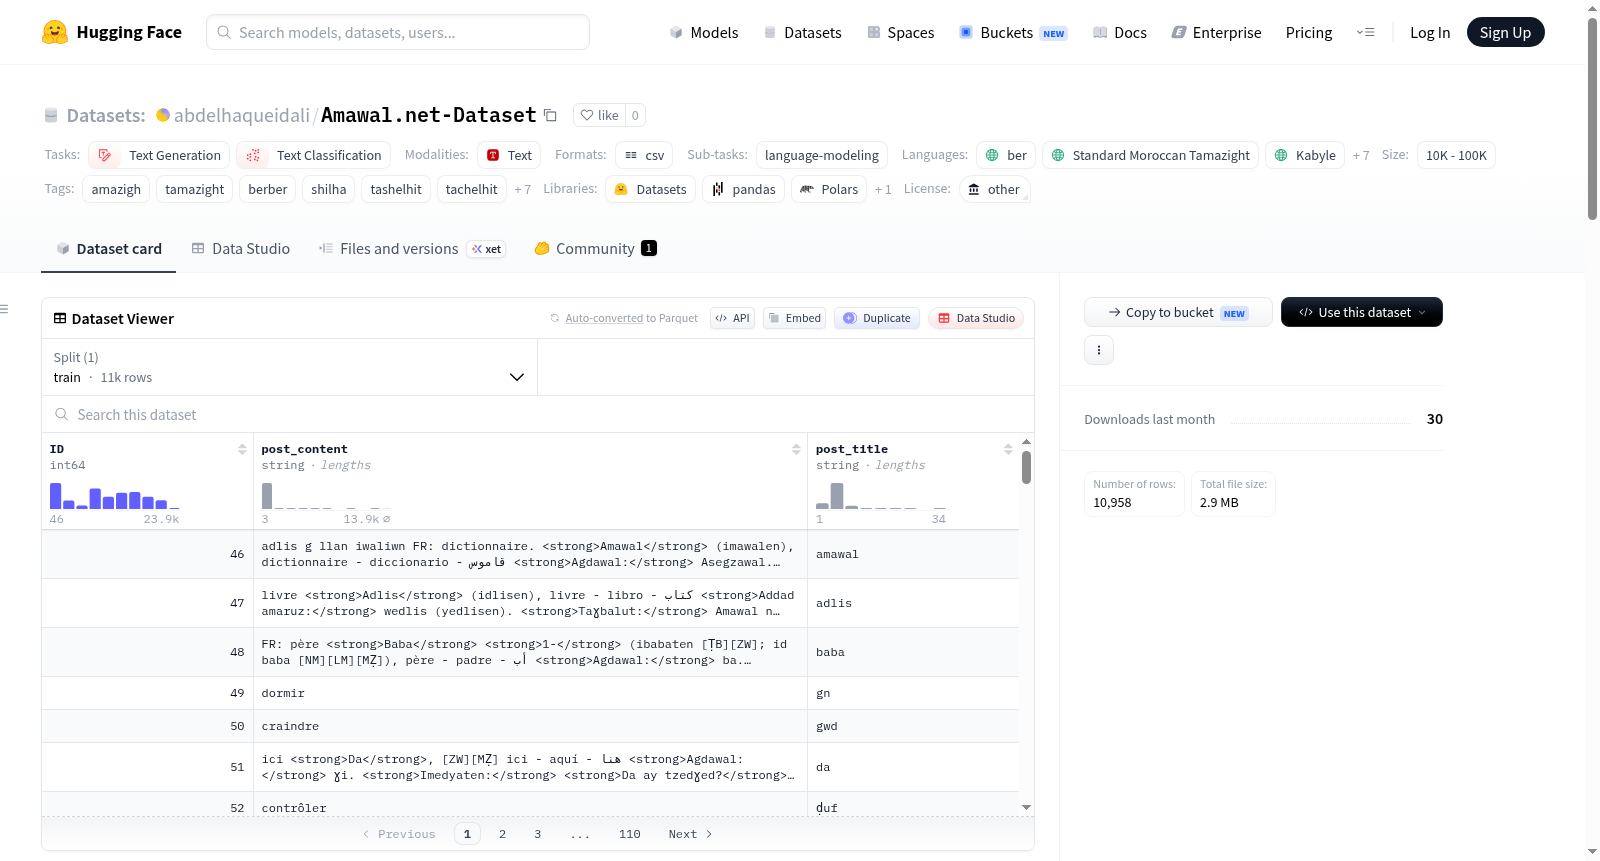
Amawal.net数据集是从已关闭的Amawal.net平台汇编的众包词汇和语言条目档案。该数据集旨在保存这一社区驱动的多方言语言资源,使其可用于自然语言处理、词典编纂和数字人文应用。数据集包含超过10,000个论坛式条目,数据截止于2011年。每个条目采用对话式论坛帖子结构:包含作为标题的核心词,以及详细描述该词定义、语义含义、区域翻译、文字转写和方言变体的上下文内容。由于数据来源于有机的众包过程,不同条目的字段完整性各异,真实反映了早期数字泛阿马齐格词汇汇编的横截面。语言方面涵盖广泛的阿马齐格语区域变体(包括标准摩洛哥阿马齐格语zgh、卡拜尔语kab、塔舍利特语shi、中阿特拉斯塔马齐格特语tzm、里夫语rif),并配有法语、西班牙语、英语和阿拉伯语的平行翻译或描述。数据集结构采用论坛式文档布局,包含两个核心字符串实体:title(被定义的目标词或术语)和content(包含含义、文字转写和描述性翻译向量的完整文本块)。该数据集适用于词典提取、语言建模与分词、跨方言语言映射等任务,但需注意其作为2011年存档快照的历史性质,某些条目可能包含标准化前的本地化不一致文字约定。
创建时间:
2026-06-09
原始信息汇总
数据集概述:Amawal.net Lexicon Dataset
- 数据集名称:Amawal.net-Dataset
- 来源平台:Amawal.net(已关闭)
- 数据集类型:众包词典与语言学条目档案
- 数据规模:10,000 至 100,000 条记录
- 语言:
- 柏柏尔语族(阿马齐格语):
ber、zgh(标准摩洛哥阿马齐格语)、kab(卡比尔语)、tzm(中阿特拉斯塔马齐格特语)、rif(里夫语)、shi(塔谢尔希特语)、tmh(图阿雷格语) - 翻译/描述语言:
fr(法语)、es(西班牙语)、en(英语)
- 柏柏尔语族(阿马齐格语):
- 许可证:其他(具体未明确)
- 创建者:Amawal.net 众包用户社区
- 任务类别:文本生成、文本分类
- 子任务:语言建模
数据集结构
数据集采用论坛式文档布局,每个条目包含两个核心字段:
title:被定义的单词或术语。content:帖子的完整文本,包含含义、文字转写、描述及翻译向量。
用途
- 直接用途:
- 词库与词典提取:挖掘结构化术语、新词及方言同义词,构建专业电子词汇表。
- 语言建模与分词:基于多语种描述数据训练小型语言模型和形态分析器。
- 跨方言语言映射:研究北部变体(如卡比尔语、里夫语)与南部变体(如塔谢尔希特语)之间的词汇对比。
- 非适用场景:
- 数据集为2011年的存档快照,未经预处理前不应作为官方语言标准化框架(如IRCAM标准拼写指南)的绝对参考手册。
创建背景
- 整理动机:Amawal.net 是最早且最广泛的社区驱动阿马齐格语数字化项目之一。该网站已永久下线,数据集作为数字保存库,保护这一协作遗产免于丢失,并用于低资源计算研究。
- 数据来源:由多语种阿马齐格语使用者、教师、活动家和语言学习者于2000年代初至2011年间在网络上协作生成。
风险与限制
- 条目完整性不一:部分条目包含详细的示例和多语言翻译,而另一些仅有简单的翻译对应词。
- 历史拼写惯例:2011年前的内容可能使用本地化、不一致的脚本惯例或自定义字符变体,早于广泛的数字标准化。
词汇表
- Amawal:阿马齐格语中意为“词典”或“词汇表”的术语。
- 众包词典编纂:由分散的公共用户直接撰写和提交定义,合作创建词典。
联系方式
- 数据集作者邮箱:abdelhaque.idali@gmail.com
搜集汇总
数据集介绍
构建方式
Amawal.net-Dataset 源自已关闭的众包平台 Amawal.net,该平台曾是早期互联网上社区驱动型阿马齐格语词汇数字化的重要阵地。数据集收录了截至2011年的逾万条论坛式词条,每条记录以目标词汇作为标题,结合用户提交的描述性内容、语义解释、区域翻译、文字转写及方言变体等信息。其构建方式依托分散的互联网用户群体,包括阿马齐格语使用者、教育者及语言爱好者等,通过非结构化论坛交互模式自然生成,字段完整性随贡献者意愿而波动,因此真实反映了早期数字环境中多方言词汇编纂的生态全貌。
使用方法
研究人员可基于该数据集开展多类自然语言处理任务。在词典编纂角度,用户能够提取结构化术语与新词,构建专用电子词汇表;在语言建模层面,其多脚本、多语种的描述性文本适于训练小规模语言模型及形态分析器。此外,数据集特别适用于跨方言语言映射研究,辅助比较北部变体(如卡拜尔语)与南部变体(如塔谢尔希特语)间的词汇差异。使用时需注意,由于条目反映当时的社区惯例而非官方标准化框架,在应用前应进行适当的预处理与语境考量。
背景与挑战
背景概述
Amawal.net-Dataset 数据集的创建源于对柏柏尔语(Amazigh)这一低资源语言的数字化保护需求,其数据由全球柏柏尔语使用者、教育者和语言活动家通过众包平台在2000年代初至2011年间共同贡献,原始网站 Amawal.net 是早期互联网上最广泛的多方言柏柏尔语词汇汇编之一。该数据集收录了超过一万条论坛式词条,涵盖标准摩洛哥柏柏尔语、卡拜尔语、塔谢尔希特语、里夫语等多种方言变体,并伴随法语、西班牙语、英语和阿拉伯语的平行翻译。作为该语言社区数字遗产的存档,它为自然语言处理、词典学和数字人文学研究提供了不可替代的跨方言词汇资源,对低资源多语言建模和语言复兴具有重要影响力。
当前挑战
该数据集所解决的领域问题在于为柏柏尔语这一低资源语言提供首个大规模众包词汇基准,以应对其多方言体系缺乏标准化数字语料的挑战。具体挑战包括:1)词条完整性不一,部分条目仅含简单翻译等价物,缺乏上下文示例和多语言描述,增加了结构化词典提取的难度;2)历史正字法不统一,2011年前的数据呈现本地化、非标准化的文字惯例和自定义字符变体,需要预处理才能适配现代自然语言处理流程;3)数据格式继承自论坛结构,条目以非结构化的标题与正文形式存储,需进行复杂的信息抽取方可服务于语言建模、分词和跨方言映射等下游任务。
常用场景
经典使用场景
在柏柏尔语这一低资源语言的研究领域中,Amawal.net-Dataset为自然语言处理提供了宝贵的数据基础。该数据集汇聚了超过一万条源自早期互联网众包的词汇与语言学条目,覆盖了塔马齐特语、卡比勒语、塔谢尔希特语、里夫语等多个主要方言变体。其最经典的使用场景包括构建多方言电子词典、提取新词与方言同义词以丰富术语资源,以及将柏柏尔语与法语、西班牙语、英语等语言进行跨语言映射。研究者常将该数据集用于词形分析、语言建模与分词器训练,尤其适合在数据稀缺条件下探索低资源语言的语义特征与语法结构,为柏柏尔语的数字化复兴提供了坚实支撑。
解决学术问题
该数据集的核心价值在于解决了柏柏尔语作为低资源语言计算资源匮乏的困境。在语言学计算领域,方言多样性、历史正字法不统一以及高水平语料库缺失长期阻碍着柏柏尔语的研究进展。Amawal.net-Dataset通过保存早期社区协作的词汇遗产,为跨方言对比分析和跨语言语义映射提供了稀缺的数字化语料。它有效缓解了学术研究中标注数据稀有的问题,支持开发者在无可靠标准化参考时能基于真实众包样本进行形态分析或训练小型语言模型,从而推动了低资源环境下的语义计算与方言变体比较研究,也为数字人文与历史语言学的研究范式创新提供了范例。
实际应用
在实际应用层面,该数据集展现出广泛的跨界价值。由柏柏尔语学者、语言教师、社区活动家与技术开发者共同维护的众包词条,可被直接转化为数字教育工具的关键素材,例如用于制作交互式方言学习应用、在线词典或智能翻译辅助系统。基于该数据集训练的小型语言模型,能有效支持柏柏尔语的自动拼写检查、基础文本生成和信息检索服务,尤其适用于缺乏数字基础设施的北非乡村社区。此外,文化遗产数字化机构可利用该数据构建历史词汇档案,协助语言复兴项目识别濒危表达与方言差异。其多语种平行特性还赋予其在跨语种语音识别、旅游导览系统以及多语言用户界面中的落地潜力,真正实现了从学术资源到社会应用的跨越。
数据集最近研究
最新研究方向
当前,Amawal.net-Dataset的研究价值日益凸显,尤其在低资源语言自然语言处理领域。随着数字人文与语言保护项目的兴起,该数据集成为探索柏柏尔语系多方言(如塔马齐格特语、卡拜尔语、里夫语)跨方言词汇映射与历史演变的关键资源。其众包特性捕捉了早期互联网时代社群协作的语料生态,为构建多脚本形态分析器、训练小型语言模型(SLM)以及方言语言建模提供了真实且多样的训练样本。特别是,在2011年数据截止背景下,该数据集承载了前标准化时期的词汇记录,对解读柏柏尔语数字化历程、推动濒危语言复兴与计算研究具有不可替代的文献意义与学术影响。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


