
somali-tts-corpus
收藏官方服务:
资源简介:
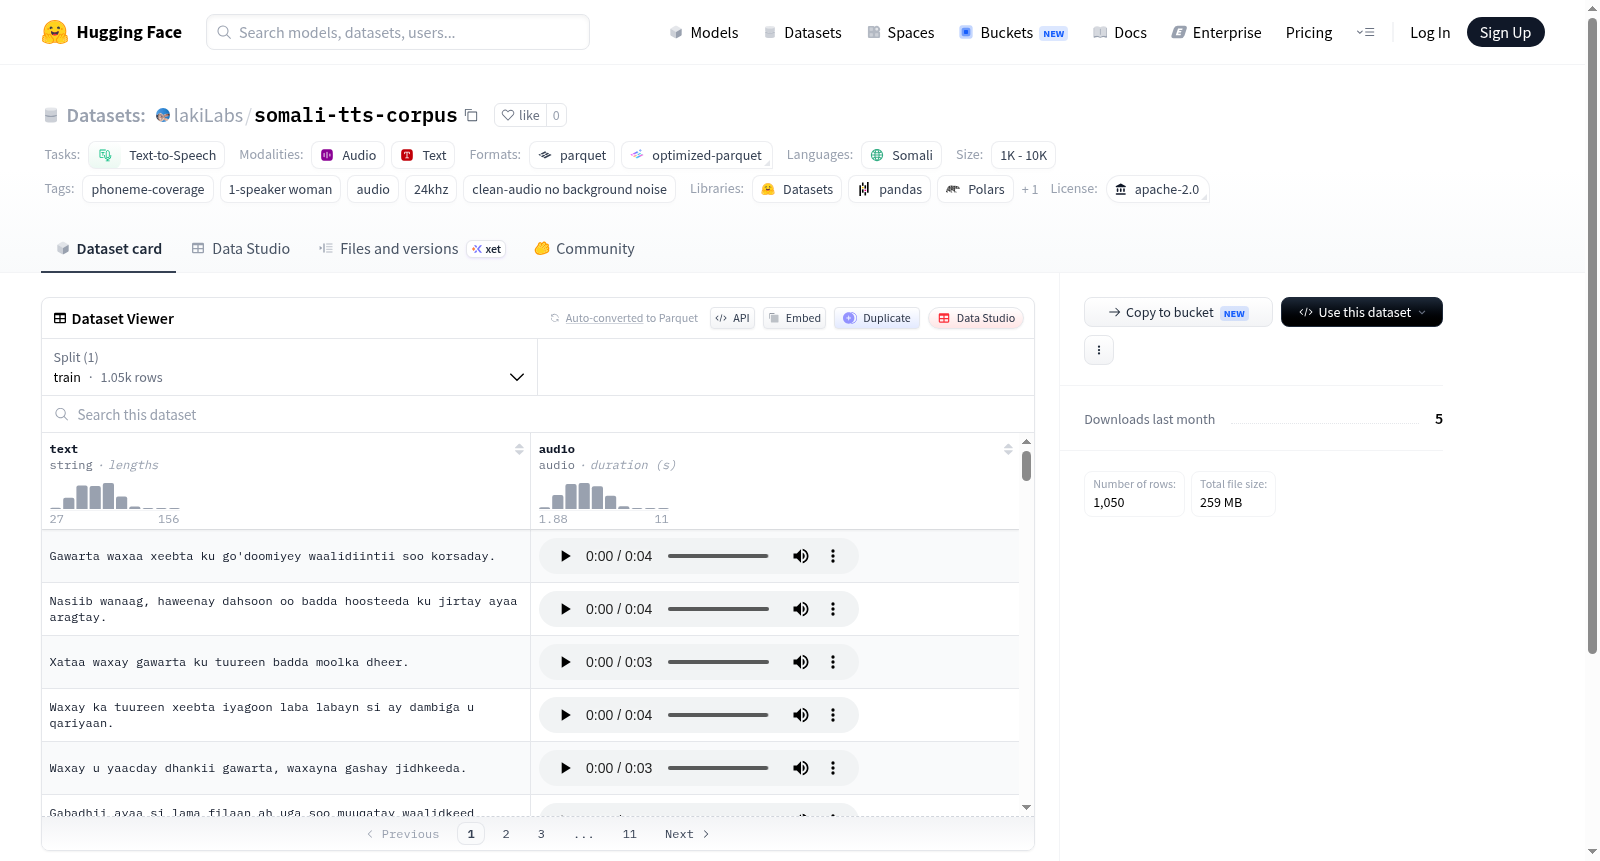
Somali tts Speech Phoneme Coverage 是一个专为索马里语文本到语音(TTS)任务设计的音频数据集。该数据集旨在提供全面的索马里语音素覆盖。数据内容为高质量的干净音频,采样率为24kHz,且无背景噪音干扰。数据集由一位女性说话人录制,适用于训练高质量的索马里语TTS模型。
创建时间:
2026-07-18
原始信息汇总
数据集概述
数据集名称:Somali tts Speech Phoneme Coverage
语言:索马里语(语言代码:so)
许可证:Apache-2.0
任务类型:文本转语音(TTS)
数据集特点
- 音素覆盖:数据集注重音素覆盖,适用于语音合成任务。
- 说话人:单说话人,为女性声音。
- 音频质量:音频采样率为24kHz,录音清晰,无背景噪声。
标签信息
数据集包含以下标签:
- phoneme-coverage(音素覆盖)
- 1-speaker woman(单说话人,女性)
- audio(音频)
- 24khz(24kHz采样率)
- clean-audio no background noise(音频干净,无背景噪声)
搜集汇总
数据集介绍
构建方式
somali-tts-corpus数据集专为索马里语文本转语音任务而构建,由单一女性发音人在无背景噪音的纯净录音环境下采集,音频采样率为24kHz,确保了语音信号的清晰度与高保真度。数据集在构建时着重考虑了音素覆盖的全面性,通过精心设计的语料文本,确保索马里语中所有关键音素均被充分采样,从而为语音合成模型提供均衡且完整的训练基础。
特点
该数据集的核心特点在于其高纯净度与针对性设计。所有音频均无背景噪声干扰,保障了声学特征的稳定性;单一女性发音人的设定有助于降低语音风格变异,适合用于构建单一音色、高自然度的TTS系统。此外,数据集明确标注了音素覆盖标签,使其在音素平衡训练中表现突出,尤其适用于低资源语言索马里语的语音合成研究。
使用方法
使用该数据集时,研究人员可直接将其用于训练基于深度学习的中文文本到语音模型,如Tacotron、FastSpeech等。数据集以开源Apache-2.0许可发布,便于集成至HuggingFace生态。建议在预处理阶段对24kHz音频进行重采样以适配模型输入,并利用音素覆盖标签进行语料平衡验证,以优化合成语音的发音准确性与自然度。
背景与挑战
背景概述
索马里语作为非洲之角地区广泛使用的语言,在自然语言处理领域长期面临资源匮乏的困境,尤其是语音合成方向的研究因缺乏高质量数据集而进展缓慢。Somali TTS语料库由单一女性发音人在无背景噪音的受控环境中录制,语音采样率为24kHz,并精心设计以覆盖目标语言的音素分布。该数据集创建的核心目的在于为索马里语文本转语音系统提供可靠的训练基础,解决该语种在语音技术应用中的基础数据支撑问题。作为一个开放共享资源,该语料库填补了低资源语言在深度学习驱动语音合成领域的空白,为多语种语音技术的发展提供了重要的补充与推动。
当前挑战
索马里语在语言学上具有独特的音系特征,包括复杂辅音系统和声调变化,这使数据集构建面临精准音素覆盖的挑战,任何稀疏或偏差都可能导致合成语音的自然度与可懂度下降。单一发音人的语料虽保证了音色一致性,却限制了声学模型对多风格、多情感及不同说话者差异的泛化能力,为大规模实用化系统部署留下瓶颈。此外,受控无噪声环境录制的数据虽质量高,却与真实应用场景中的背景噪声、语速变化等条件存在显著分布差异,增加了模型在现实环境中鲁棒适配的难度。最后,低资源条件下语料规模有限,对深度学习模型的训练效率和泛化边界提出了更高要求。
常用场景
经典使用场景
在低资源语言语音合成领域,索马里语因其语言学复杂性和数据稀缺性而长期处于研究边缘。Somali-TTS-Corpus作为首个面向索马里语的高质量单说话人语料库,其经典使用场景集中在基于深度学习的文本到语音系统构建,特别是音素覆盖度驱动的声学模型训练。该数据集通过精心设计的音素平衡语料,确保24kHz采样率下无背景噪声的纯净音频,为端到端模型如Tacotron2和FastSpeech提供可靠训练基础,显著提升了索马里语合成语音的自然度和可懂度。
解决学术问题
该数据集解决了低资源语言语音合成中训练数据匮乏与音素分布不均的根本性学术难题。传统方法在索马里语上因缺乏标准音素标注与均衡覆盖的语料,导致模型对稀有音素生成能力薄弱。该语料库通过系统性音素覆盖设计,填补了索马里语声学建模的空白,为跨语言语音迁移学习提供了基准数据集,推动了多语言TTS系统中低资源语言表征学习的研究进展。
衍生相关工作
基于Somali-TTS-Corpus,研究者衍生出多项经典工作。例如,利用该数据集进行的音素后验图式跨语言迁移研究,揭示了索马里语与其他库希特语系语言的声学相似性;另一项工作聚焦于低资源场景下基于韵律嵌入的TTS改进方法,通过该数据集的音素标签优化了停顿与重音建模。此外,它还被用作少样本语音克隆的测试基准,验证了预训练模型在极端低资源语言上的泛化极限。
以上内容由遇见数据集搜集并总结生成


