
遇见数据集

IQuestLab/UniReason-Med-Data

收藏
Hugging Face2026-06-10 更新2026-06-14 收录
官方服务:

资源简介:

UniReason-Med数据是用于UniReason-Med医学推理框架的训练数据集,该框架是一个医学多模态推理系统,专注于2D和3D医学图像理解。数据集包含监督微调(SFT)和基于梯度奖励策略优化/强化学习(GRPO/RL)的训练混合数据,支持交织的图像-文本推理和区域接地,使模型能够通过边界框标记识别图像区域、检查相应裁剪并继续推理以生成最终答案。数据集中,2D图像以Parquet格式存储,包含图像字节和相对路径;3D样本仅以文本记录发布,不包含原始3D图像数据,因为这些数据源自M3D(可能涉及Radiopaedia等来源,需要单独权限)。

Training data for UniReason-Med, a medical multimodal reasoning framework for 2D and 3D medical image understanding, including SFT and GRPO/RL training mixtures with region grounding capabilities, where models perform interleaved image-text reasoning with bounding-box tokens for region identification and inspection. The 2D image data is provided in Parquet format with image bytes, while 3D samples are released as text-only records due to licensing constraints from sources like M3D/Radiopaedia.
提供机构:
IQuestLab
搜集汇总
数据集介绍
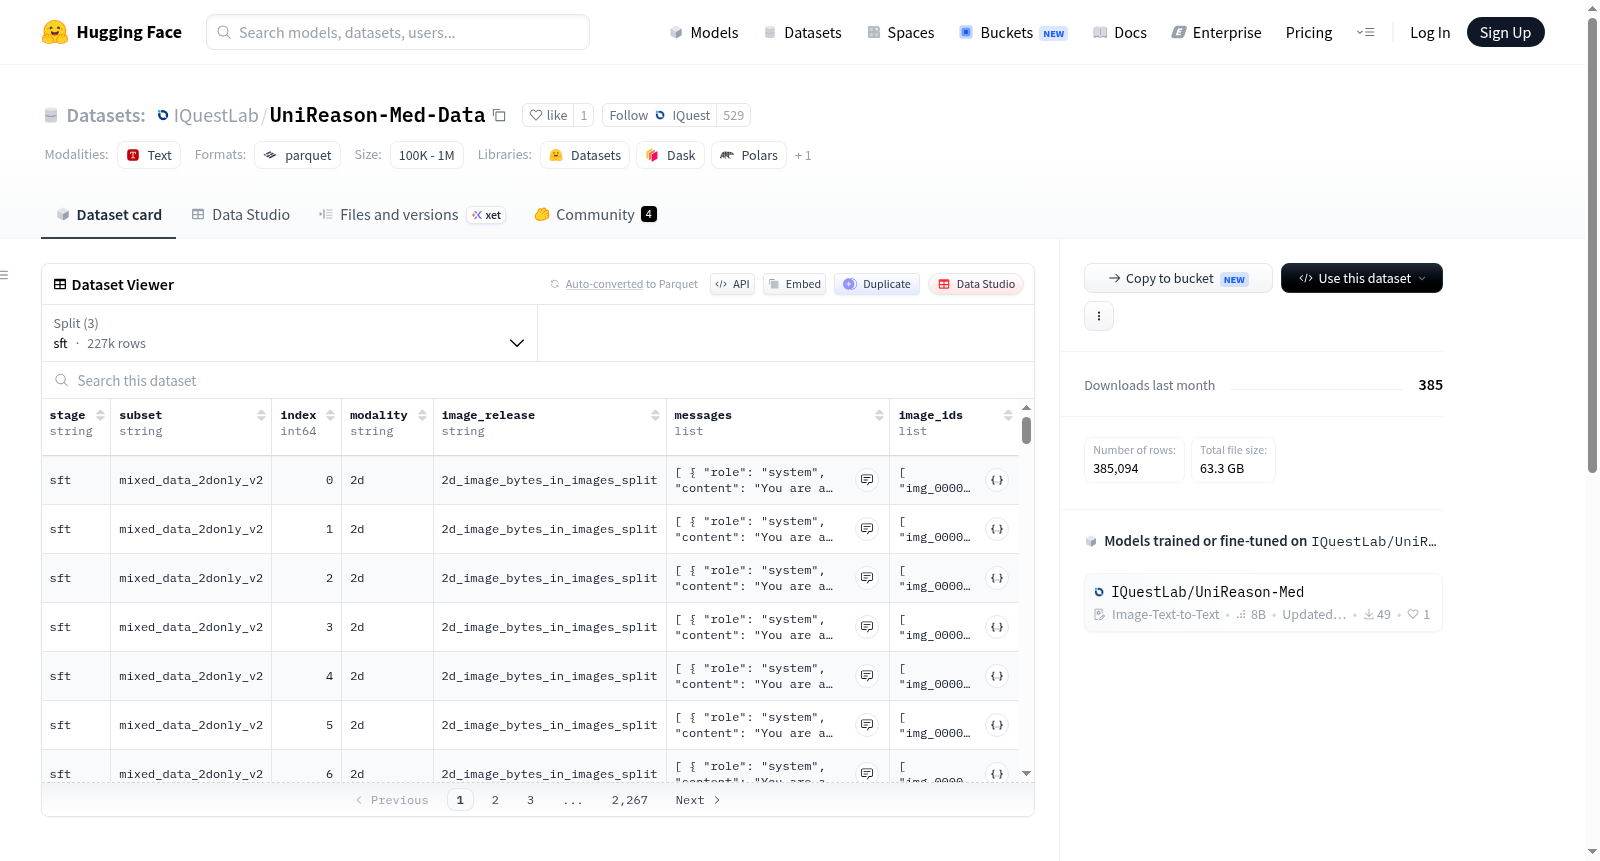
IQuestLab/UniReason-Med-Data 数据集图片
构建方式
UniReason-Med-Data 数据集专为医学多模态推理任务而构建,涵盖了监督微调(SFT)与基于强化学习(GRPO/RL)的训练混合数据。其设计旨在支持视觉-语言模型对二维及三维医学影像进行交错式图文推理,并具备区域定位能力——模型能够通过边界框标记识别图像区域,检查对应的裁剪区域,最终生成答案。数据集中,二维图像以Parquet格式存储于'images'分片中,包含图像字节与中性相对路径;SFT与RL记录则通过'image_ids'引用这些图像。三维样本仅以纯文本形式发布,因其底层图像源自M3D/Radiopaedia等数据源,需用户另行获取授权。
特点
该数据集的核心特点在于其多模态推理与区域定位的深度融合。通过引入交互式推理机制,模型可在推理过程中动态定位并放大图像区域,从而在复杂医学影像任务中提升可解释性与准确性。此外,数据集划分了明确的SFT、RL及图像分片,便于针对不同训练阶段灵活使用。二维影像数据直接嵌入Parquet记录,简化了加载流程;三维样本虽仅提供文本描述,但确保了数据合规性,避免版权风险。这种设计平衡了功能丰富性与数据访问的合法性,为医学领域的大规模多模态模型训练提供了可靠基础。
使用方法
使用UniReason-Med-Data时,用户可通过HuggingFace数据集API加载各分片:采用'sft'分片进行监督微调,'rl'分片用于强化学习训练,而'images'分片则提供二维图像字节数据。记录中的'image_ids'字段用于关联图像与文本样本,确保数据一致性。对于二维图像,可直接从Parquet中读取字节并解码为图像张量;对于三维样本,需用户依据文本描述,从原始数据源(如M3D)单独申请授权并获取影像。推荐将数据集与视觉-语言模型框架(如Transformers或自定义训练脚本)结合使用,以充分利用其交错推理与区域标注特性。
背景与挑战
背景概述
UniReason-Med-Data数据集由研究团队为支持医学多模态推理框架UniReason-Med而创建,该框架专注于2D和3D医学图像理解,旨在训练视觉语言模型执行交错图像-文本推理与区域定位。通过引入边界框标记识别图像区域、检查对应裁剪并持续推理直至生成最终答案,该数据集为医学影像分析领域提供了关键训练资源。其发布的研究工作聚焦于解决医学图像理解中推理能力不足的问题,对推动多模态人工智能在放射学、病理学等临床场景的应用具有重要影响力,为后续模型评估与性能提升奠定了数据基础。
当前挑战
该数据集面临的首要挑战是领域问题的复杂性:医学图像推理需同时处理2D与3D模态数据,要求模型在识别区域后进行跨模态推理,这远超传统图像分类任务,涉及精细的解剖结构定位与临床语境理解。在构建过程中,3D图像样本因源自M3D(底层图像来源包括Radiopaedia等需单独授权),团队无法直接分发,导致用户需自行协调许可才能获取完整数据。此外,混合使用监督微调与强化学习训练范式增加了数据管理难度,要求不同分片(SFT、RL、图像)间严格对齐,且图像引用依赖相对路径与ID映射,对数据标准化和可复用性构成潜在障碍。
常用场景
经典使用场景
在医学多模态推理研究领域,UniReason-Med-Data数据集作为核心训练资源,被广泛用于训练具备二维与三维医学影像理解能力的视觉-语言模型。其经典使用场景聚焦于实现“交错式图文推理与区域定位”,即模型在推理过程中能够动态识别图像中的关键区域,生成边界框令牌,提取对应区域放大图,并结合上下文继续推理直至输出最终答案。这一机制尤其适用于放射学报告生成、病理影像分析等需要精细定位与逐层推理的医学诊断任务。
衍生相关工作
基于UniReason-Med-Data的框架已催生多项衍生研究,例如将交错推理范式拓展至病理切片全视野图像分析,或结合多器官多模态数据构建通用医学基础模型。相关经典工作包括区域级医学视觉问答(Region-based Med-VQA)、多步推理病理报告生成(Multi-step Patho-Report)以及交互式3D医学影像分割与推理系统。这些工作均继承并深化了数据集所倡导的“定位-放大-推理”一体化范式,推动医学AI从感知智能向认知智能持续演进。
数据集最近研究
最新研究方向
在医学影像理解的前沿探索中,UniReason-Med-Data数据集为多模态推理与区域定位的深度融合提供了关键资源。其核心创新在于训练视觉语言模型实现二维与三维医学图像的交错文本-图像推理,通过边界框标记定位病灶区域并引导逐步推理,最终输出精准诊断。这一方向紧密关联大语言模型在医疗领域的落地应用,尤其在放射学报告自动生成、手术规划辅助等场景中展现出变革性潜力。该数据集释出的监督微调与强化学习混合数据,不仅推动了医学多模态模型从简单分类向复杂推理范式的跃迁,更通过区域级视觉-语言对齐策略,显著提升了模型对解剖结构和病理特征的细粒度理解能力,为构建可信、可解释的临床决策支持系统奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

