
遇见数据集

cardiffnlp/Morables-PD

收藏
Hugging Face2026-07-16 更新2026-07-22 收录
官方服务:

资源简介:

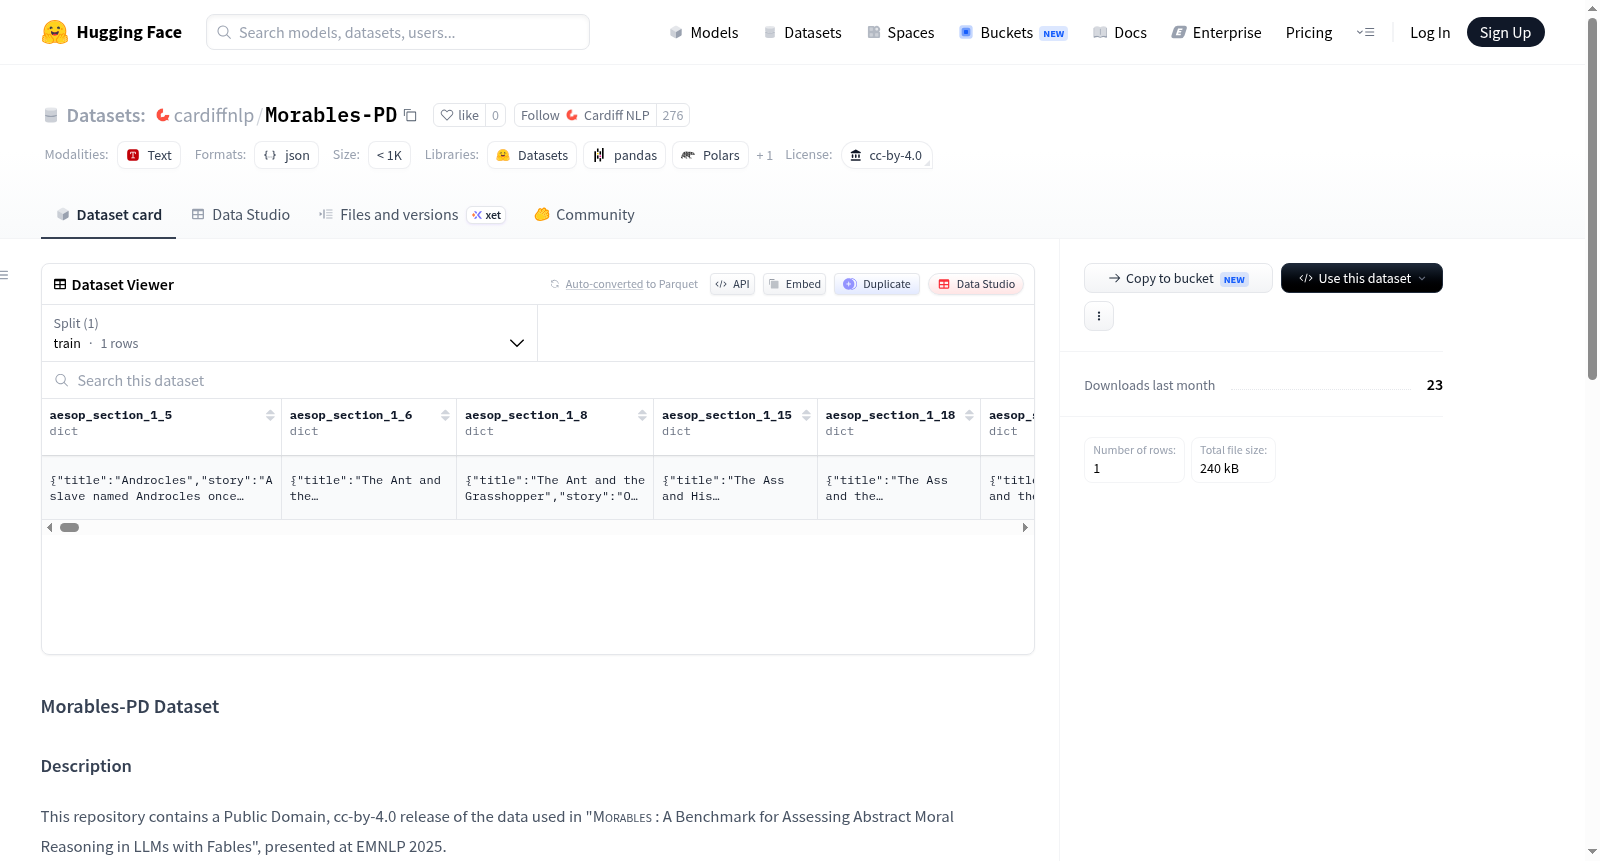
该仓库包含用于EMNLP 2025论文Morables:一个用寓言评估大语言模型抽象道德推理能力的基准的数据的公共领域、cc-by-4.0版本发布。此并行发布仅包含公共领域内的标题-寓言-道德三元组,并带有标注者验证的道德内容。每个寓言都有一个相关的自由文本道德,源自各种网站和书籍(论文中详细说明)。它旨在用于NLP文本理解和道德推理任务。文件格式为JSON,记录数为308,每个条目包含:alias(寓言的唯一ID)、title(寓言标题)、story(寓言/短故事内容)和moral(故事道德)。

This repository contains a Public Domain, cc-by-4.0 release of the data used in Morables : A Benchmark for Assessing Abstract Moral Reasoning in LLMs with Fables, presented at EMNLP 2025. This parallel release only contains the title-fable-moral triples within Public Domain, with the annotator verified morals. Each fable has an associated free-text moral, sourced from various websites and books (detailed in the paper). It is intended for use in NLP text understanding and moral inference tasks. File format is JSON, with 308 records, each entry containing: alias (unique ID of the fable), title (title of the fable), story (content of the fable/short story), and moral (moral of the story).
提供机构:
cardiffnlp
搜集汇总
数据集介绍
cardiffnlp/Morables-PD 数据集图片
构建方式
Morables-PD数据集源于EMNLP 2025会议上发表的论文《Morables: A Benchmark for Assessing Abstract Moral Reasoning in LLMs with Fables》,旨在评估大语言模型的抽象道德推理能力。该数据集以公共领域(Public Domain)为基础,采用cc-by-4.0许可协议发布,从多种网站和书籍中搜集寓言标题、故事内容及其对应的道德训诫,并经过人工标注者验证,确保道德信息的准确性。最终整理为包含308条记录的JSON文件,每条记录由唯一标识符、寓言标题、故事文本和道德寓意四部分构成。
特点
该数据集的核心特征在于其聚焦于抽象道德推理这一高阶认知任务,通过寓言这一富有寓意的文学形式,为模型提供了需要超越字面语义、理解隐含道德准则的挑战性基准。所有道德训诫均为自由文本形式,避免了预设标签的局限性,更贴近真实世界中的道德判断场景。此外,数据集完全采用公共领域内容,确保了使用的合法性与开放性,适用于自然语言处理中的文本理解与道德推理等多种下游任务。
使用方法
Morables-PD数据集可直接用于大语言模型的道德推理能力评估与训练。用户可通过加载JSON文件获取每条记录的标题、故事和道德三元组,将故事作为模型输入,要求模型生成或选择对应的道德寓意,进而与标注的道德文本进行对比,以衡量模型的抽象推理性能。数据集结构简洁明了,便于与常见的NLP框架(如HuggingFace的Transformers库)集成,支持零样本或少样本评估场景,同时也为道德感知的提示工程和微调实验提供了标准化基准。
背景与挑战
背景概述
随着大型语言模型(LLMs)在自然语言处理领域取得突破性进展,如何评估其在高阶认知任务——尤其是抽象道德推理——中的表现,已成为人工智能伦理与可解释性研究的前沿议题。Morables-PD数据集正是在此背景下应运而生,由Matteo Marcuzzo、Alessandro Zangari等研究者于2025年EMNLP会议中提出。该数据集以经典寓言为媒介,通过标题-故事-道德三元组结构,系统考察模型从叙事中提取并抽象概括道德内涵的能力。作为公开领域中首个聚焦于LLMs抽象道德推理的基准测试资源,Morables-PD填补了当前评估体系中缺乏针对价值判断与道德演绎维度的空白,为理解神经符号系统在伦理推理方面的局限性与潜力提供了关键工具。
当前挑战
该数据集面临的核心挑战之一在于其所锚定的领域问题:抽象道德推理涉及对隐含价值观、因果逻辑与跨情境泛化的综合理解,远超传统NLP任务(如文本分类或情感分析)的范畴,现有LLMs在此维度常表现出显著的鲁棒性不足与偏见倾向。在构建层面,挑战亦十分突出:需从多元来源(如古籍、网络文本)筛选并确保寓言文本的公共领域合法性(CC-BY-4.0),同时要规避翻译偏差与文化特异性对道德内核的扭曲;此外,由标注专家人工验证的道德结论需保持主观一致性与跨文本可迁移性,在仅308条精炼样本的规模下平衡评估的深度与广度,对资源筛选与标准化流程提出了严苛要求。
常用场景
经典使用场景
在自然语言处理与人工智能伦理交叉的研究领域中,Morables-PD数据集因其独特的寓言-道德三元组结构而备受瞩目。该数据集包含308条精心标注的条目,每条均由标题、寓言故事及其对应的抽象道德训诫组成。最经典的使用场景是作为大语言模型抽象道德推理能力的基准测试,研究者通过让模型从寓言文本中推断隐含的道德寓意,来评估其对深层道德概念的语义理解与泛化能力,而非局限于表面模式匹配。
解决学术问题
该数据集精准定位了当前大语言模型评估中的一个关键学术盲区:模型能否像人类一样,从叙事文本中提取并理解抽象的伦理原则。Morables-PD解决了传统NLP基准多聚焦于事实性知识或逻辑推理、却鲜少触及道德抽象推理的难题。其意义在于为衡量AI系统的价值对齐与伦理推理提供了可复现的标准化测试,影响深远且推动了从计算语义学、道德哲学到AI安全等跨学科对话的深化。
衍生相关工作
Morables-PD的发布催化了一系列前沿学术工作。围绕该数据集,研究者们开发了细粒度的道德维度分类体系,将抽象道德拆解为正义、仁慈、诚实等子类别进行逐项分析;衍生出了跨文化道德推理的对比研究,探讨不同语言训练下的模型对东方与西方寓言的反应差异;亦催生了若干旨在提升模型道德鲁棒性的微调策略与提示工程方法,以及将道德推理与可解释AI相结合的探索性工作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

