LightGBM_Alpha300
收藏资源简介:
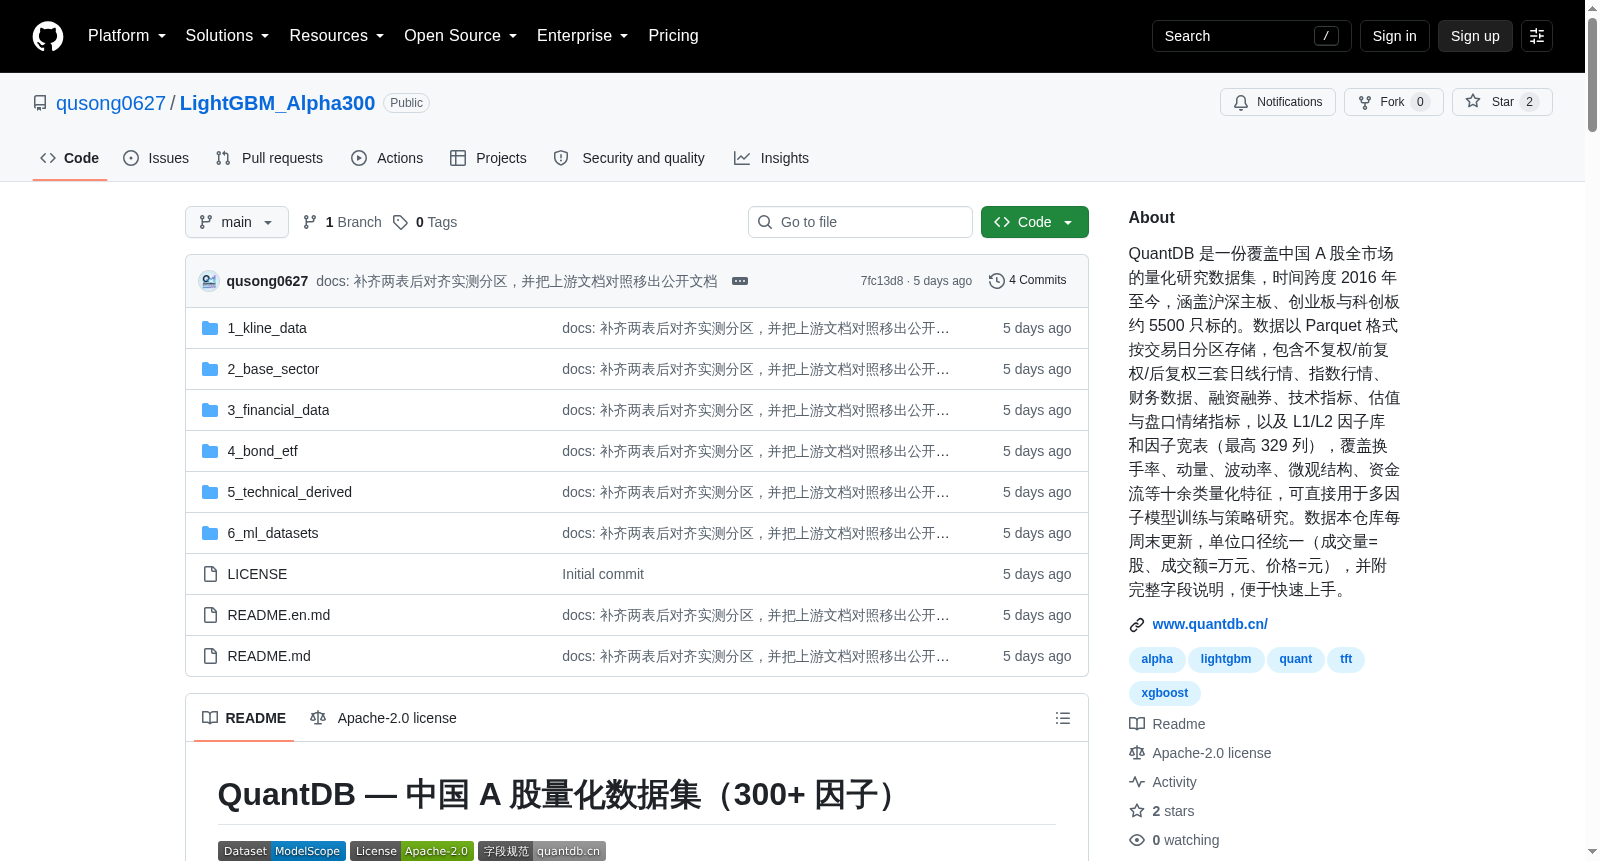
覆盖沪深全市场(主板/创业板/科创板)约5500只标的、2016年至今的A股量化研究数据集,包含日线三套复权行情、指数、财务数据、融资融券、技术指标、估值与盘口情绪,以及L1因子110维/L2高频因子211维/合并宽表329列,可直接用于多因子建模与LightGBM训练。
This A-share quantitative research dataset covers approximately 5,500 listed securities across the entire Shanghai and Shenzhen stock markets, including the Main Board, ChiNext, and STAR Market, with a time span from 2016 to the present. It includes three sets of daily adjusted trading quotes, index data, financial data, margin trading and short selling data, technical indicators, valuation metrics, and intraday order book sentiment data. Additionally, it provides 110-dimensional L1 factors, 211-dimensional L2 high-frequency factors, and a merged wide table with 329 columns, which can be directly applied to multi-factor modeling and LightGBM training.
QuantDB — 中国 A 股量化数据集(300+ 因子)
数据集概况
- 数据本体托管地址:https://www.modelscope.cn/datasets/qusong0627/LightGBM_Alpha300
- 代码仓库地址:https://github.com/qusong0627/LightGBM_Alpha300
- 覆盖范围:沪深全市场(主板 / 创业板 / 科创板)约 5500 只标的
- 时间跨度:2016 年至今
- 数据规模:约 56 GB / 约 7.4 万个 Parquet 文件
- 更新频率:每周末同步一次。日线、衍生指标与因子库按交易日追加;财务数据按报告期披露更新(最新至 2026 年中报);融资融券 T+1 披露。
- 数据许可:Apache License 2.0
数据集构成
| 目录 | 内容 | 分区方式 | 实测体积 |
|---|---|---|---|
1_kline_data/ |
不复权 / 前复权 / 后复权日线、指数日线 | 按交易日,2608 区 | 0.12–0.22 MB/日 |
2_base_sector/ |
融资融券、合约资料、行业概念、交易日历、指数权重 | 混合 | 3.2 MB(合约表) |
3_financial_data/ |
资产负债 / 利润 / 现金流 / 股本 / 股东户数 / 每股指标 / 分红 | 逐股文件 | 5559 只/表 |
4_bond_etf/ |
可转债要素、ETF 申赎清单 PCF | 快照单文件 | ~1.1 MB |
5_technical_derived/ |
技术指标 35 列、估值 16 列、盘口情绪 17 列 | 按交易日 | 0.45–1.12 MB/日 |
6_ml_datasets/ |
features_daily 78 / l1_factors 119 / l2_factors 219 / l1_l2_factors 329 |
按交易日 | 1.74–14.39 MB/日 |
因子维度
- L1 因子:110 维
- L2 高频因子:211 维
- 合并宽表:329 列
下载方式
前置依赖:pip install modelscope pandas pyarrow(modelscope ≥ 1.40)
-
全量下载(约 56 GB):
modelscope download --repo-type dataset qusong0627/LightGBM_Alpha300 --local_dir ./quantdb --max-workers 8
-
预览样本(27 张表 × 300 行,共约 3.1 MB):
modelscope download --repo-type dataset qusong0627/LightGBM_Alpha300 --include "preview/*" --local_dir ./quantdb-preview
-
按表或时间下载(下载粒度 = 单个交易日分区):
modelscope download --repo-type dataset qusong0627/LightGBM_Alpha300 --include "6_ml_datasets/l1_factors/*" --local_dir ./quantdb
-
Python 写法: python from modelscope import snapshot_download path = snapshot_download( repo_id="qusong0627/LightGBM_Alpha300", repo_type="dataset", local_dir="./quantdb", allow_patterns=["6_ml_datasets/l1_factors/dt=2026*/*"], )
注意:参数为
--repo-type dataset,不是--dataset。
实测体积(一年按约 244 个交易日估算)
| 数据集 | 单日 | 一年(估) | 分区数 | 最新分区 |
|---|---|---|---|---|
1_kline_data/daily_unadjusted |
0.12 MB | ~29 MB | 2608 | 20260924 |
1_kline_data/daily_forward |
0.13 MB | ~32 MB | 2608 | 20260924 |
1_kline_data/daily_backward |
0.22 MB | ~54 MB | 2608 | 20260924 |
5_technical_derived/technical_indicators |
1.12 MB | ~273 MB | 2608 | 20260924 |
5_technical_derived/valuation |
0.46 MB | ~112 MB | 2608 | 20260924 |
5_technical_derived/market_sentiment |
0.52 MB | ~127 MB | 2608 | 20260924 |
6_ml_datasets/features_daily |
1.74 MB | ~0.42 GB | 2608 | 20260924 |
6_ml_datasets/l1_factors |
3.69 MB | ~0.90 GB | 2608 | 20260924 |
6_ml_datasets/l2_factors |
9.92 MB | ~2.42 GB | 2120 | 20260924 |
6_ml_datasets/l1_l2_factors |
14.39 MB | ~3.51 GB | 2120 | 20260924 |
preview/* |
— | 合计 3.1 MB | — | — |
| 全仓库 | — | ~56 GB | 2608 交易日 | 20260924 |
单日截面行数(2026-09-24 实测):日线与衍生指标表 5570 行(含 347 只北交所 .BJ);因子表不含 .BJ——features_daily 5223 行、l1_factors 5208 行、l2_factors 5210 行、l1_l2_factors 5196 行。
全局约定
股票代码格式
| 交易市场 | 后缀 | 示例代码 |
|---|---|---|
| 上海证券交易所 | .SH | 600000.SH , 688000.SH |
| 深圳证券交易所 | .SZ | 000001.SZ , 300001.SZ |
| 北京证券交易所 | .BJ | 830000.BJ , 430000.BJ |
复权口径
| 复权类型 | API 参数 | 算法说明 | 典型应用场景 |
|---|---|---|---|
| 不复权 | unadjusted | 原始真实成交价,包含除权除息跳空缺口 | 真实交易成本分析、分红收益回算 |
| 前复权 | forward | 以最新价格为基准,历史价格向下平移调整 | 量化回测、技术指标计算(最常用) |
| 后复权 | backward | 以 2016 年第一个交易日为基准(本地历史起点),最新价格向上平移调整 | 长期真实复利收益、累计历史涨幅评估 |
daily_forward为等比前复权(以最新交易日收盘定标,历史恒为正);daily_backward为等比后复权(锚定窗口首日,新除权事件不会使历史漂移)。- 技术指标基于后复权序列计算,估值与情绪指标基于不复权真实价计算。 因子表(
l1_factors及之后)内的 OHLCV 一律为后复权价。
单位口径
| 数据类型 | 单位 | 口径说明 |
|---|---|---|
| 价格(open/high/low/close) | 元(人民币) | 精确到分/厘 |
| 日线成交量(daily_*/features/L1/技术衍生) | 股 | volume 为股,三种复权量额相同 |
| 日线成交额(daily_*/features/L1) | 万元 | amount 为万元 |
| 指数日线(index_daily) | 股 / 万元 | volume 为股,amount 为万元,均价=amount*1e4/volume |
| 市值(total_mv / float_mv) | 元 | 市值 = 股本 × 收盘价 |
| 股本(total_capital) | 股 | 总股本 / 流通股本 |
| 财务报告数据 | 元 | 标准会计报表口径,除特别标注外 |
读取方式
目录名本身就是 dt= 分区,除 pandas 外可直接交给 DuckDB / pyarrow 做分区裁剪。
python import pandas as pd kline = pd.read_parquet("quantdb/1_kline_data/daily_unadjusted/dt=20260924/data.parquet")
列: symbol, time, open, high, low, close, volume, amount
python import glob frames = [pd.read_parquet(p) for p in sorted(glob.glob( "quantdb/6_ml_datasets/l1_factors/dt=2026*/data.parquet"))] train = pd.concat(frames, ignore_index=True) # 实测 4 个分区 = 20832 行 × 119 列
python import duckdb df = duckdb.sql(""" SELECT symbol, close, mom_ret_20d, micro_vpin_20 FROM read_parquet(quantdb/6_ml_datasets/l1_l2_factors/dt=*/data.parquet, hive_partitioning=true) WHERE dt >= 20260101 """).df()
已知数据状况
- 两个因子已断更:
ind_netflow_rank_20与concept_flow_rank在 2026-09-24 全表 100% 为空(退化为常数列),但 2026-06-01 仍正常。建议按「列空值率阈值」动态剔除,不要写死列名。 - 两套标的范围(universe):日线与
5_technical_derived/三张表单日 5570 行,含 347 只北交所(.BJ);6_ml_datasets/的因子表一律不含.BJ(5196~5223 行)。margin_trading同样含.BJ(2026-09-23 实测 341 只)。跨范围拼接会得到不等长的两组行。 - 主键列名分两种:所有表一律小写
symbol;日期列在日线、5_technical_derived/、features_daily里是time,在l1_factors/l2_factors/l1_l2_factors里是date(l1_factors两者都有)。二者都是datetime64真日期,YYYYMMDD字符串只出现在基础表与财务表的TradingDate/m_timetag/m_anntime。 - 未来收益标签一律带
future_前缀:future_return_1d~future_return_60d,同时存在于features_daily与technical_indicators。 - L2 仅 2018 年起(合并宽表同理,2120 个交易日):训练窗口跨 2018 年时注意样本结构突变。
- 高缺失 L2 因子:
micro_jump_skew约 54% 缺失、micro_jump_recovery_time约 48%、micro_price_impact_large约 24%;其余micro_*/flow_*列中位缺失率接近 0。 - 估值因子有极端值:
fun_pe实测单日跨度 -1206 ~ +1069(含负 PE 与极小分母)。做中性化或线性模型时务必 winsorize / 分位数化。 - 特征与标签分离:
future_return_*是未来 N 日收益,属于 ML 标签,不是特征。把它们留在feature_name里就是直接标签泄漏。
口径原则
各目录 README 的字段表摘自 https://www.quantdb.cn/docs/fields.html,写入前已与实际 Parquet 逐列核对:列名、列数、口径一律以读到的数据为准。
许可与引用
- 数据许可:Apache License 2.0
- 仅供量化研究与学习使用,不构成任何投资建议
- 原始行情数据版权归交易所及上游数据服务商所有,请勿将数据用于商业再分发
- 使用者应自行核验数据准确性,本数据集不对因数据错误或遗漏造成的损失承担责任