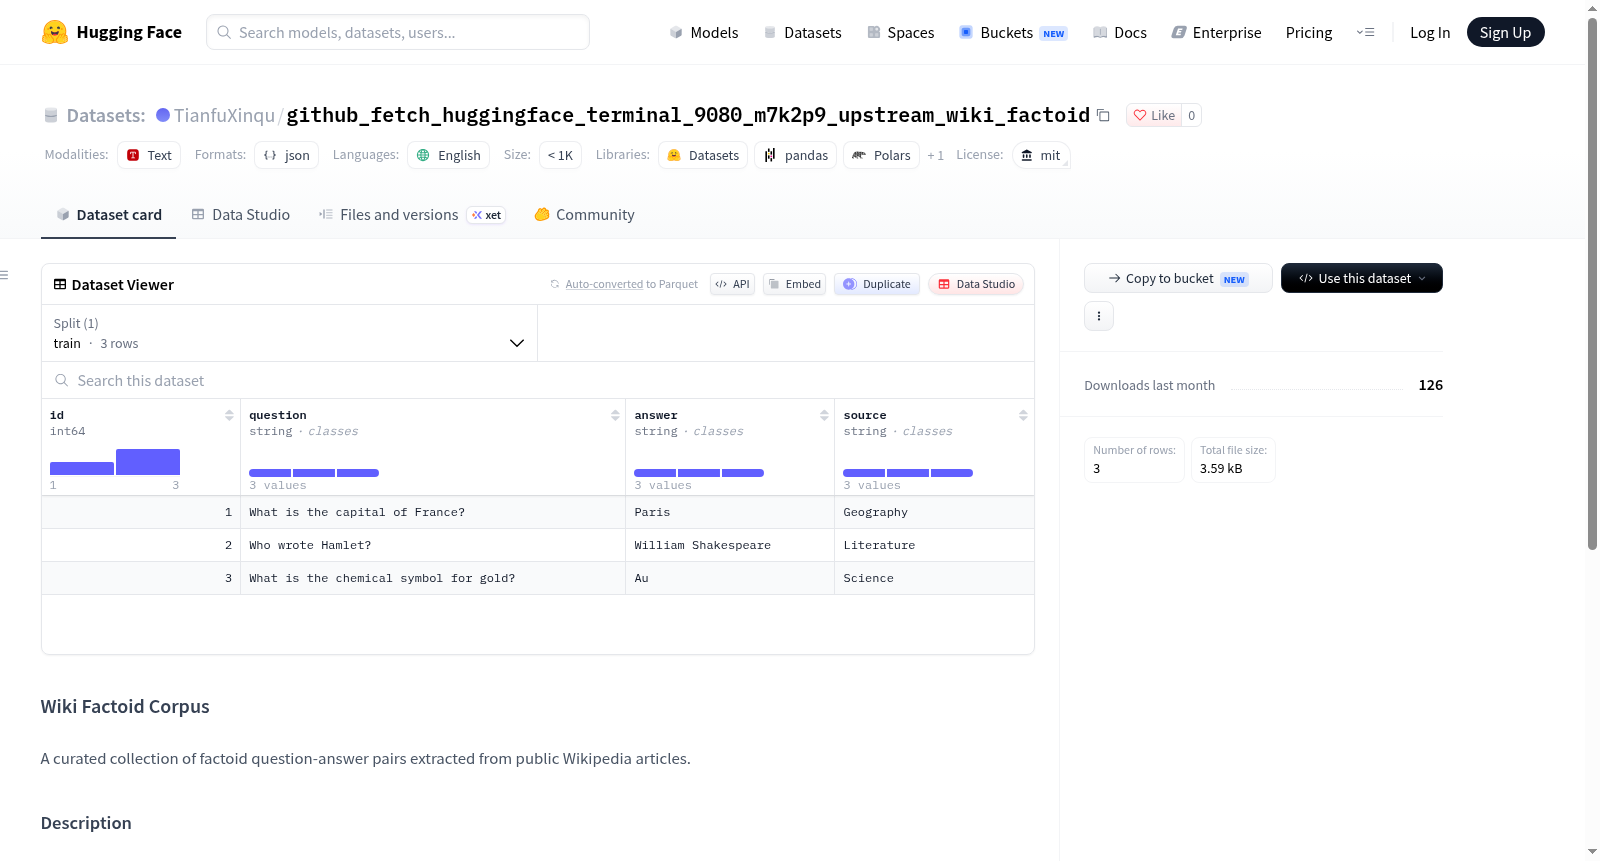
github_fetch_huggingface_terminal_9080_m7k2p9_upstream_wiki_factoid
收藏资源简介:
Wiki Factoid Corpus 是一个经过精心整理的事实性问答对数据集,所有问答对均从公开的维基百科文章中提取。该数据集包含12,000个问答对,涵盖地理、历史、科学、文化等常识知识领域。每条记录包含三个字段:问题(question)、规范答案(canonical answer)以及来源维基百科页面标题(source Wikipedia page title)。该数据集适用于抽取式问答、阅读理解以及实体关系研究等任务。数据集采用 MIT 许可证发布。
Wiki Factoid Corpus is a carefully curated dataset of factual question-answer pairs, all extracted from publicly available Wikipedia articles. The dataset contains 12,000 QA pairs covering common knowledge domains such as geography, history, science, and culture. Each record consists of three fields: question, canonical answer, and source Wikipedia page title. This dataset is suitable for tasks such as extractive question answering, reading comprehension, and entity relation research. The dataset is released under the MIT license.
数据集概述
本数据集名为 Wiki Factoid Corpus,是一个从公开维基百科文章中提取的、经过整理的事实型问答对集合。
基本属性
- 许可证:MIT License
- 语言:英语(en)
内容描述
该语料库包含 12,000 个问答对,覆盖通识知识领域,包括:
- 地理
- 历史
- 科学
- 文化
每条记录由以下字段构成:
- 问题(question)
- 标准答案(canonical answer)
- 来源维基百科页面标题(source Wikipedia page title)
适用场景
该数据集适用于以下研究和应用方向:
- 抽取式问答(Extractive QA)
- 阅读理解(Reading Comprehension)
- 实体关系研究(Entity-Relation Research)
使用许可说明
数据集以 MIT License 发布,允许自由使用、复制、修改、合并、出版、分发、再许可及销售数据集副本,但需保留原始版权声明。
来源与访问
该数据集托管于 Hugging Face 平台,可通过以下地址访问: https://huggingface.co/datasets/TianfuXinqu/github_fetch_huggingface_terminal_9080_m7k2p9_upstream_wiki_factoid