my_personal_dna_results
收藏资源简介:
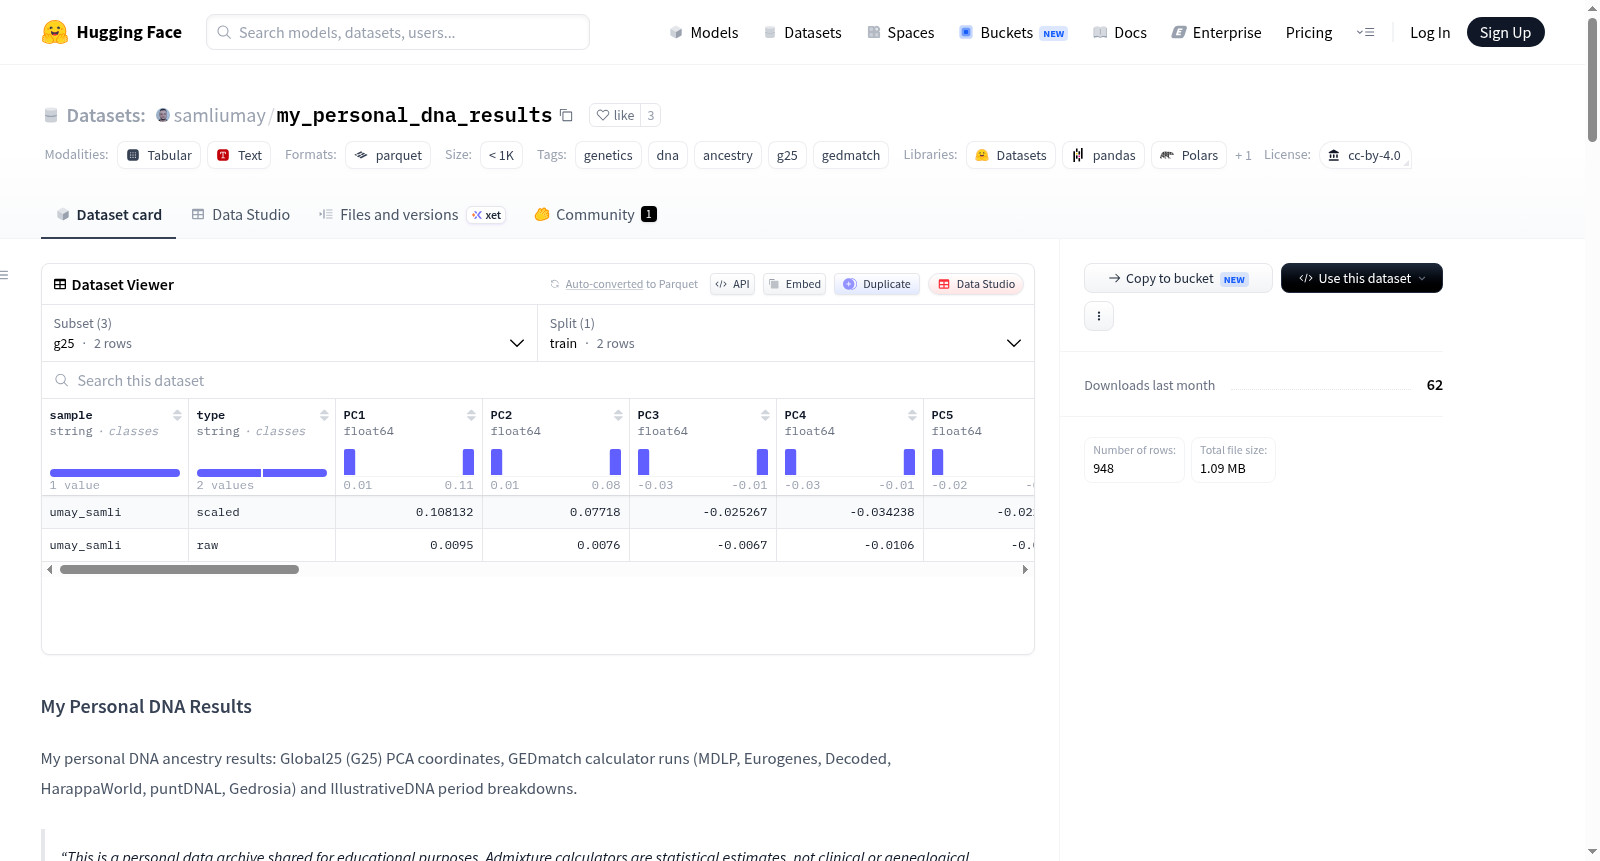
该数据集是个人DNA祖先结果存档,仅供教育目的使用。数据包含Global25 (G25)主成分分析坐标(缩放和原始值,25个主成分)、GEDmatch多个计算器(MDLP、Eurogenes、Decoded、HarappaWorld、puntDNAL、Gedrosia)的混合分析结果,以及IllustrativeDNA历史时期分解。数据以Parquet格式存储,分为三个子集:g25(G25坐标,含样本名称、类型、PC1-PC25字段)、admixture(186行混合百分比,含工具、计算器、排名、种群、百分比字段)、population_shares(760行种群共享,含工具、计算器、模式、排名、主种群、百分比、次种群、距离等字段)。此外,还提供CSV格式的坐标和Markdown格式的详细结果报告。数据集可用于遗传计算器演示、G25建模、PCA可视化和祖先成分分析。
This dataset is an archive of personal DNA ancestry results for educational purposes only. It includes Global25 (G25) principal component analysis coordinates (scaled and raw values, 25 principal components), admixture results from multiple GEDmatch calculators (MDLP, Eurogenes, Decoded, HarappaWorld, puntDNAL, Gedrosia), and IllustrativeDNA historical period breakdowns. The data is stored in Parquet format, divided into three subsets: g25 (G25 coordinates with fields for sample name, type, PC1-PC25), admixture (186 rows of admixture percentages with fields for tool, calculator, rank, population, percentage), and population_shares (760 rows of population shares with fields for tool, calculator, mode, rank, main population, percentage, subpopulation, distance). Additionally, CSV-formatted coordinates and Markdown-formatted detailed result reports are provided. The dataset can be used for genetic calculator demonstrations, G25 modeling, PCA visualization, and ancestry component analysis.
数据集概述
该数据集为个人DNA祖先结果存档,主要用于教育和研究目的,涵盖多种基因分析工具的输出结果。
核心内容
数据集包含三类机器可读文件(Parquet格式),以及对应的Markdown格式结果:
-
G25坐标(
data/g25_coordinates.parquet):包含25个主成分(PC1–PC25)的PCA坐标,分为scaled(推荐用于建模)和raw两种类型。样本名为umay_samli,可直接用于Vahaduo、nMonte等标准G25工具。 -
混合物结果(
data/admixture_results.parquet,186行):汇总所有19个计算器的“Admix Results”表格,字段包括tool(来源工具)、calculator(计算器名称)、rank、population(种群成分)和percent(估计百分比)。示例:HarappaWorld计算器将Caucasian排在第一位(35.18%),Baloch次之(17.62%)。 -
种群共享(
data/population_shares.parquet,760行):包含每个计算器的“Single Population Sharing”和“Mixed Mode Population Sharing”表格,字段包括mode(single或mixed)、primary_population、primary_percent、secondary_population、secondary_percent及distance。示例:Decoded K7b计算器中,56.2% Turkmens + 43.8% Ashkenazy Jews,距离为2.92。
覆盖的计算工具
| 工具 | 包含计算器 |
|---|---|
| MDLP | K11 Modern、K16 Modern、K23b、World-22、World |
| Eurogenes | K13、EUtest V2 K15、ANE K7、K9b–K12b、K36、HG vs Farmer、Jtest、EU Test |
| Decoded | V3、World 9、K7b、K12b |
| HarappaWorld | 全部 |
| puntDNAL | K10 Ancient、K12 Ancient/Modern、K13 Global、K15 |
| Gedrosia | K3、K12、Ancient Eurasia K6 |
| IllustrativeDNA | 坐标及历史时期拟合(青铜时代、铁器时代、晚古、中世纪等) |
其他资源
- PCA图:包含现代种群和历史时期(如奥斯曼安纳托利亚、罗马/拜占庭安纳托利亚、克里米亚鞑靼等)的PCA图。
- 原始笔记:
raw_notes.md保留未经编辑的原始记录。 - 视频:数据集页面提供深入解析视频链接(YouTube)。
许可与说明
- 许可证:CC BY 4.0
- 来源工具:GEDmatch计算器、Global25、IllustrativeDNA
- 声明:该数据集为个人数据存档,用于教育目的;混合物计算器结果为统计估计,不构成临床或家谱证据。