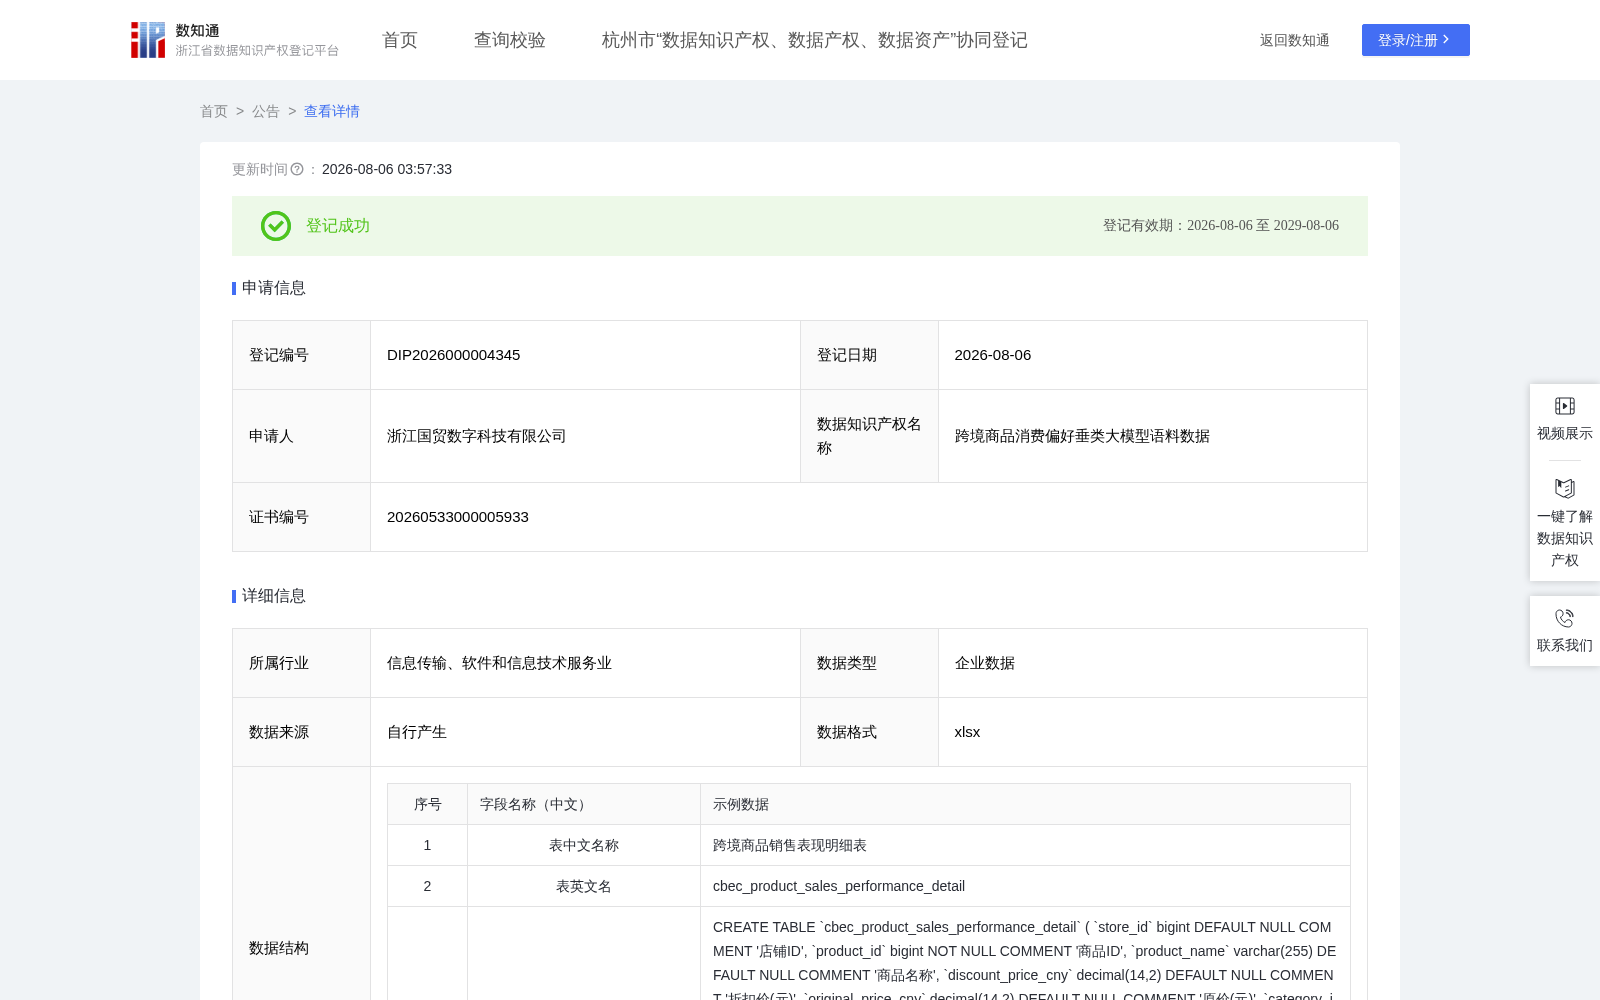
跨境商品消费偏好垂类大模型语料数据
收藏资源简介:
本数据产品专为训练跨境电商商品分析领域垂类大语言模型构建,旨在提升模型对商品销售表现、店铺结构、价格带分布、折扣策略、类目映射及异常商品识别等问题的理解能力,并将自然语言问题转换为可执行查询语句。数据以跨境商品销售明细为核心,包含店铺ID、商品ID、商品名称、折扣价、原价、品类信息、统计周期、销量、销售额及全品类汇总字段,可支持热销商品识别、头部店铺排行、主力品类判断、价格带渗透分析、折扣效果评估、爆款贡献测算及类目映射核查等业务场景。经训练后,模型可更准确理解“折扣价”“销量”“销售金额”“类目映射”“价格带分布”等高频概念,企业可结合自身商品库和订单库快速用于商品问答、选品辅助、价格分析、促销复盘及类目治理。对行业而言,这类语料能够把多语种商品信息、商品交易数据和经营分析需求连接起来,降低跨境电商企业对人工取数和人工写SQL的依赖,为商品运营智能化、数据分析能力建设以及垂类模型训练与评测提供更有针对性的基础数据支撑。1. 数据抽样与标准化 (1)业务对象整理与样本抽取:围绕商品价格、销量、销售金额、类目映射和店铺品类结构等业务对象,对中俄跨境商品消费偏好数据中的核心字段进行整理,形成基础语料样本。 (2)分层抽样与规模扩充:以店铺、品类、价格带、折扣阈值、销量阈值和统计周期表达为主要维度进行分层配置,并结合场景权重控制语料分布,避免热门场景过于集中。 (3)字段口径与格式标准化:统一问题表述、字段命名、类目映射口径和结果输出格式,确保问题、查询语句与结果一一对应。 2. 问题分类与结构化 按照跨境商品消费偏好分析的典型场景对问题进行归类,主要包括店铺热销商品排行、品类头部店铺排行、店铺主力品类结构、价格带偏好识别、高折扣与低折扣走量商品筛选、爆款贡献分析、异常商品定位、单品销售明细和中俄类目映射查询等,确保覆盖商品分析和选品辅助核心需求。 3. 核心算法建模 (1)统计周期语义解析与要素提取:针对源数据中的“2022.1-2022.3”以及问题中出现的“2022年一季度”“2022年1月至3月”等高频时间表达,采用基于规则的统计周期归一化方法,将自然语言中的周期描述统一映射到 stat_period 字段;同时提取查询对象(店铺、商品、中文类目、本地类目)、筛选条件(价格区间、销量阈值、销售额阈值、折扣率阈值)及聚合维度等关键要素,确保问题语义与字段口径一致。 (2)SQL语句生成:基于预定义的“商品分析术语-字段”映射规则和“查询意图-过滤条件”映射规则,自动组织标准化SQL查询语句。映射规则覆盖统计周期筛选、价格区间划分、多条件组合(AND/OR)、排序(ORDER BY)、结果截取(LIMIT)、聚合函数(COUNT/SUM/AVG/MAX/MIN)、分组统计(GROUP BY)以及占比和折扣率计算等常见SQL结构,重点强化价格带划分、折扣率计算、件均销售额计算和TopN分析能力。 (3)异常值检测:对生成的SQL及其执行结果进行双重校验。一方面,采用规则约束检测SQL逻辑异常,如统计周期缺失、筛选条件冲突、排序字段与结果描述不一致、占比计算缺少总量基准等;另一方面,结合折扣价、原价、销量和销售金额等字段的分布区间,对折扣率异常、销售额为0、极高价低销量、高销量低销售额等异常样本进行识别、打标或纳入异常识别场景,确保语料质量和业务可解释性。