
jaddai/openart-items-artifacts
收藏官方服务:
资源简介:
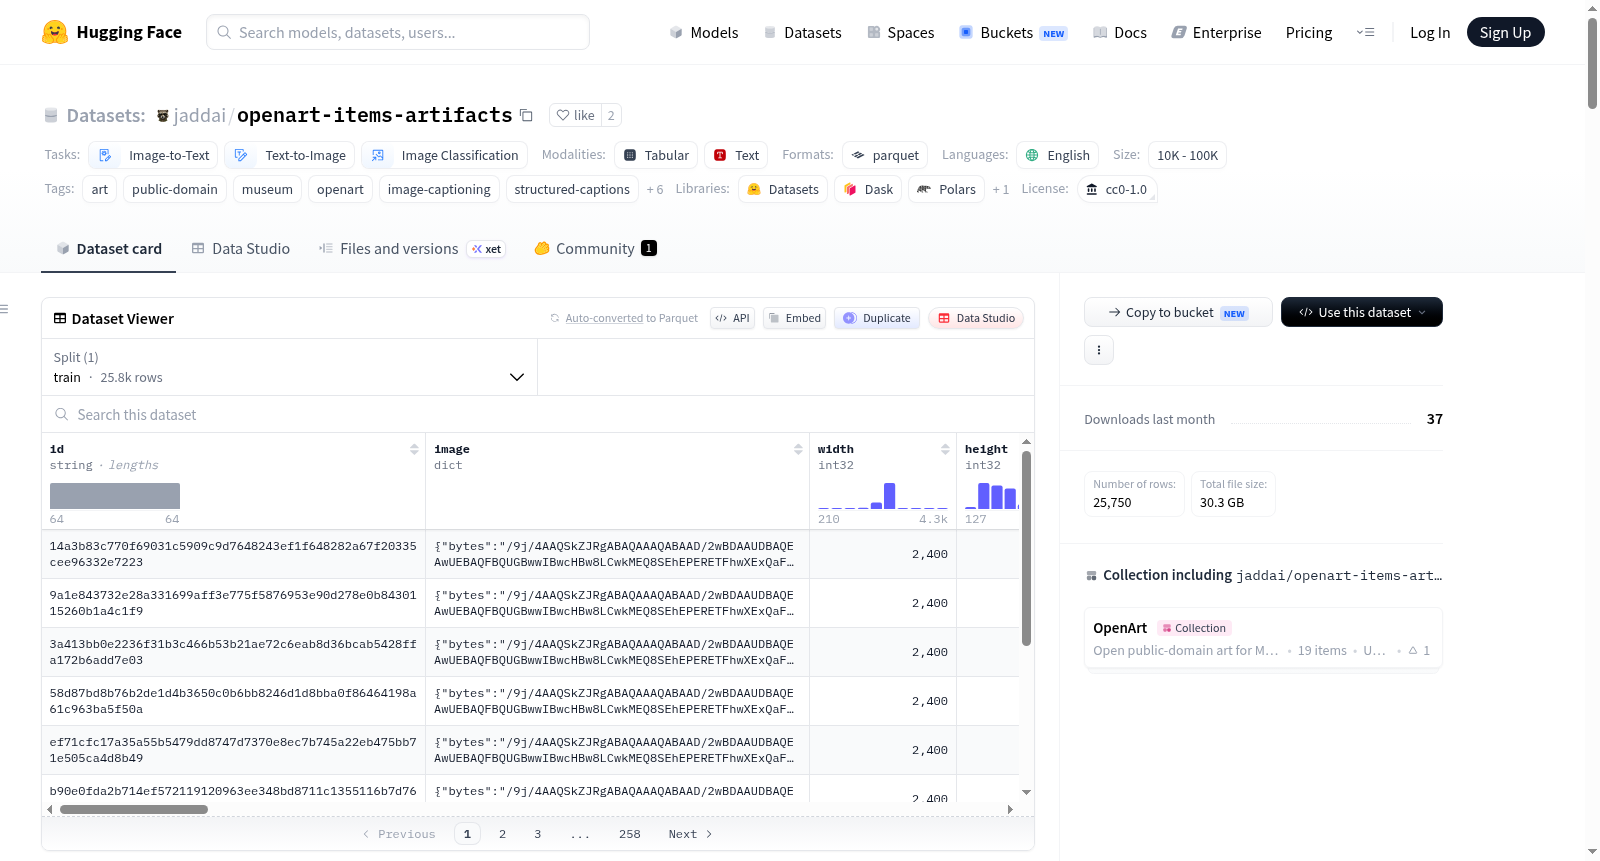
OpenArt数据集来自主要博物馆和图书馆的开放访问API(如大都会艺术博物馆、荷兰国立博物馆、克利夫兰艺术博物馆、芝加哥艺术学院、史密森尼学会、Europeana、维基媒体等)。与仅包含绘画的OpenBrush语料库不同,每个OpenArt主题集合都是混合媒介的:它包含二维艺术(绘画、版画、素描)和三维物体的照片(雕塑、陶瓷、金属制品、纺织品)。数据集通过brand列进行分割,以便用户可以选择所需的部分。
OpenArt draws from the open-access APIs of major museums and libraries (the Metropolitan Museum of Art, Rijksmuseum, Cleveland Museum of Art, Art Institute of Chicago, Smithsonian, Europeana, Wikimedia and others). Unlike the painting-only OpenBrush corpus, each OpenArt subject collection is mixed-medium: it contains both 2-D art (paintings, prints, drawings) and photographs of three-dimensional objects (sculpture, ceramics, metalwork, textiles). A `brand` column splits every row so you can take exactly the slice you want.
提供机构:
jaddai搜集汇总
数据集介绍
构建方式
OpenArt Items & Artifacts数据集源于对全球主要博物馆与图书馆开放访问API的深度整合,涵盖大都会艺术博物馆、荷兰国立博物馆、克利夫兰艺术博物馆、芝加哥艺术博物馆及史密森尼学会等机构。与专注绘画的OpenBrush系列不同,该数据集匠心独运地融合了二维艺术(绘画、版画、素描)与三维实物摄影(雕塑、陶瓷、金属工艺品、纺织品),形成混合媒介的藏品集合。每条数据通过`brand`字段清晰标识本源,便于用户精准抽取所需子集。数据的构建依托双模型视觉流水线:Gemma 4 31B负责生成涵盖九个语义段的结构化描述与主题路由,Gemini 3 Flash则执行二次验证,对媒介、归属及铭文进行像素级重新确认,确保元数据的可靠性。
特点
数据集收录25,750件公有领域作品,全部通过`rights_status: safe`安全核验,并采用CC0 1.0公共领域许可,无任何权利保留。其核心特色在于结构化v2描述体系,每幅图像配备九个语义段落(主题、动作、场景、氛围、风格、光线、色彩、构图及标签),为视觉语言模型提供丰富且规整的训练素材。另一独特设计是`brand`分割机制,将数据自然划分为`openbrush`(11,317件二维艺术)与`openartifacts`(14,216件实物摄影)两大类别,支持跨媒介对比研究。此外,3,960条记录标注了创作者姓名,其中3,304条经签名验证,铭文验证条目达8,962条,为艺术史分析提供了严谨的溯源基础。
使用方法
数据集可通过Hugging Face的`datasets`库便捷加载,基础用法为`load_dataset("jaddai/openart-items-artifacts", split="train")`,直接返回25,750条完整记录。针对不同研究需求,用户可利用`filter`方法按`brand`字段分离二维绘画与实物摄影,或通过`signature_verified`布尔值筛选经过签名验证的可信归属数据。`medium`字段支持精细的媒介过滤,如`ds.filter(lambda r: r["medium"] == "sculpture")`即可提取全部雕塑作品。该数据集适用于扩散模型微调、视觉语言模型精调、媒介分类任务及跨媒介艺术主题研究,其结构化描述与丰富的元数据字段为多模态学习提供了高质量的标准化语料。
背景与挑战
背景概述
openart-items-artifacts数据集是OpenArt系列中专注于物品与工艺品的专题集合,于2026年由研究者jaddai创建,整合自大都会艺术博物馆、荷兰国立博物馆、克利夫兰艺术博物馆、芝加哥艺术学院及史密森尼学会等多家顶级文博机构的开放获取资源。该数据集包含25,750件公共领域作品,其中涵盖11,317幅二维绘画与版画作品以及14,216件三维物品摄影图像,每件作品均配有结构化视觉语言模型描述及媒材、归属与题跋元数据。通过引入跨媒材分类品牌字段(openbrush与openartifacts),该数据集突破了传统艺术数据集仅聚焦绘画的局限,为图像生成、视觉语言模型微调及媒材分类研究提供了兼顾二维艺术与三维物质文化的多模态研究平台。
当前挑战
该数据集所应对的核心领域挑战在于解决艺术图像数据集长期存在的媒材单一问题,即多数公开数据集仅收录绘画或摄影,而忽视了雕塑、陶瓷、金属工艺等立体工艺品及其在二维再现中的视觉差异,从而限制了对物质文化全貌的计算研究。在构建过程中,数据清洗面临多重困境:需要从汇聚源(如Europeana、Wikimedia)中剔除版权不明晰的记录以保证CC0许可的绝对可靠性;AI生成的标题与归属标注需经双模型验证管线(Gemma 4 31B生成、Gemini 3 Flash核验)才能建立可信度,其中仅有3,304件(占署名作品的83.4%)获得签名验证;此外,跨机构元数据格式差异、题跋文字的OCR识别可靠性以及西方中心馆藏的样本偏差,均为数据集的质量控制与泛化应用带来了持续挑战。
常用场景
经典使用场景
在视觉与语言模型的交叉领域中,OpenArt Items & Artifacts 数据集因其跨媒介、结构化的特性而被广泛采纳,常用于图像描述生成(Image Captioning)与多模态理解任务的微调。每一幅图像均配备了包含主题、动作、环境、情绪、风格、光照、色彩与构图九大语义栏位的结构化标题,使得模型能够学习到层次分明、细节丰富的艺术描述范式。此外,该数据集的‘品牌’标签(openbrush 与 openartifacts)为区分二维绘画与三维器物提供了天然的分组依据,推动了跨媒介艺术研究的发展。研究者亦常利用其丰富的媒介与标签信息,进行细粒度的图像分类与风格迁移训练,探索从雕塑到金属器皿等不同材质在视觉表征中的差异。
解决学术问题
长期以来,艺术计算领域面临两大痛点:一是缺乏覆盖二维与三维人造物的高质量公开数据集,二是图像元数据常缺失结构化的语义描述。OpenArt Items & Artifacts 数据集通过整合全球顶级博物馆的开源资源,构建了包含25,750幅公域图像且每个样本均带有9段式结构化标题的语料库,有效填补了物质文化与装饰艺术在计算机视觉研究中的空白。它解决了学术研究中跨媒介比对困难的问题,使学界得以系统性地比较同一主题在绘画与器物两种载体上的表现异同。同时,数据集内置的签名验证字段(signature_verified)为艺术品归属研究提供了可量化的可信度指标,降低了依赖不可靠归属标签导致的分析偏差,从而推动了艺术史计算、文化计量学与数字人文领域的实证研究。
衍生相关工作
该数据集的发布催生了一系列具有代表性的衍生研究工作。在生成式模型领域,研究者基于其结构化标题与CC0许可特性,构建了面向特定媒介(如雕塑或木刻)的扩散模型微调管线,实现了风格可控的艺术图像生成。在多模态理解方面,其九段式标题被用作训练视觉大语言模型(VLLM)进行细粒度艺术描述的基准,显著提升了模型对器物材质、工艺与铭文等专业属性的识别精度。此外,部分工作聚焦于签名验证与归属分析,利用数据集中signature_verified字段训练分类器,自动判定艺术品创作者的标识可信度,为博物馆验证系统提供了技术原型。数据集的跨平台集成性亦被认可,官方提供的Hugging Face Datasets接口与Python过滤函数被多个学术论文引用,成为物质文化与装饰艺术计算研究的标准参考资源。
以上内容由遇见数据集搜集并总结生成


