app-review-complaint-benchmarks
收藏资源简介:
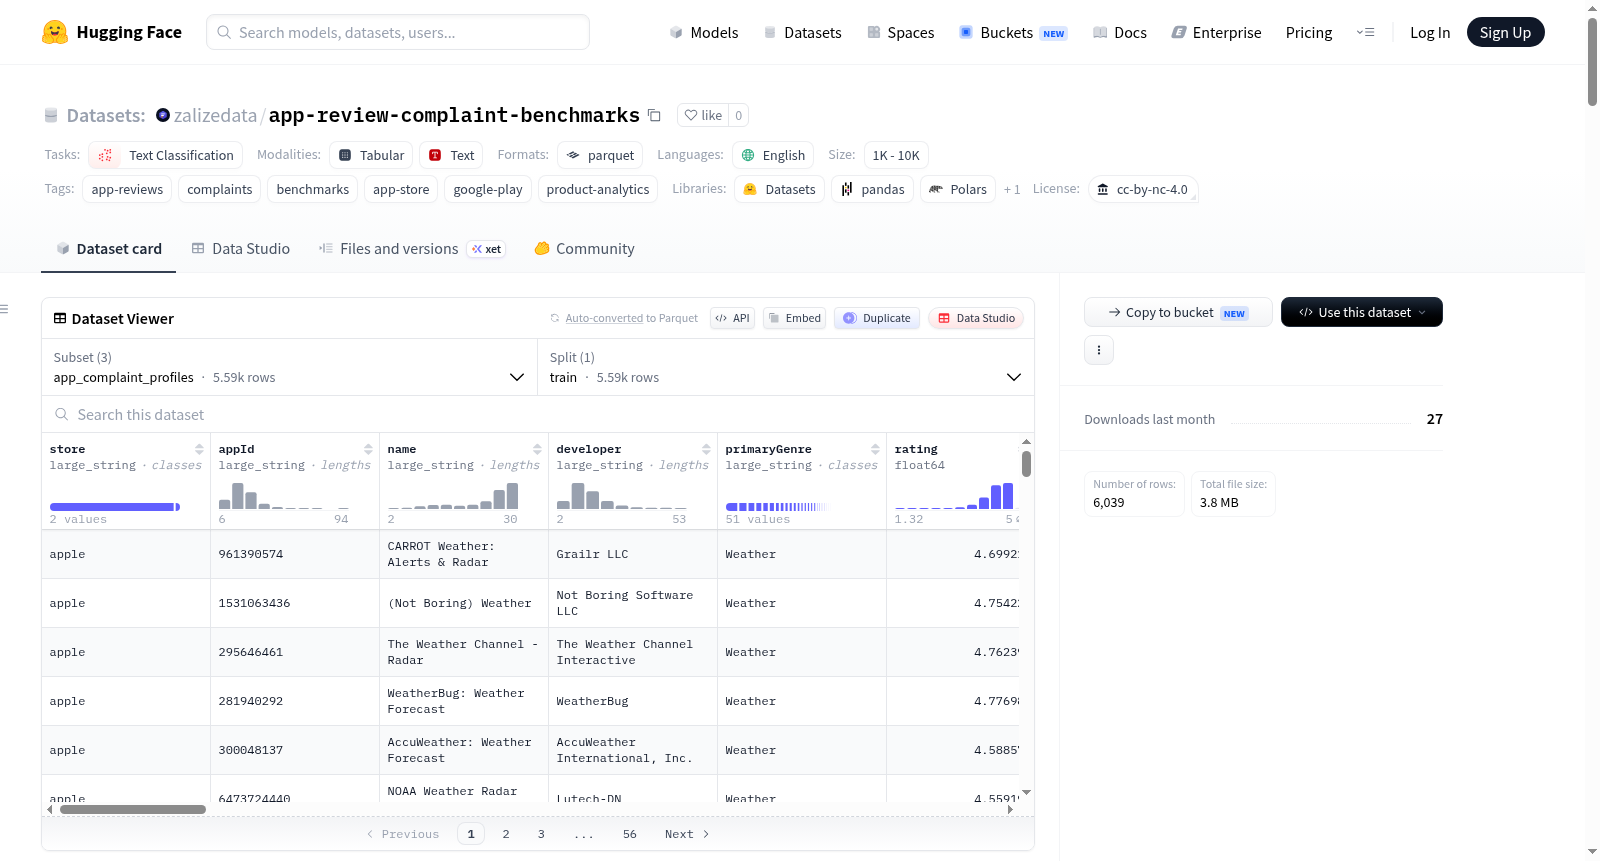
该数据集是应用评论投诉基准,包含来自 Apple App Store 和 Google Play 的真实评论数据,涵盖 5,592 个应用、47 个应用商店类别。数据集基于对负面评论(1-2 星评分)的投诉主题分析,识别出 8 个标准投诉主题(如崩溃/错误、广告、计费/订阅、登录/账户、性能、用户体验/设计、支持、隐私/权限)。数据集包含三个子集: - **app_complaint_profiles**:每个应用的投诉档案,包含各投诉主题的评论占比、与所在类别中位数的偏差、以及超过类别 75% 分位数的主题数量。 - **category_benchmarks**:每个类别在各投诉主题上的百分位数分布(p25、p50、p75、p90),以及情感指标等基准统计。 - **topic_leaderboards**:每个投诉主题下投诉占比排名前 50 的应用列表(即最差应用排行榜)。 数据以 Parquet 格式存储,总行数根据配置不同在 5,368 至 6,039 行之间。字段包括商店标识、应用 ID、名称、开发者、评级、评论数、情感得分、各投诉主题占比等。该数据集适用于文本分类、竞争分析、产品路线图优化、应用营销策略发现等场景。许可证为 CC BY-NC 4.0,学术/个人使用需注明出处并链接回数据源,商业使用需获取商业许可。
This dataset is an app review complaint benchmark, containing real review data from Apple App Store and Google Play, covering 5,592 apps and 47 app store categories. The dataset is based on complaint topic analysis of negative reviews (1-2 star ratings), identifying 8 standard complaint topics (e.g., crash/bug, advertisement, billing/subscription, login/account, performance, UX/design, support, privacy/permission). It includes three subsets: app_complaint_profiles (complaint profiles per app), category_benchmarks (percentile distributions of complaint topics per category), and topic_leaderboards (top 50 apps with highest complaint ratios per topic). Data is stored in Parquet format, with total rows ranging from 5,368 to 6,039 depending on configuration. Fields include store identifier, app ID, name, developer, rating, review count, sentiment score, complaint topic ratios, etc. The dataset is suitable for text classification, competitive analysis, product roadmap optimization, and app marketing strategy discovery. Licensed under CC BY-NC 4.0, with attribution required for academic/personal use and commercial license needed for commercial use.
App Review Complaint Benchmarks 数据集概述
数据集简介
该数据集提供5,592个应用在47个应用商店类别中的投诉主题基准数据,基于真实的 Apple App Store 和 Google Play 评论数据计算得出。内容包括各应用按主题(崩溃、广告、计费、用户体验等)的投诉率与类别基线的对比,以及各主题的“最差应用”排行榜。
- 授权协议:CC BY-NC 4.0(仅限学术/个人使用,商用需单独许可)
- 语言:英语
- 任务类型:文本分类
- 数据规模:1K < n < 10K
数据配置与内容
数据集包含三个配置(config),均以 Parquet 格式存储:
1. app_complaint_profiles(5,592行)
每个应用一条记录,包含应用元数据(商店、ID、名称、开发者、类别、评分等)以及8个投诉主题的投诉占比(complaintShare_*字段),以及与类别中位数对比的差异值(delta_*字段)。字段覆盖崩溃/错误、广告、计费/订阅、登录/账号、性能、UX设计、客服支持、隐私/权限等主题。
2. category_benchmarks(47行)
每个应用商店类别一条记录,包含各投诉主题的百分位基准值(p25/p50/p75/p90),其中p75被用作判定“投诉超标”的报警线,用于计算 topicsAboveBenchmark 指标。
3. topic_leaderboards(400行)
按8个投诉主题分别排名的排行榜,每个主题50个“最差”应用,包含该应用在主题上的投诉占比及与类别中位数的偏差。
数据包版本与规模
| 数据包 | 层级 | 行数 | 大小 |
|---|---|---|---|
| complaint-benchmarks-tier1-S-2026-08-02.zip | S | 5,368 | 0.9 MB |
| complaint-benchmarks-tier1-M-2026-08-02.zip | M | 5,639 | 1.0 MB |
| complaint-benchmarks-tier1-L-2026-08-02.zip | L | 6,039 | 1.0 MB |
- S包:仅Google Play数据,含类别投诉基线与应用画像
- M包:双商店数据,含全部类别基线与应用投诉画像
- L包:完整版本,另含各主题前50名最差应用排行榜
- 每个包均附带数据字典、数据说明文档及许可证文件
应用场景
- 竞品弱点挖掘与竞品分析
- 产品路线图优先级排序(基于投诉差距)
- 应用营销卖点发现
- 并购/投资中的应用组合尽职调查
使用方法
python from datasets import load_dataset
ds = load_dataset("zalizedata/app-review-complaint-benchmarks", "app_complaint_profiles", split="train") print(ds[0])
数据来源与方法
数据由 DataForge 基于真实应用商店评论数据计算聚合指标生成。完整的覆盖范围、更新周期及字段级数据字典可在数据集官方页面(https://data.zalize.com/datasets/app-review-complaint-benchmarks)查看。