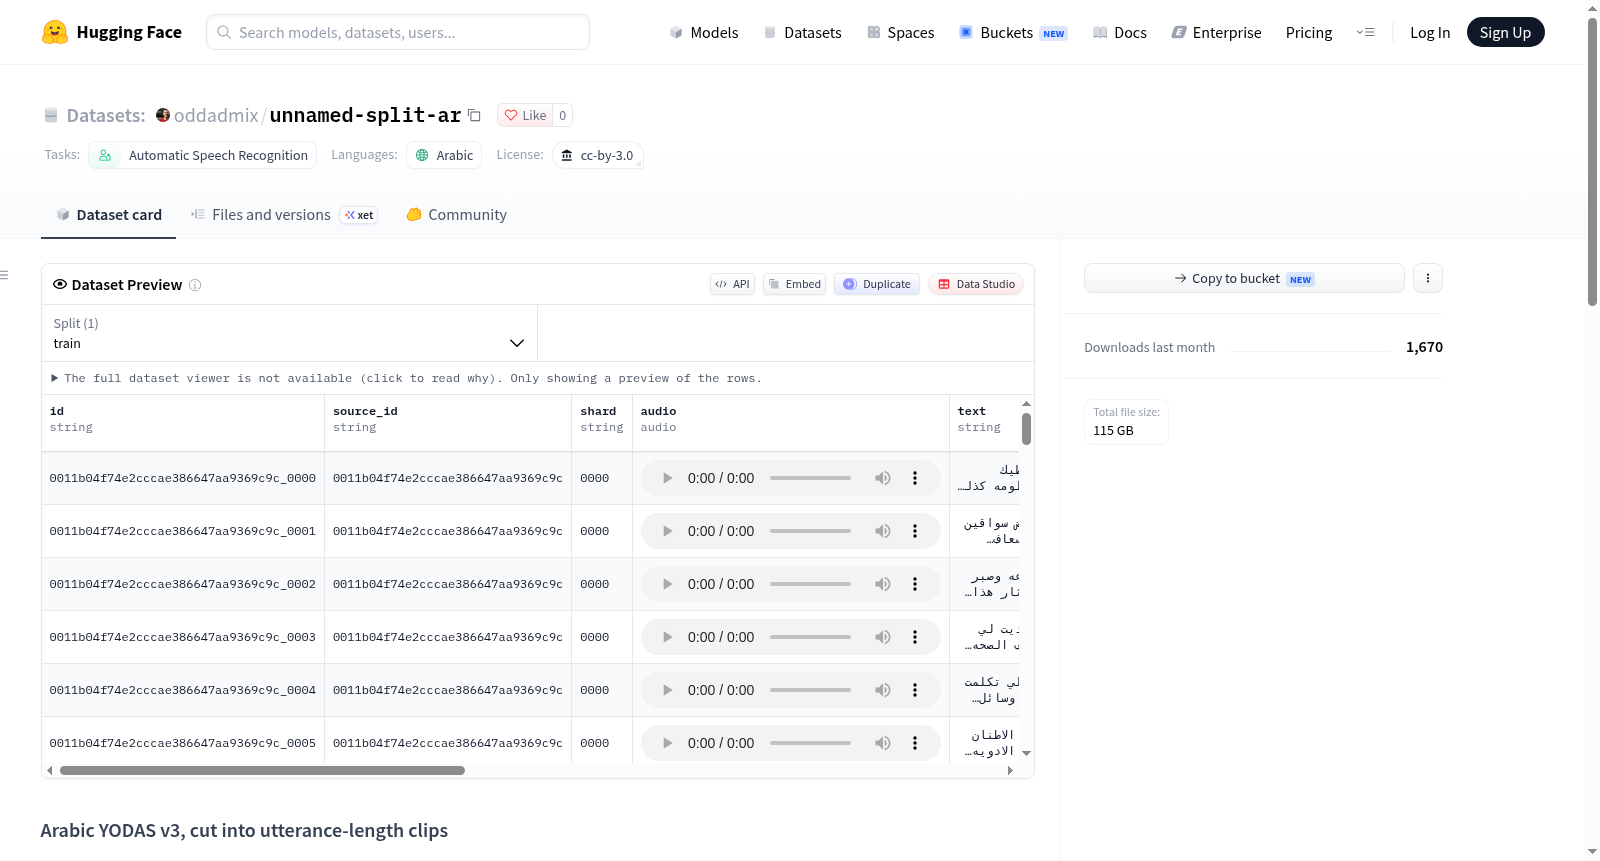
unnamed-split-ar
收藏资源简介:
该数据集是阿拉伯语YODAS v3数据集的改进版本,通过使用Silero VAD(语音活动检测)将长录音(中位长度约5分钟)依据静音段切割为5-45秒的语音片段,每个片段附带对应的转录文本。切割点基于至少150毫秒的停顿,确保不落在语音中间。数据集提供每个片段的起始时间、结束时间、持续时间、语音比例(VAD判定的语音占比)、是否干净切割(clean_cut)等字段。音频格式为Opus 48 kbps 16 kHz单声道Ogg。文本来自YouTube字幕,经过过滤:移除无文本、重复字幕、非语音标记(如[موسيقى])、语音比例低于35%或每字符时长异常(1-30字符/秒)的片段。方言标签(dialect)来自Nawah-Dialect-BERT-6M模型在整段源录音上的预测,包括13种阿拉伯方言和现代标准阿拉伯语(msa),并附带所有14类的概率分布(dialect_probs)。请注意,方言标签是预测结果,可能反映文本语体而非说话人口音,且转录本身由机器生成。数据集按source_id分组,建议按source_id而非行进行数据划分,以避免同一说话人或主题出现在训练和验证集中。许可证为CC-BY-3.0。
This dataset is an improved version of the Arabic YODAS v3 dataset. It uses Silero VAD (Voice Activity Detection) to split long recordings (median length ~5 minutes) into 5-45 second audio segments based on silence intervals, each with corresponding transcription text. The splitting points are based on pauses of at least 150 milliseconds to ensure they do not fall within speech. The dataset provides fields such as start time, end time, duration, speech ratio (proportion of speech determined by VAD), and clean_cut for each segment. Audio is in Opus 48 kbps 16 kHz mono Ogg format. Text comes from YouTube subtitles and is filtered: removing segments with no text, duplicate subtitles, non-speech markers (e.g., [موسيقى]), speech ratio lower than 35%, or abnormal per-character duration (1-30 characters/sec). Dialect labels (dialect) are predicted by the Nawah-Dialect-BERT-6M model on the full source recording, including 13 Arabic dialects and Modern Standard Arabic (msa), with probability distributions for all 14 classes (dialect_probs). Note that dialect labels are predictions and may reflect the text register rather than the speakers accent, and the transcription itself is machine-generated. The dataset is grouped by source_id, and it is recommended to split data by source_id rather than by rows to avoid the same speaker or topic appearing in both training and validation sets. License: CC-BY-3.0.
数据集概述
基本信息
- 数据集地址:https://huggingface.co/datasets/oddadmix/unnamed-split-ar
- 许可证:CC-BY-3.0(继承自 YODAS v3)
- 任务类别:自动语音识别(automatic-speech-recognition)
- 语言:阿拉伯语(ar)
- 配置名称:default
- 划分:train(数据文件路径:data/train-*.parquet)
数据集描述
该数据集是 espnet/yodas3 的 data/ar/ 分区,将长录音(中位数约 5 分钟)切分为 5-45 秒的片段,每个片段带有独立转录文本,可直接用于 ASR 训练的批处理,无需进一步分割。
音频格式:Ogg 格式,Opus 48 kbps 单声道,16 kHz。
加载方式
python from datasets import load_dataset ds = load_dataset("oddadmix/unnamed-split-ar", split="train", streaming=True)
切分来源
上游时间戳为 YouTube 字幕提示(caption cues),并非话语片段。在 data/ar 的一个分片上测量结果:
- 71.8% 的连续提示严格重叠(中位间隔 -2.36 秒):
start + duration表示提示在屏幕上停留的时长,而非语音结束时间。 - 仅 9.7% 的提示边界存在 ≥ 0.3 秒的真实静音间隔,因此在字幕边界切分会导致大多数切点落在连续语音内部。
- 将字幕边界吸附到附近最安静的窗口也无法解决该问题:经独立 VAD 评分,54.8% 的此类切点仍落在语音中。
因此本数据集的切分方式相反:使用 Silero VAD 检测停顿,仅允许 ≥ 150 毫秒的停顿作为切点,然后将转录文本分配给产生的片段。相同测量方式下,0.0% 的切点落在语音中。
由于文本随切分而定,在有词级时间戳的提示中(68% 的提示)通过词时间进行分配,否则按多数重叠分配。cues 保留了贡献的提示片段及其在片段内重定位的时间戳和 partial 标志,因此词级对齐仍可推导。
clean_cut 在超过 45 秒的语音段内无停顿、不得不超限强制切分时为 false;这些片段在此数据集中已被丢弃。speech_ratio 是 VAD 判定为语音的片段比例。
start/end 定位片段在源录音中的位置,source_id 将来自同一源录音的片段分组——请按 source_id 而非按行划分,否则同一说话人和主题会同时出现在划分的两侧。
应用的过滤
- 丢弃无文本的提示,以及连续重复的提示文本(部分录音会重复播放同一频道结尾字幕达数分钟)。
- 移除非语音标记(
[موسيقى]、[ضحك]等);剩余无文本的片段被丢弃。 - 丢弃 VAD 语音比例低于 35% 的片段,以及每秒字符数在 1-30 范围之外的片段(视为静音或错位)。
方言标签
dialect 为 13 种阿拉伯语方言之一或 msa,由 Nawah-Dialect-BERT-6M 预测,在整个源录音上预测后复制到其每个片段——单个片段的文本太少,无法可靠分类。dialect_probs 包含全部 14 个类别的概率。
这些是预测结果而非真实标注:它们反映的是转录文本的语言语域,而非说话人的口音,且转录文本本身也是机器生成的。
数据字段
| 字段名 | 类型 | 说明 |
|---|---|---|
| id | string | 标识符 |
| source_id | string | 源录音分组标识 |
| shard | string | 分片 |
| audio | audio | 音频 |
| text | string | 转录文本 |
| start | float64 | 片段在源录音中的起始位置 |
| end | float64 | 片段在源录音中的结束位置 |
| duration | float64 | 时长 |
| clean_cut | bool | 是否为干净切分 |
| speech_ratio | float32 | 语音比例 |
| n_cues | int32 | 提示数量 |
| cues | string | 贡献的提示片段 |
| dialect | string | 方言标签 |
| dialect_score | float32 | 方言得分 |
| dialect_probs | struct | 14 类别方言概率(bh、dz、eg、iq、lb、ly、ma、msa、ps、sa、sd、sy、tn、ye) |
| transcript_lang | string | 转录语言 |
| locale_lang | string | 本地语言 |
| source_length | float64 | 源录音长度 |
来源说明
CC-BY-3.0,继承自 YODAS v3。音频从上游 Opus 解码,重采样为 16 kHz 单声道并重新编码,因此属于第二代有损生成。