
b09902056/global_MMLU_10
收藏官方服务:
资源简介:
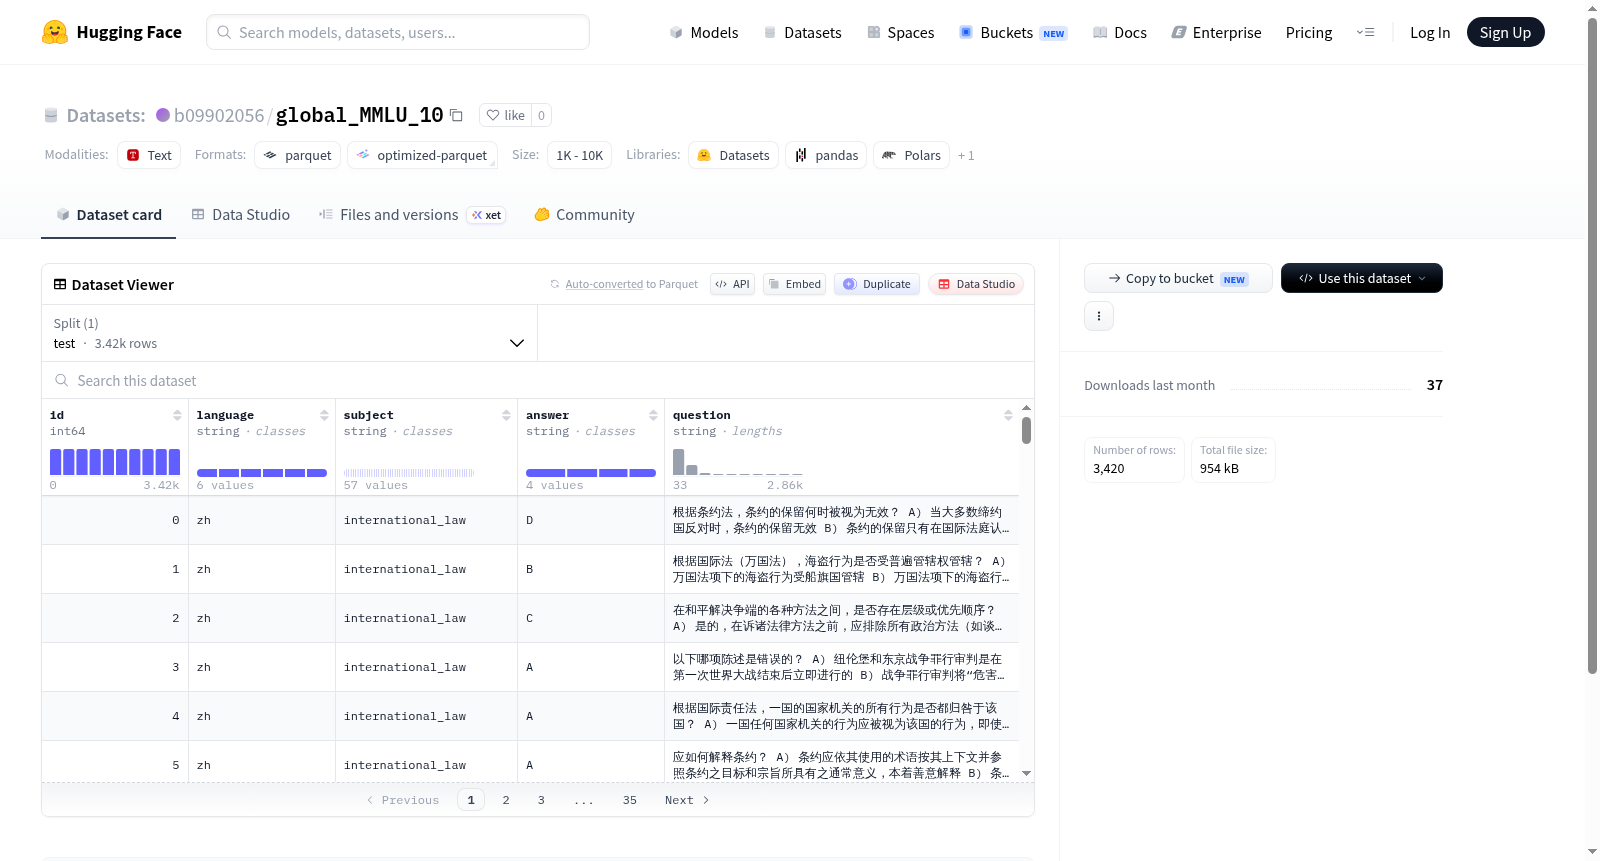
这是一个多语言、多学科的问题回答数据集,包含3420个测试示例。每个示例具有唯一ID、语言标识、学科主题、问题和答案字段,用于支持自然语言处理任务,如问答系统或跨语言学习。
This is a multilingual, multi-subject question-answering dataset containing 3,420 test examples. Each example includes unique ID, language identifier, subject topic, question, and answer fields, designed to support natural language processing tasks such as QA systems or cross-lingual learning.
提供机构:
b09902056搜集汇总
数据集介绍
构建方式
该数据集基于大规模多任务语言理解(MMLU)基准进行全球化扩展构建,针对不同语言环境下的知识覆盖需求,精心筛选并翻译了涵盖人文、社科、自然科学等多领域的题目。每个样本包含唯一标识符、语言标签、学科类别、问题文本及标准答案,确保数据结构的完整性与通用性。数据划分为测试集,共计3420个示例,以结构化的方式存储于固定格式文件中,便于直接调用。
特点
global_MMLU_10显著突破了传统MMLU仅限英文的局限,通过多语言适配,使得模型能在不同文化背景下评估知识理解能力。其数据规模虽精简但覆盖广泛,每个样本均标注了语言与学科信息,便于进行细粒度分析。数据集设计高度标准化,兼容常见机器学习框架,为跨语言评估与知识迁移研究提供了可靠的基准资源。
使用方法
数据集以HuggingFace标准格式存储,可直接通过datasets库加载,指定配置为'default'并读取'test'分割即可获取所有样本。使用时需根据语言和学科字段进行过滤,以适配特定评估场景。加载后的数据以字典形式呈现,包含id、language、subject、question和answer键,方便进行模型推理与精度计算,特别适用于多语言知识问答系统的性能测试。
背景与挑战
背景概述
global_MMLU_10数据集诞生于大规模多任务语言理解研究的蓬勃发展时期,由国际自然语言处理领域的研究人员共同构建,旨在填补多语言知识评估基准的空白。该数据集聚焦于涵盖10种语言的学术与专业知识问题,通过跨学科、跨语言的题目设计,系统评估语言模型在全球化语境下的推理与知识掌握能力。其核心研究问题在于探索模型能否超越英语中心主义的局限,在多元文化环境中展现一致的知识迁移与理解深度。自发布以来,global_MMLU_10成为检验多语言预训练模型泛化能力的重要标杆,推动了低资源语言与高资源语言之间知识对齐的研究,显著提升了学界对语言模型跨文化适应性的关注。
当前挑战
该数据集所面临的挑战首先源于领域问题的复杂性:多语言知识评估要求模型同时处理语言差异、文化偏见与学科专精的鸿沟,而现有模型在低资源语言上的表现往往远逊于英语,凸显了知识分布不均的深层困境。在构建过程中,研究者遭遇多源难题:跨语言题目的语义等价性难以精确把控,不同语言间的文化特有问题导致直接翻译失效;数据整合阶段,部分语言可用资源匮乏,需要依靠少量样本与人工校验反复迭代,以确保测试集的覆盖广度与答案的可靠性。这些挑战共同刻画了在多语言环境中实现公平、全面评估的艰难历程。
常用场景
经典使用场景
在全球多语言知识理解与推理评测的学术前沿,global_MMLU_10数据集作为MMLU(Massive Multitask Language Understanding)的多语言变体,承担着衡量大语言模型跨语言知识迁移能力的基准角色。该数据集精选了涵盖数十个学科领域的测试样本,横跨科学、人文、社科等多维度,尤其聚焦于十种代表性语言的高质量翻译与本地化问题。经典使用场景包括多语言预训练模型的零样本与少样本性能评估,旨在揭示模型在非英语语种下的知识储备与逻辑推演水平。研究者常借助global_MMLU_10来验证模型是否真正习得了跨语言通用知识,而不仅是表层语义对齐。这一场景为国际学术界提供了标准化、低偏差的评测框架,有力推动了多语言人工智能系统的横向比较与迭代优化。
解决学术问题
在自然语言处理领域,长期存在的核心难题在于如何公正评估大语言模型在多语言环境下的知识广度与推理深度。传统基准如MMLU仅聚焦英语,导致模型优化过度偏向高资源语种,掩盖了其在低资源语言中的真实表现。global_MMLU_10通过构建包含十种语言、覆盖57个学科的连贯性测试集,有效解决了跨语言知识迁移能力的量化难题。它使得研究者能够精确诊断模型在不同语系间的知识断裂现象,例如模型在数学题上的回答一致性会随着语言切换而波动。该数据集的发布引发了关于多语言模型泛化边界的大讨论,促使学界重新审视预训练语料的语言分布策略,为构建更公平、去中心化的语言智能提供了关键解药。
衍生相关工作
global_MMLU_10数据集的诞生催生了一系列富有启发性的学术工作。其母本MMLU催生了众多专业子集,而global_MMLU_10则进一步衍生出针对特定语系(如罗曼语族)或学科(如法律)的深度分析研究。例如,Huang等人基于该数据集的衍生版本探讨了机器翻译质量对知识评测结果的影响,揭示了翻译歧义如何扭曲模型性能;另一项经典工作则利用global_MMLU_10构建了多语言提示策略对比框架,验证了跨语言思维链推理的效能边界。此外,该数据集还被整合进Open LLM Leaderboard的多语言评测分支,成为评估Llama、GPT等主流模型国际化的标准参照。这些衍生工作共同拓展了多语言知识理解的研究疆域。
以上内容由遇见数据集搜集并总结生成


