遇见数据集

cia-declassified-reading-room

收藏
Hugging Face2026-07-04 更新2026-07-05 收录
官方服务:

资源简介:

该数据集是一个基于CIA(美国中央情报局)解密阅览室及CREST(CIA记录搜索工具)公共记录构建的语料库镜像。数据来源包括官方的CIA电子阅览室公开记录,以及当直接访问受限时使用的互联网档案馆镜像,确保获取相同的公共领域文件。数据集以分批次、可恢复的流式管道方式构建,不存储完整语料库于本地。数据文件包含元数据(如`documents.jsonl.gz`)、提取的文本(`texts.jsonl.gz`)、可选的PDF原始文件分片(`pdfs.zip`)以及爬取报告。数据集旨在保存原始CIA文档标识符和来源出处,适用于历史研究、文本分析、信息检索等与解密政府文档相关的自然语言处理任务。

This dataset is a corpus mirror constructed based on declassified reading rooms of the CIA (Central Intelligence Agency) and public records from CREST (CIA Records Search Tool). Data sources include official CIA electronic reading room public records, as well as Internet Archive mirrors used when direct access is restricted, ensuring the acquisition of the same public domain files. The dataset is built in a batch-wise, resumable streaming pipeline manner, without storing the complete corpus locally. Data files include metadata (e.g., `documents.jsonl.gz`), extracted text (`texts.jsonl.gz`), optional original PDF file shards (`pdfs.zip`), and crawling reports. The dataset aims to preserve original CIA document identifiers and source provenance, and is suitable for natural language processing tasks related to declassified government documents, such as historical research, text analysis, and information retrieval.

创建时间:
2026-07-04
原始信息汇总

数据集概述

本数据集是CIA解密阅览室(CIA Declassified Reading Room / CREST)公共记录的Hugging Face镜像库,由流式处理管道构建,无需在本地存储完整语料库。

目标账户

  • manus4oHER

数据集结构

数据集以分片方式组织,包含以下主要组件:

组件 格式 说明
metadata/<source>/<batch_id>/documents.jsonl.gz JSONL (gzip) 文档元数据
texts/<source>/<batch_id>/texts.jsonl.gz JSONL (gzip) 文档文本内容
pdf_shards/<source>/<batch_id>/pdfs.zip ZIP PDF文件(可选,启用时生成)
reports/<source>/<batch_id>/crawl_report.json JSON 爬取报告
manifests/source_config.json JSON 源配置文件
scripts/ 脚本 可复现爬取脚本

数据来源范围

  • 主要来源:CIA电子阅览室 / CREST公共记录
  • 备用来源:当CIA实时端点出现重定向循环或阻止程序化访问时,使用Internet Archive上的CIA CREST / CIA阅览室记录镜像

运行规则

  • 无完整本地镜像:笔记本电脑仅存储脚本、小型清单和日志。
  • 批量爬取:在Hugging Face Jobs中运行,每个作业负责一个分页范围,上传自身分片后退出。
  • 可恢复性:批量保持有界且可恢复。
搜集汇总
数据集介绍
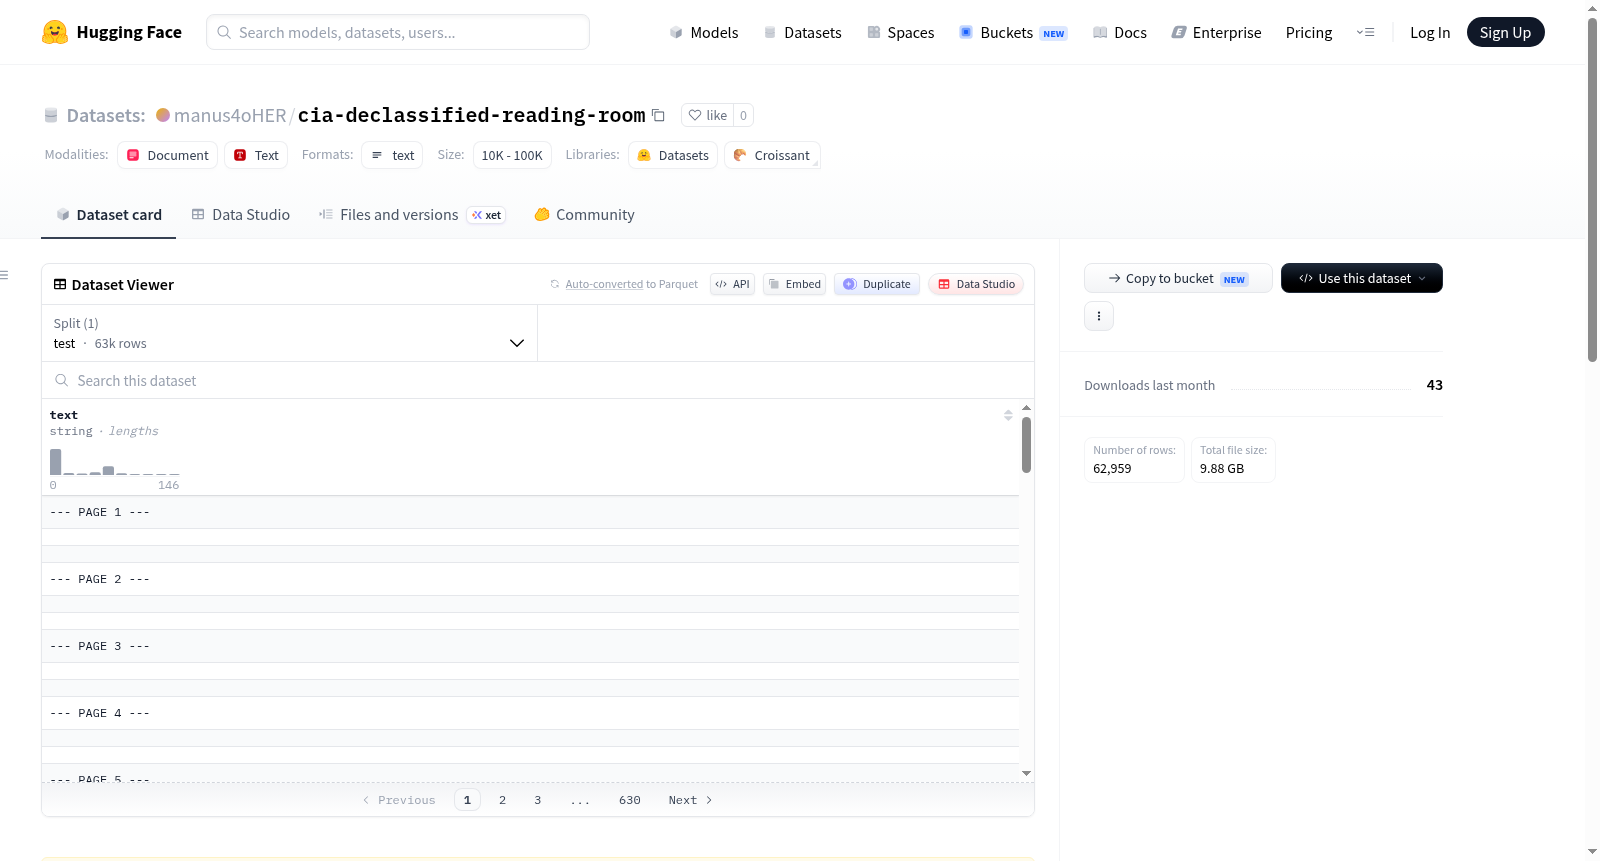
cia-declassified-reading-room 数据集图片
构建方式
该数据集基于流式处理管道构建,旨在镜像美国中央情报局(CIA)电子阅览室及CREST档案中的公开解密记录。为避免在本地存储完整语料库,管道采用分批次爬取与上传策略:每个有界页面范围由独立的Hugging Face任务处理,任务完成后将自身分片上传至数据集仓库,随后终止。管道支持从CIA官方端点或互联网档案馆(Internet Archive)镜像获取数据,以应对官方端点可能出现的重定向循环或程序访问限制,同时保留原始CIA文档标识符与来源溯源信息。
特点
数据集结构清晰,包含元数据(metadata)、文本内容(texts)、PDF分片(pdf_shards)、爬取报告(reports)及脚本(scripts)等多个子目录,便于分模块管理与复现。其核心特点在于无本地全量镜像的轻量化设计:仅保留脚本、小型清单与日志,而将批量爬取委托给云端任务执行,确保过程可中断、可恢复。数据来源优先采用CIA官方公开记录,在访问受阻时自动回退至互联网档案馆,增强了数据获取的鲁棒性与完整性。
使用方法
用户可通过Hugging Face数据集库直接加载该数据集,利用其分片结构进行增量式分析与处理。具体使用时,可依据元数据文件中的文档标识符与批次信息定位所需文档,从文本或PDF分片中提取内容。对于需要复现爬取流程的研究者,项目提供了可复现的脚本与配置清单,支持指定源配置与文档范围,从而在云端或本地环境中重新执行爬取任务,确保数据集的可验证性与可扩展性。
背景与挑战
背景概述
该数据集由Manus4oHER团队于近期创建,专注于将美国中央情报局(CIA)已解密的电子阅览室与CREST档案库中的公共记录进行系统化镜像与结构化存储。核心研究问题在于如何高效、可重复地爬取并整理这些分散于官方站点及互联网档案馆(Internet Archive)中的大规模政府解密文档,以构建一个可供机器学习与自然语言处理研究使用的高质量语料库。该数据集的推出为情报分析、历史研究及文档理解等领域提供了宝贵的原始数据资源,其采用的分片流式处理架构与元数据管理方式,对后续同类公共档案数字化工作具有重要的参考价值。
当前挑战
该数据集面临的核心领域挑战在于解决政府解密文档的非结构化与异构性难题,CIA档案库中包含了大量不同格式(PDF、文本、图片)且元数据不统一的文件,这为自动化解析与信息抽取带来了显著困难。此外,构建过程中的主要挑战源于CIA官方服务器对程序化访问的限制,包括HTTP重定向循环等反爬机制,迫使研究团队转向互联网档案馆作为替代数据源,同时需保证文档原始标识符与来源的可追溯性。如何在不进行完整本地镜像的前提下,通过分片与边界可控的批处理策略实现大规模爬取,并确保数据上传的完整性与可恢复性,亦是技术实现上的关键难点。
常用场景
经典使用场景
该数据集汇聚了美国中央情报局(CIA)已解密的阅读室与CREST档案系统的公开文献,涵盖冷战时期情报报告、政策备忘录、技术评估等珍贵历史资料。其最为经典的使用场景在于大规模情报文本的挖掘与分析——研究者可借助自然语言处理技术,从堆积如山的解密文档中提取关键事件脉络、人物关系网络和政策演变轨迹。例如,通过主题建模与命名实体识别,学者能够系统性地重构美国对外情报活动的决策逻辑,揭示隐蔽行动背后的战略考量。该数据集为情报学、国际关系史和冷战研究提供了前所未有的数字化语料库,使得过去依赖手工翻阅的浩繁卷帙得以被计算机高效解析,开启了情报史研究从定性分析向计算社会科学的范式跃迁。
解决学术问题
该数据集的核心学术价值在于突破了冷战史与情报研究中长期存在的史料可及性瓶颈。传统上,学者受限于CIA纸质档案的物理存放地点和查阅权限,难以获得系统性的原始决策记录。该语料库以数字镜像形式整合了跨度数十年的解密文件,使得研究者能够量化分析情报评估与政策产出之间的因果关系,例如检验‘情报失误’假说或追踪隐蔽行动中代理机构的演变模式。其流式处理的设计哲学确保了数据的新鲜度与可复制性,解决了同类语料库常见的版本混乱和更新滞后问题。在此基础上,学者得以开展跨语言的比较研究,从全球南方视角重新审视冷战情报博弈,推动了对传统‘美国中心’叙事框架的解构与修正。
衍生相关工作
该数据集衍生出一系列颇具影响力的经典工作。在计算语言学领域,基于该语料库训练的领域专用预训练语言模型(如CIA-BERT)显著提升了情报文本中模糊措辞与委婉表达的语义解析精度。在信息检索方面,研究者开发了面向解密文档的跨档案检索框架,实现了CREST记录与其它政府开放数据(如国务院外交关系文件)的联合查询。另有一脉工作聚焦于情报文本的可信度量化,构建自动化评分模型以标记矛盾陈述或乌托邦式推测。数字史学家则利用时间序列分析工具,从数据集中提取了冷战危机期间情报流量的周期律,重新评估了1962年古巴导弹危机中的信息延迟效应。这些衍生成果不仅反哺了情报学理论,更推动了档案数字化方法论的标准化,使该数据集成为政府开放数据运动中的一个标杆案例。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务