
遇见数据集

SINAI/ALIA-es-cultural-heritage

收藏
Hugging Face2026-06-15 更新2026-06-14 收录
官方服务:

资源简介:

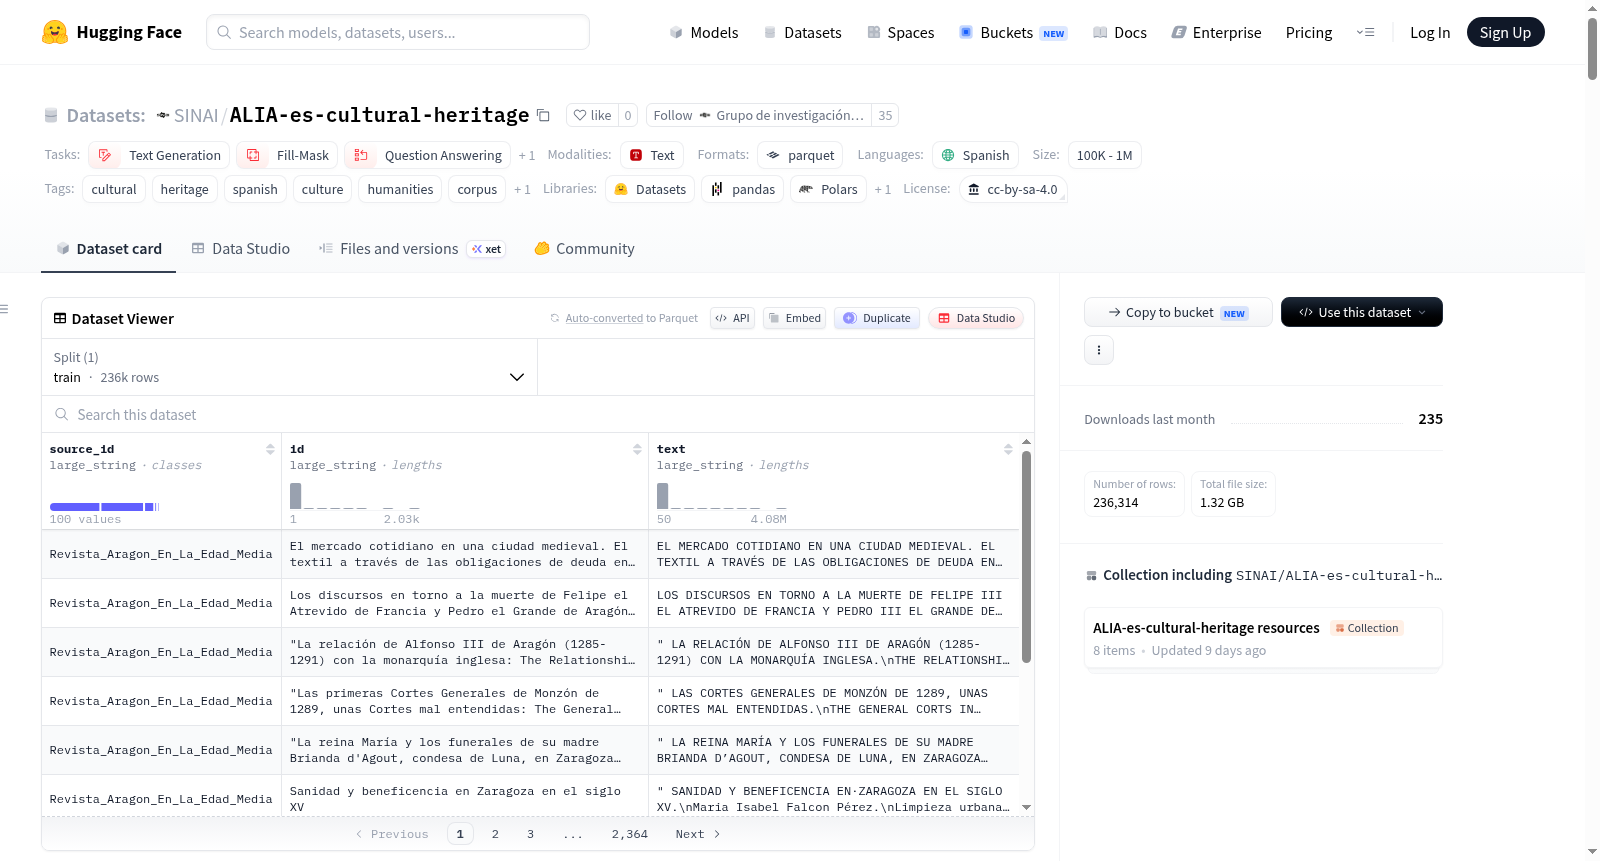
ALIA西班牙文化与遗产语料库是一个开放获取的数据资源,它汇编和组织了大规模的西班牙语文化遗产文档集合。该语料库整合了遗产清单、专业期刊、档案记录、机构出版物以及关于物质和非物质遗产的描述性资源。它旨在为数字人文、文化机构、档案管理员、历史学家、语言学家和人工智能从业者提供一个同质化且可重复使用的文本基础。其广度支持文档探索和计算工作流,如语义检索、主题发现、术语提取和语言模型适应。处理后的语料库目前包含236,314个实例和939,315,404个标记,分布在100个源数据集中。这种规模和异质性使其成为构建和评估专注于西班牙文化遗产叙事、历史论述和机构文档的NLP系统的重要资源。

The ALIA Spanish Cultural and Heritage Corpus is an open-access data resource that compiles and organizes a large-scale collection of cultural heritage documents in Spanish. It integrates heritage inventories, specialized journals, archival records, institutional publications, and descriptive resources about tangible and intangible heritage. The corpus was designed to provide a homogeneous and reusable textual base for researchers in digital humanities, cultural institutions, archivists, historians, linguists, and AI practitioners. Its breadth supports both documentary exploration and computational workflows such as semantic retrieval, topic discovery, terminology extraction, and language model adaptation. The processed version of the corpus currently includes 236,314 instances and 939,315,404 tokens, distributed across 100 source datasets. This scale and heterogeneity make it an important resource for building and evaluating NLP systems focused on cultural heritage narratives, historical discourse, and institutional documentation in Spanish.
提供机构:
SINAI
搜集汇总
数据集介绍
SINAI/ALIA-es-cultural-heritage 数据集图片
构建方式
ALIA-es-cultural-heritage语料库的构建遵循了一套系统化的数据整合与清洗流程。首先,从西班牙官方文化机构、学术期刊库及公开知识库等100个异构来源中,系统采集文化遗产领域的文档、档案与出版物。随后,借助MinerU等高级文档解析工具将原始数据转化为统一的结构化格式,并利用datatrove框架实施多阶段清洗:包括语言筛选以保留西班牙语文本、模糊去重以消除冗余、编码纠错以及敏感信息过滤。最终,通过tiktoken完成词元计数,形成了包含236,314个实例与约9.39亿词元的规整语料库。
特点
该语料库具有显著的规模性与领域专精性,涵盖遗产清单、学术期刊、档案记录及制度出版物等多模态文本,全面反映了西班牙物质与非物质文化遗产的多元面貌。其数据来源横跨国家与地区级遗产目录、数字人文指南、考古与历史学期刊,以及维基百科等开放知识资源,确保了内容的权威性与时效性。此外,每条数据均保留了来源标识与唯一ID,便于溯源与交叉验证,为数字人文与西班牙语自然语言处理研究提供了兼具广度和深度的基础资源。
使用方法
本数据集可通过HuggingFace的datasets库便捷加载,用户仅需执行`load_dataset("SINAI/ALIA-es-cultural-heritage", trust_remote_code=True)`即可获取完整数据,并支持流式加载以节省内存。每条样本以JSON格式存储,包含`id`、`text`与`source_id`三个字段。该语料库适用于领域语言模型的预训练与微调、文化遗产信息检索系统的构建、面向历史文档的问答任务,以及文本分类与术语提取等NLP研究。研究人员可直接基于其结构化格式开展下游实验,无需额外清洗。
背景与挑战
背景概述
ALIA-es-cultural-heritage数据集由西班牙多个研究机构联合创建,旨在为数字人文、文化分析与西班牙语自然语言处理提供战略性开放数据基础设施。该数据集整合了100个来源的236,314条实例与939,315,404个词元,涵盖遗产清单、学术期刊、档案记录及机构出版物等多元化文本,成为文化与自然遗产领域语言技术开发的基石。其创立时间可追溯至近期,核心研究问题聚焦于如何构建大规模、结构化且法律上可复用的西班牙语文化遗产语料库,以支撑大语言模型训练、语义检索及术语抽取等计算任务。该数据集因其规模与异质性,在推动文化遗产叙事、历史话语及机构文档的NLP应用方面具有重要影响力,为数字人文领域提供了统一且可复用的文本基础。
当前挑战
该数据集所解决的领域问题包括文化遗产文本的语义理解与信息检索,由于遗产文档术语专业、语言历史跨度大,通用NLP模型常难以精准处理。构建过程中面临多重挑战:首先,需要从100个异构来源(如政府门户、学术期刊、维基百科)中整合格式迥异的原始数据,完成模式归一化;其次,需通过语言过滤保留纯西班牙语内容,并处理编码错误与敏感信息;最后,必须对近10亿词元执行高质量去重与清洗,同时确保不丢失关键上下文,这对处理工具体系(如MinerU与datatrove)的鲁棒性提出了极高要求。
常用场景
经典使用场景
在数字人文与自然语言处理交叉领域,ALIA西班牙文化遗产语料库的经典使用场景集中于对文化遗产领域大语言模型的专项训练与评估。研究者利用该语料库中汇聚的23万余条涵盖遗产清单、学术期刊、档案记录及机构出版物等多源异构文本,构建领域专用语言模型,以捕捉西班牙文化遗产文本独特的叙事风格、术语体系与历史话语特征。此外,该语料库亦常被用于文化遗产导向的信息检索系统的开发与评测,以及面向历史文化文献的问答系统构建,支撑对文化遗产知识的语义理解与自动应答。
实际应用
在实际应用中,ALIA西班牙文化遗产语料库有效赋能了文化遗产机构的数字化转型与智能服务升级。博物馆、档案馆与图书馆可依托该语料库训练专用于遗产描述文本的命名实体识别模型,自动提取文物名称、地理位置、历史时期等关键信息,提升藏品编目效率。文化旅游部门借助基于该语料库构建的问答系统,能够为公众提供关于西班牙物质与非物质文化遗产的精准知识服务。同时,历史研究者利用语料库支撑下的主题建模与文本聚类分析,得以高效梳理学术文献中的研究脉络与概念演变。
衍生相关工作
该数据集的发布催生了一系列在文化遗产自然语言处理方向上的衍生工作。研究者基于ALIA语料库开展了面向西班牙文化遗产领域的大语言模型持续预训练与指令微调实验,探索领域自适应策略对生成文本质量与文化术语准确性的提升效果。此外,涌现出以该语料库为评测基准的文化遗产文本分类、蕴含关系识别与语义相似度计算等下游任务基准体系。在资源建设层面,相关工作进一步将语料库的构建方法论迁移至其他罗曼语族语言的文化遗产语料汇聚中,推动了多语言文化遗产语言资源的标准化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

