
遇见数据集

Makamaka77/structured-wikipedia

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

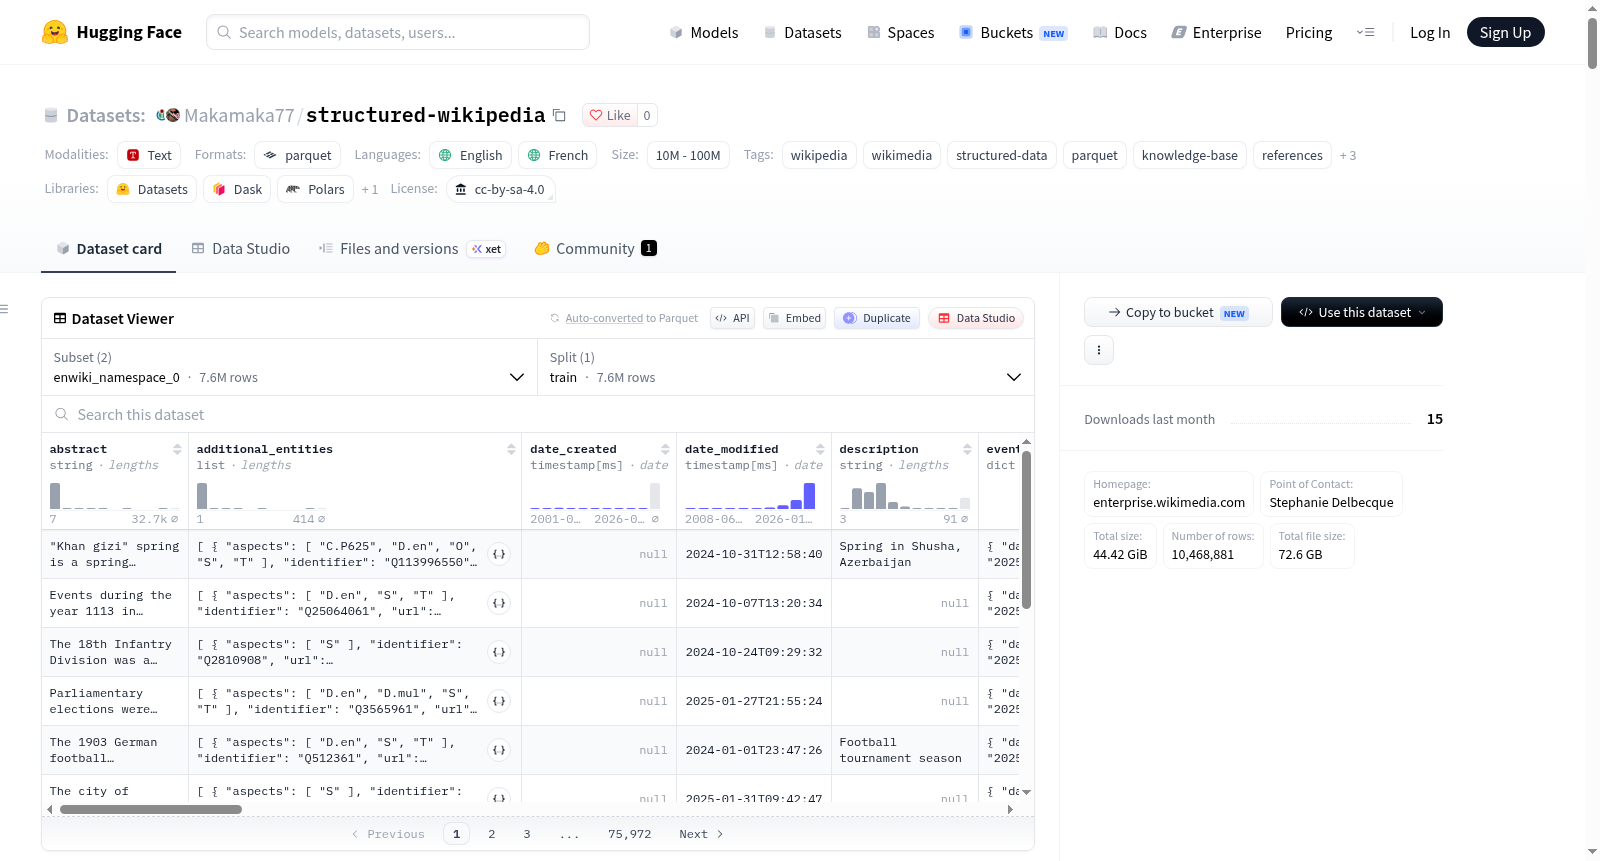
Wikimedia结构化维基百科数据集是一个包含预解析英文和法文维基百科文章的结构化数据集,通过Wikimedia Enterprise快照API提取。该数据集涵盖了英文和法文维基百科的所有文章,以一致的架构预解析并输出为结构化数据。数据以Parquet格式提供,优化了高性能分析查询和高效存储。此版本使用统一的固定架构,兼容DuckDB、pandas、Polars和Apache Spark。数据集新增了以下特性:解析的参考文献和引用,连接维基百科知识与其来源;解析的表格,这是维基百科页面信息最密集的部分之一;可信度信号(如referenceneed和referenceryisk),指示信息可能未得到充分来源支持;列表解析改进,包括嵌套列表、有序列表和定义列表;以及文章正文图像的解析。数据集总行数为10,468,881,总大小为44.42 GiB,包含英文(7,597,149行,34.61 GiB)和法文(2,871,732行,9.81 GiB)两个语言版本。每行代表一个维基百科文章快照,包含名称、标识符、URL、版本、摘要、描述、图像、信息框、章节、表格、参考文献等字段。

The Wikimedia Structured Wikipedia dataset is a structured dataset containing pre-parsed English and French Wikipedia articles, extracted using the Wikimedia Enterprise Snapshot API. It includes all articles from the English and French language editions of Wikipedia, pre-parsed and output as structured data with a consistent schema. The dataset is provided in Parquet format, optimized for high-performance analytical queries and efficient storage. This version uses a unified, pinned schema across all files, making it compatible with DuckDB, pandas, Polars, and Apache Spark out of the box. New features in this dataset include: parsed references and citations, connecting Wikipedias knowledge with its sources of truth; parsed tables, one of the most information-heavy sections of Wikipedia pages; credibility signals (e.g., referenceneed and referenceryisk), signaling where information may not be sufficiently backed by sources; improvements to list parsing, including nested lists, ordered lists, and definition lists; and parsed article-body images. The dataset has a total of 10,468,881 rows and a size of 44.42 GiB, with English (7,597,149 rows, 34.61 GiB) and French (2,871,732 rows, 9.81 GiB) language editions. Each row represents one Wikipedia article snapshot, containing fields such as name, identifier, url, version, abstract, description, image, infoboxes, sections, tables, and references.
提供机构:
Makamaka77
搜集汇总
数据集介绍
Makamaka77/structured-wikipedia 数据集图片
构建方式
该数据集依托Wikimedia Enterprise Snapshot API,以英文与法文维基百科的条目命名空间(namespace 0)为对象,将2026年5月13日抓取的完整快照经流式归一化处理。原始ndjson分片被逐条解析,其中递归嵌套或键结构不稳定的字段(如sections、infoboxes、tables及references中的metadata)以JSON字符串形式编码存储,以规避Arrow C数据接口的嵌套深度限制;随后对结构字段按字母序递归规范化,确保各分片模式逐字节一致,最终以zstd压缩写入Parquet文件,并通过pa.unify_schemas统一并钉扎为单一schema。
使用方法
使用者可借助Hugging Face datasets库以流式方式加载enwiki_namespace_0或frwiki_namespace_0配置,或通过Polars、DuckDB、PyArrow直接扫描Parquet文件路径进行高性能分析查询。读取时需注意,sections、infoboxes、tables及references中的metadata字段为JSON编码字符串,应使用json.loads解码后访问其内部结构;若需精确匹配模式,可读取仓库中钉扎的schema.json并借助PyArrow的IPC接口还原Arrow模式。该数据集适用于模型预训练、对齐微调、检索增强生成以及更新与基准测试等任务。
背景与挑战
背景概述
维基百科作为全球规模最大的协作式知识工程,自2001年以来累积了逾六千万条目,其内容虽经社区精心维护而具备面向人类的半结构化特征,但对机器而言,高保真抽取其中蕴含的知识仍属非平凡任务。为此,维基媒体基金会旗下的Wikimedia Enterprise于2024年前后启动Structured Contents计划,并由Stephanie Delbecque等人主导发布structured-wikipedia数据集,旨在以统一模式将英文与法文维基百科全部条目预解析为结构化数据。该数据集聚焦于将参考文献、引用、表格与信息框等厚重信息区块转化为可查询的Parquet格式,为预训练、检索增强生成与模型评测提供高质量语料,对开放知识抽取与可信AI研究具有显著推动作用。
当前挑战
该数据集所直面的领域问题在于,如何在不依赖定制化解析系统的前提下,规模化地将维基百科异构的模板化内容转化为稳定、跨语言一致的结构化表征,从而服务于模型开发与知识检索。构建过程中的挑战尤为突出:其一,条目内嵌的章节、信息框、表格与参考文献具有递归嵌套或开放字典结构,其键值随条目变化,超出Apache Arrow数据接口的表达极限,故不得不以JSON编码字符串暂存;其二,为兼顾DuckDB、Polars与Spark等工具的开箱即用,需对全部数据分片执行模式统一与逐字节对齐的规范化处理;其三,快照中仍可能掺杂重复、已删除或遗漏的条目,且长条目存在版本差异,需借助最高版本标识加以甄别,这些限制共同构成了该测试版数据集在完整性与一致性上的现实挑战。
常用场景
经典使用场景
在知识驱动的自然语言处理研究领域,结构化维基百科数据集最经典的使用场景在于为大规模预训练语言模型提供高质量、多语言且富含引用与表格的语料支撑。研究者可直接借助Parquet格式所优化的高性能分析能力,对七百余万篇英文与近三百万篇法文条目进行检索增强生成、事实核查以及模型微调等任务,从而在统一的模式之下高效获取摘要、信息框、章节正文、参考文献与可信度信号等多元信息。
解决学术问题
该数据集有效缓解了维基百科知识在机器可读化过程中的若干学术瓶颈,包括非结构化文本难以直接用于关系抽取、引用溯源困难以及跨语言知识对齐不足等问题。通过预先解析参考文献、引文、表格与嵌套列表,并引入referenceneed与referencerisk等可信度指标,它为知识图谱构建、事实验证与低资源语言迁移研究提供了可复现的标准化基准,推动了开放知识库在学术界的深入应用。
实际应用
在实际应用层面,结构化维基百科数据集可广泛服务于智能问答系统、语义搜索引擎、企业知识管理与自动化事实核查平台。开发者能够利用DuckDB、Polars或Apache Spark直接查询远程Parquet文件,快速构建检索增强生成流水线,将维基百科中的实体、摘要、信息框与引用来源整合进下游应用,从而提升回答的准确性与可追溯性,并支持多语言内容的分发与再利用。
数据集最近研究
最新研究方向
随着大语言模型对高质量结构化知识的需求激增,基于该数据集的检索增强生成与事实验证研究成为前沿热点。最新方向聚焦于利用其解析后的参考文献、引文及可信度信号(如referenceneed、referencerisk)构建溯源感知的生成系统,以缓解模型幻觉并提升输出可验证性。同时,表格与信息框的结构化解析推动了多语言知识图谱补全和跨语言迁移学习,为低资源语言维基百科的自动化扩展提供支撑。该数据集亦被用于预训练语料去偏与对齐研究,通过识别引文缺失或风险信号,探索模型对知识可信度的动态评估能力,对开放域问答和学术文献挖掘具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

