
mgarbowski/zzsn-style-prompts
收藏官方服务:
资源简介:
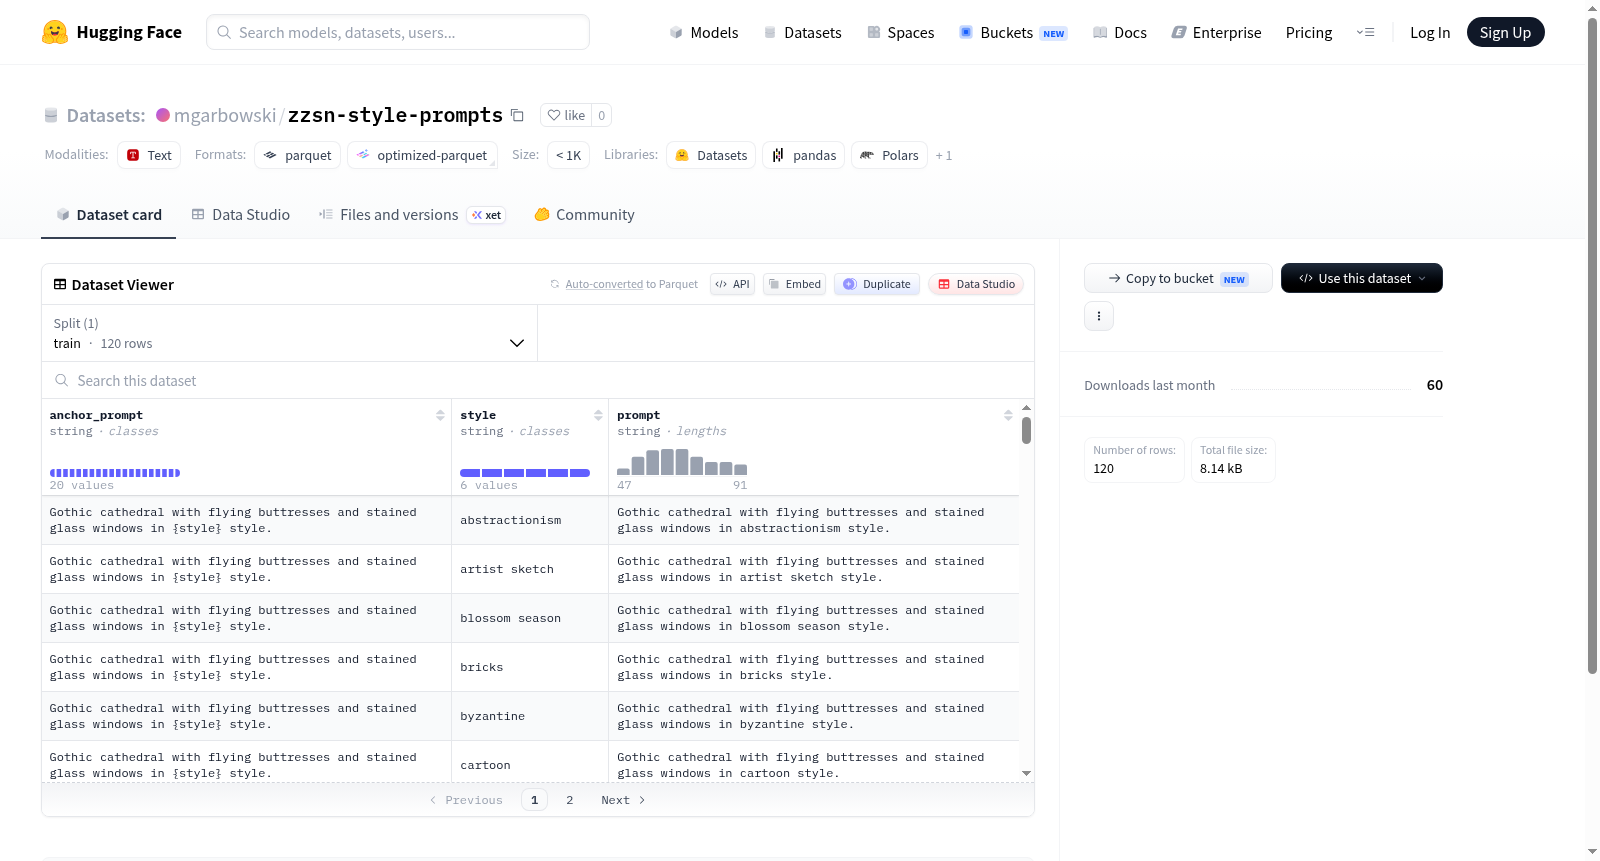
一个包含anchor_prompt(锚定提示)、style(风格)和prompt(提示)字段的数据集,共有120个训练样本,可能用于风格迁移或提示改写任务。
A dataset with anchor_prompt, style, and prompt fields, consisting of 120 training examples, likely used for style transfer or prompt rewriting tasks.
提供机构:
mgarbowski搜集汇总
数据集介绍
构建方式
zzsn-style-prompts数据集聚焦于文本风格迁移任务,通过人工标注与模板化生成相结合的方式构建。每条数据包含三个字段:锚定提示(anchor_prompt)、目标风格标签(style)以及风格化后的提示(prompt)。其中,anchor_prompt提供原始文本内容,style定义期望转换的风格类别(如正式、幽默等),prompt则为经过风格适配后的输出。数据集共含120条训练样本,以JSON格式存储,便于加载与处理。
使用方法
用户可通过HuggingFace Datasets库直接加载数据集,调用load_dataset('zzsn-style-prompts')即可获取训练数据。使用时可遍历每条样本的anchor_prompt、style与prompt字段,用于风格迁移模型的输入输出对构建,或结合风格标签进行条件生成训练。建议将数据集拆分为训练与验证子集,以适配模型调优需求,同时可用于测试模型在有限数据下的风格泛化能力。
背景与挑战
背景概述
在生成式人工智能领域,尤其是文本到图像生成模型中,风格迁移是一项富有挑战性的任务,其核心在于如何将特定视觉风格精确地融入用户提供的提示词(prompt)中。zzsn-style-prompts数据集于近年由相关研究团队构建,旨在为模型训练提供结构化的风格化提示对,以解决现有数据集中风格表达模糊、多样性不足的难题。该数据集包含120条样本,每条样本由原始锚定提示(anchor_prompt)、目标风格标签(style)以及风格化后的完整提示(prompt)三部分组成,为细粒度的风格条件控制提供了标准化基准。尽管规模较小,但其简洁的格式和明确的目标对提升扩散模型的风格可控性具有重要的启发意义,为后续大规模风格数据集的设计与评估铺设了基础。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,如何让模型在生成过程中精准剥离并重组风格与内容语义,避免风格泄漏或内容失真,是风格迁移研究的核心瓶颈。当前数据集仅120条样本的规模,难以覆盖丰富多样的艺术风格与复杂场景,可能导致模型过拟合或泛化能力不足。其次,在构建过程中,风格化提示对的标注存在主观性差异,不同标注者对同一风格的表述可能不一致,引入噪声;此外,从锚定提示到风格化提示的改写需要平衡艺术表达与语义保真度,人工构建的高成本与低效率限制了数据集的扩展性,亟需自动化标注与质量校验机制来克服这些局限。
常用场景
经典使用场景
在文本生成与风格迁移的研究领域中,zzsn-style-prompts数据集以其精巧的配对结构脱颖而出。该数据集包含锚定提示(anchor_prompt)、目标风格(style)以及对应的风格化提示(prompt)三类文本,为探索大语言模型在可控文本风格生成中的表现提供了理想的基础资源。经典使用场景聚焦于风格引导下的文本重写任务,研究者借助这一数据集训练模型学习如何将中性或通用表达转化为特定风格(如幽默、正式、诗意等)的文本,从而验证模型对风格维度的理解与泛化能力。
解决学术问题
该数据集直接回应了自然语言处理领域中一个长期存在的核心挑战:如何在保持语义内容不变的前提下,实现文本风格的精确调控。此前,风格迁移任务常受限于缺乏高质量、多风格的成对语料,导致模型难以捕捉风格与内容的解耦表征。zzsn-style-prompts通过提供120条精心设计的三元组样本,为少样本学习与提示调优等前沿方法提供了可复用的基准,推动了关于风格嵌入空间、对比学习在风格控制中作用的学术讨论,其影响力体现在对文本风格可控性问题的系统性研究促进上。
实际应用
在实际应用中,zzsn-style-prompts数据集为内容创作、广告文案生成以及个性化人机交互等场景注入了新的活力。例如,智能写作助手可以利用该数据集训练的模型,根据用户指令将一段中性的产品描述自动转换成充满感染力的营销语言,或为社交媒体生成特定氛围的帖子。在对话系统中,风格控制能力使得虚拟助手能够适配不同用户群体的沟通偏好,从而提升交互的自然度与用户黏性。这些应用不仅展示了数据集在工业界落地的巨大潜力,也为精细化文本生成技术的普及奠定了基础。
数据集最近研究
最新研究方向
该数据集聚焦于风格化提示词(style prompts)的构建与迁移学习,为文本到图像生成模型(如Stable Diffusion)提供精细化的风格调控能力。尽管样本规模仅120条,但其双提示结构(anchor_prompt与prompt)的设计,有望推动少样本风格适配与提示词解耦研究的前沿突破。在AIGC内容安全与个性化创作热潮中,此类数据集可助力生成模型实现更可控的视觉风格表达,降低风格模仿的门槛,并可能影响版权保护与多模态生成的可解释性评估。
以上内容由遇见数据集搜集并总结生成


