JingweiNi/ocr2_hardest10k_k2_lowmed_gpt55pos_qwen35neg_seed20260529
收藏资源简介:
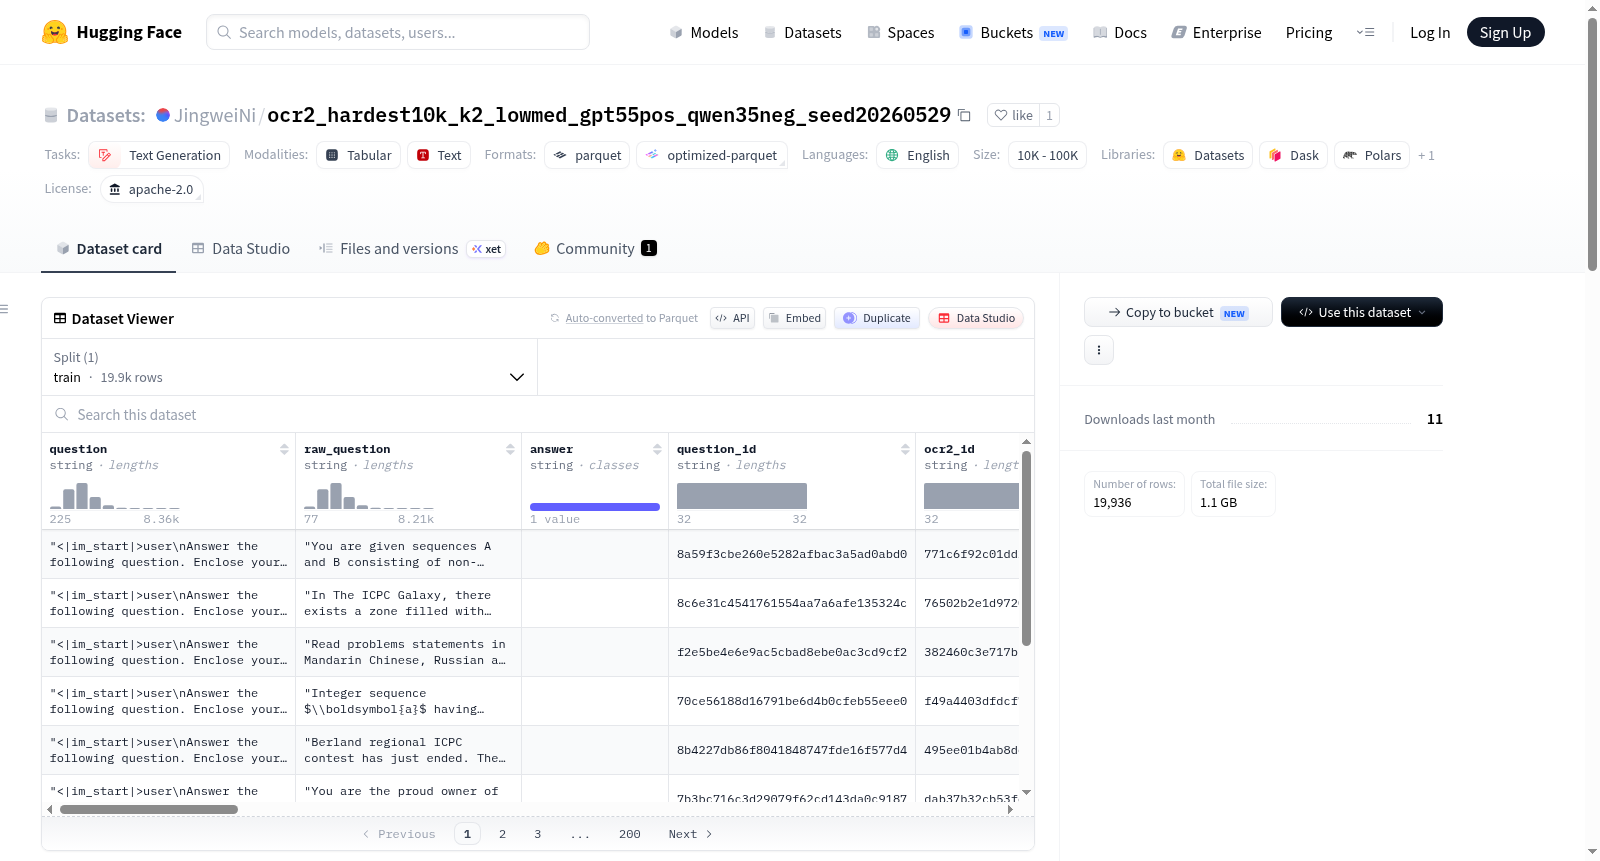
该数据集名为OCR2 hardest10k K2 low/medium aggregated labels,是一个文本生成任务数据集,基于OCR2最难问题的10k个样本,采用K2低/中等推理努力混合生成。数据遵循行级聚合格式,每行代表一个生成的K2-Think轨迹,包含对齐的步骤标签数组:qwen35_verified(原始Qwen3.5-122B-A10B-FP8模型标注的步骤标签)、gpt55_verified(GPT-5.5模型对Qwen3.5正例步骤的重新注释,其他位置为NaN)、verified(最终聚合标签,其中Qwen3.5负例标记为0,GPT-5.5确认的正例标记为1,GPT-5.5过滤的Qwen正例标记为0,未重新注释的Qwen正例保持NaN)以及新增的k2_reasoning_effort列(指示每行的K2生成推理模式,值为low或medium)。聚合规则是:GPT-5.5确认的错误视为错误,所有Qwen3.5负例和GPT-5.5拒绝的Qwen正例视为正确。数据集包含19936行,其中低推理努力9968行,中等推理努力9968行;Qwen3.5正例步骤5110个,负例步骤14867个;有效GPT-5.5重新注释1191个,GPT-5.5确认正例步骤763个;最终验证负例步骤15295个,NaN步骤4349885个。数据已验证与源混合数据集和GPT-5.5注释记录一致,确保列对齐和完整性。
This dataset, named OCR2 hardest10k K2 low/medium aggregated labels, is a text-generation task dataset based on 10k hardest OCR2 questions, using a mix of low and medium K2 reasoning efforts. It follows a row-level aggregated format, where each row represents one generated K2-Think trace, with aligned step label arrays: qwen35_verified (original step labels from Qwen3.5-122B-A10B-FP8), gpt55_verified (GPT-5.5 medium re-annotations for completed Qwen3.5-positive steps, with NaN elsewhere), verified (final aggregated labels, where Qwen3.5 negatives are 0, GPT-5.5-confirmed positives are 1, GPT-5.5-filtered Qwen positives are 0, and unreannotated Qwen positives remain NaN), and an additional k2_reasoning_effort column (indicating the K2 generation reasoning mode per row, either low or medium). The aggregation rule is: GPT-5.5 confirmed errors are errors; all Qwen3.5 negatives and GPT-5.5 rejected Qwen positives are correct. The dataset contains 19,936 rows, with low reasoning effort rows = 9,968 and medium = 9,968; Qwen3.5 positive steps = 5,110, negative steps = 14,867; valid GPT-5.5 reannotations = 1,191; GPT-5.5 confirmed positive steps = 763; final verified negative steps = 15,295; and NaN steps = 4,349,885. It has been validated against the source mixed dataset and GPT-5.5 annotation records to ensure column alignment and integrity.
- 数据集名称:
ocr2_hardest10k_k2_lowmed_gpt55pos_qwen35neg_seed20260529 - 发布者: JingweiNi
- 任务: 文本生成(Text Generation)
- 模态: 表格数据(Tabular)、文本(Text)
- 格式: parquet、optimized-parquet
- 语言: 英语(English)
- 规模: 10K - 100K 行
- 许可证: Apache-2.0
- 数据集大小: 总文件大小 1.1 GB,共 19,936 行
- 数据集描述: 该数据集遵循
JingweiNi/ocr2_cf1900_k2_qwen35_gpt55_aggregated_10k_seed20260513的行级聚合标签格式,并包含了额外的 K2 生成元数据。每一行对应从最难的 OCR2 问题中,以 50% low + 50% medium 混合模式生成的一个 K2-Think 轨迹。 - 提示列 (Prompt Columns):
question: 用于生成的精确 K2 补全前缀,根据k2_reasoning_effort从raw_question渲染而来。raw_question: 原始的未格式化 OCR2 问题陈述。k2_reasoning_effort: K2 生成推理模式,值为low或medium。
- 标签列 (Label Columns): 步骤标签以对齐数组形式存储。
qwen35_verified: 原始的 Qwen3.5-122B-A10B-FP8 步骤标签。gpt55_verified: 对已完成的 Qwen3.5 阳性步骤进行的 GPT-5.5 medium 重新标注,其余位置为NaN。verified: 最终聚合标签。Qwen3.5 阴性为0;GPT-5.5 确认的阳性为1;GPT-5.5 过滤后的 Qwen 阳性为0;未重新标注的 Qwen 阳性保持NaN。
- 聚合规则: GPT-5.5 确认的错误即为错误;所有 Qwen3.5 阴性以及 GPT-5.5 拒绝的 Qwen 阳性均为正确。
- 数据摘要:
- 行数:19,936
- K2 推理模式计数:
low模式 9,968 行,medium模式 9,968 行 - Qwen3.5 阳性步骤数:5,110
- Qwen3.5 阴性步骤数:14,867
- 此混合数据集中有效的 GPT-5.5 重新标注数:1,191
- GPT-5.5 确认的阳性步骤数:763
- 最终确认的阴性步骤数:15,295
- 最终的
NaN步骤数:4,349,885
- 验证信息: 数据集已与源混合数据集、K2 分词器和 GPT-5.5 标注记录进行校验。
solution和qwq_critique列为空字符串,因其是参考模式所需但源数据集缺失的字段。