legal-practice-library
收藏资源简介:
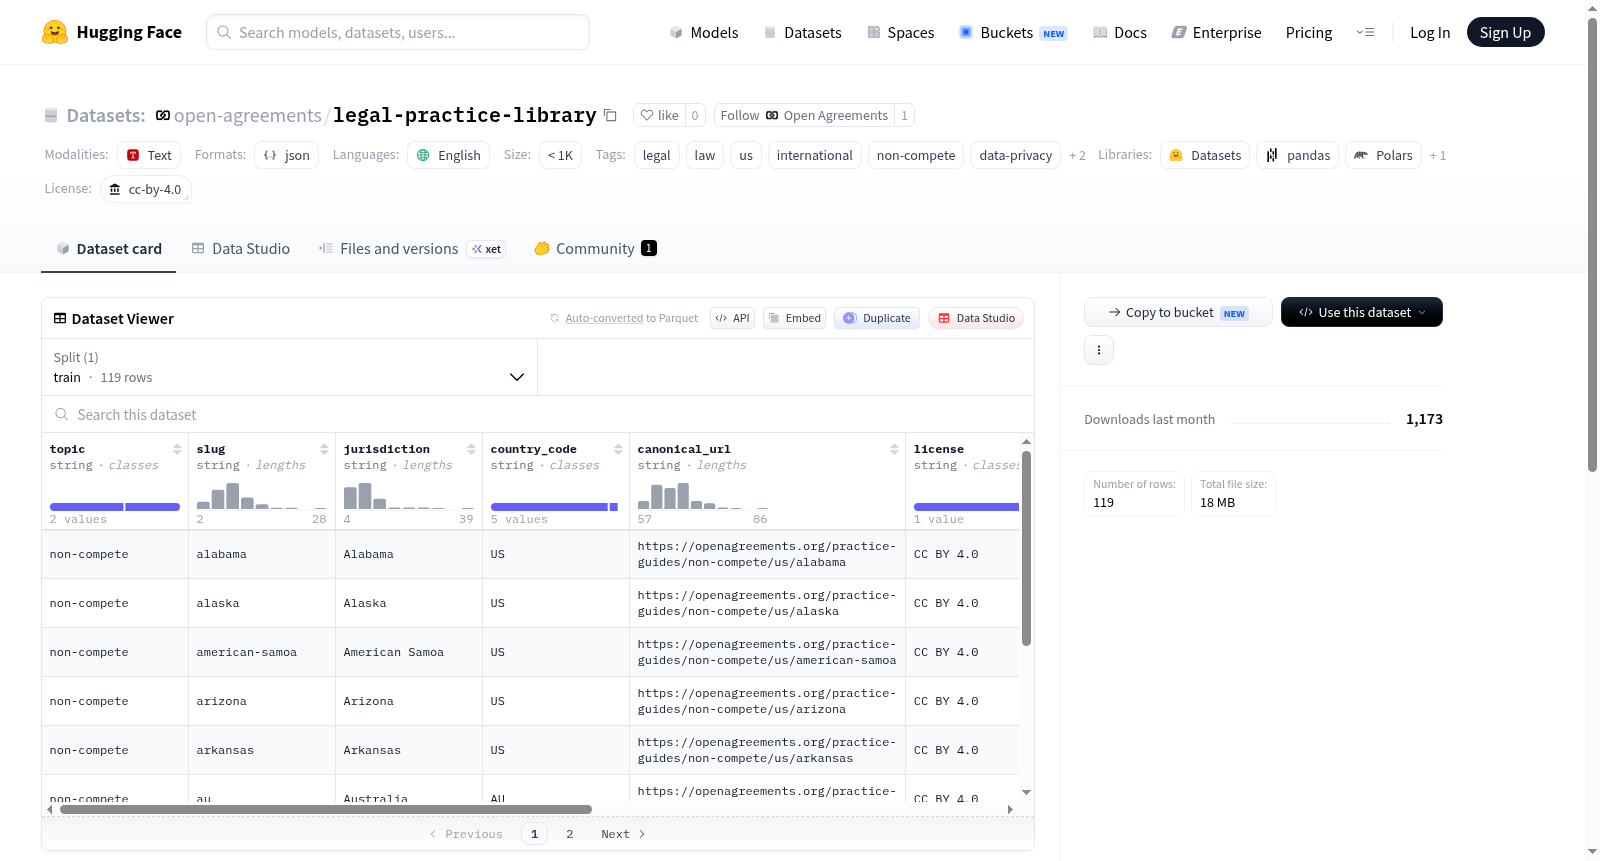
Legal Practice Library数据集是OpenAgreements实践笔记语料库的一个经过清理、包含来源引用的快照。该数据集提供了关于美国各州(以及部分国际地区)法律的简明英语解释,目前主要涵盖竞业禁止/限制性契约法以及消费者数据隐私法两个主题。每个实践笔记均基于主要的法律渊源(如成文法和案例)编写,并附有机器可验证的引用来源,同时记录了笔记的最后审阅日期。该语料库会在上游内容发生变更时自动重新同步,确保其快照反映的是现行法律,而非一次性的静态抓取数据,因此非常适合用作最新、可溯源的参考材料或训练数据。数据集包含119条记录,每条记录对应一个特定司法管辖区的法律实践笔记。结构化数据以JSONL格式存储,包含主题、唯一标识符、司法管辖区、国家代码、规范URL、许可证、最后审阅日期、快照时间、内容陈旧标志以及Markdown格式的笔记内容等字段。该数据集适用于法律研究、法律信息提取、法律问答系统构建、法律知识库开发以及法律专业人员的参考辅助等任务。数据集采用CC BY 4.0许可证发布,需注明来源为openagreements.org。请注意,该数据集内容不构成法律建议。
The Legal Practice Library dataset is a cleaned, source-cited snapshot of the OpenAgreements practice notes corpus. It provides plain English explanations of laws across U.S. states and some international jurisdictions, currently focusing on non-compete/restrictive covenant law and consumer data privacy law. Each practice note is based on primary legal sources such as statutes and cases, includes machine-verifiable citations, and records the last review date. The corpus automatically resynchronizes when upstream content changes, ensuring the snapshot reflects current law rather than a one-time static scrape, making it suitable as up-to-date, traceable reference material or training data. The dataset contains 119 records, each corresponding to a legal practice note for a specific jurisdiction. Structured data is stored in JSONL format, with fields including topic, unique identifier, jurisdiction, country code, canonical URL, license, last review date, snapshot time, stale content flag, and note content in Markdown. It is applicable for legal research, legal information extraction, building legal question-answering systems, developing legal knowledge bases, and assisting legal professionals. The dataset is released under the CC BY 4.0 license and requires attribution to openagreements.org. Note that the dataset content does not constitute legal advice.
数据集概述
- 名称: Legal Practice Library — US & International Practice Notes
- 来源: OpenAgreements(openagreements.org)
- 许可协议: CC BY 4.0
- 语言: 英语
- 标签: legal, law, us, international, non-compete, data-privacy, practice-notes, legal-reference
内容说明
该数据集包含美国州法及部分国际法的通俗语言解释,目前涵盖以下两个法律领域:
- 非竞争/限制性契约法(non-compete / restrictive-covenant law)
- 消费者数据隐私法(consumer data-privacy law)
每条笔记均依据成文法与案例法撰写,附带可机器验证的来源引用,并记录最后审阅日期。数据集每当上游源内容发生变更时会重新同步,确保反映最新法律状态,而非一次性抓取快照。
数据格式与结构
- 数据文件:
data.jsonl,共 119 行,每行对应一条司法管辖笔记。 - 每行包含字段: topic, slug, jurisdiction, country_code, canonical_url, license, last_reviewed, snapshot_as_of, stale, - 附加文件: 原始 Markdown 镜像存放于
content/<topic>/<slug>.md
使用说明
- 每条记录包含规范性 URL:
https://openagreements.org/practice-guides/<topic>/<slug>,在依赖笔记内容前应优先参考该实时页面作为权威来源。 - 快照日期:2026-06-25
- 可通过
last_reviewed和stale字段过滤笔记的时效性。 - 数据集的源代码提交哈希:
6da2a05c855a6e997f4c4de12d2e3473f8cb04cc - 法律免责声明: 该数据集不构成法律建议,使用时需注明出处为 openagreements.org。
配置信息
- 配置名称:
default - 分割:
train - 数据文件路径:
data.jsonl