
Kudod/HP-books_9
收藏官方服务:
资源简介:
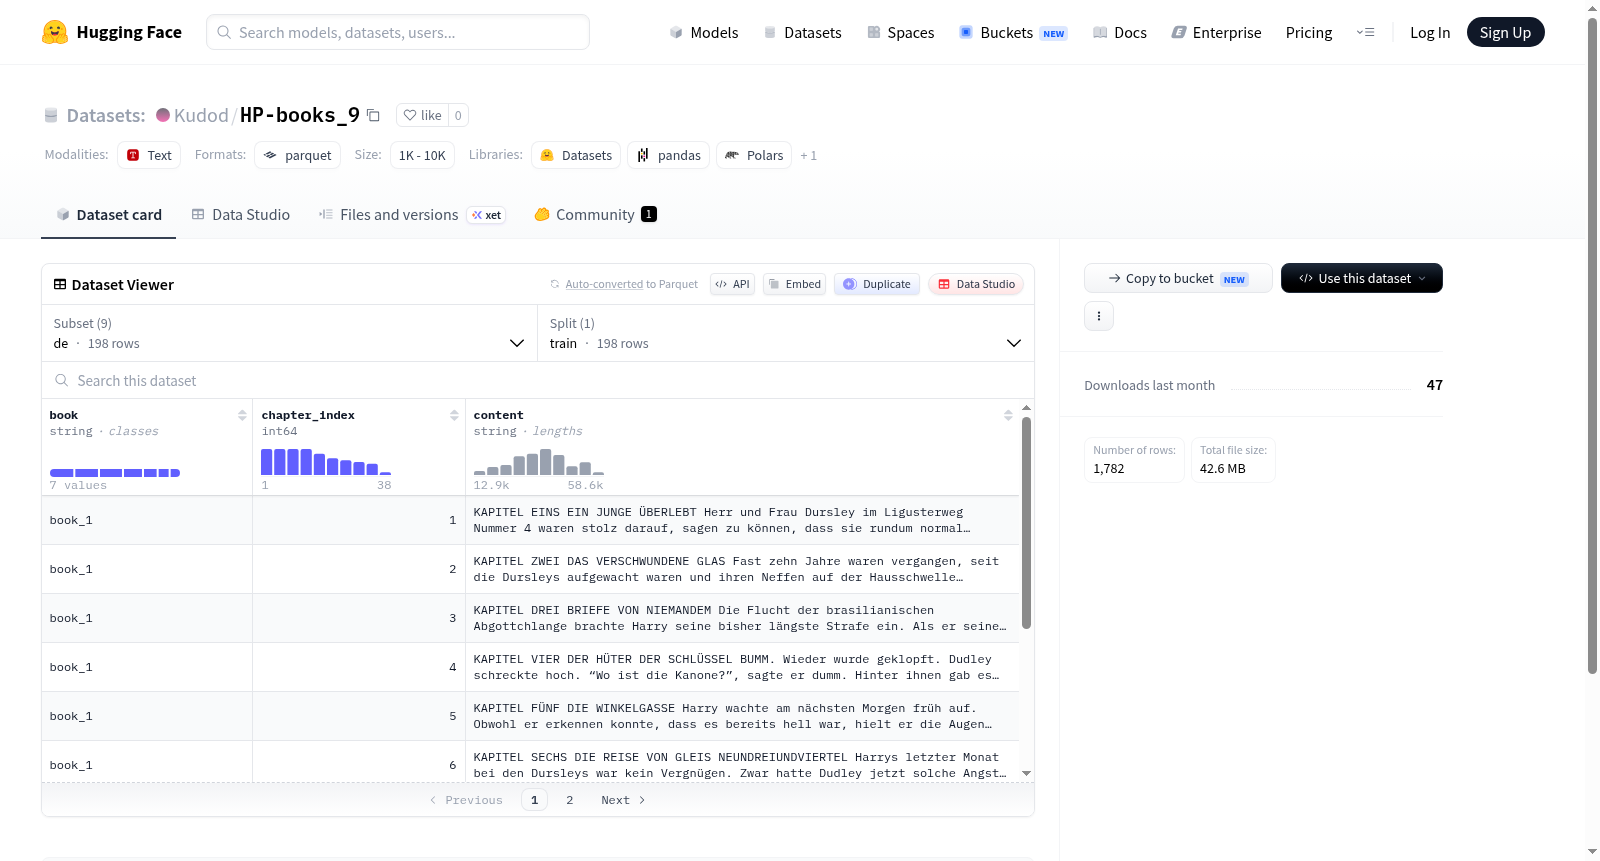
该数据集是一个多语言文本集合,包含德语(de)、英语(en)、西班牙语(es)、法语(fr)、日语(jp)、韩语(kr)、泰语(th)、越南语(vi)和中文(zh)版本。每个语言配置都有198个训练样本,特征包括书籍名称(book)、章节索引(chapter_index)和内容(content),适用于文本分析、机器翻译或多语言NLP任务。数据以训练分割形式提供,文件大小从约3.8MB到18.6MB不等。
This dataset is a multilingual text collection including German (de), English (en), Spanish (es), French (fr), Japanese (jp), Korean (kr), Thai (th), Vietnamese (vi), and Chinese (zh) versions. Each language configuration contains 198 training examples with features such as book name, chapter index, and content, suitable for text analysis, machine translation, or multilingual NLP tasks. The data is provided in a train split format, with file sizes ranging from approximately 3.8MB to 18.6MB.
提供机构:
Kudod搜集汇总
数据集介绍
构建方式
HP-books_9数据集专为多语言文本理解任务而设计,其构建过程基于《哈利·波特》系列书籍的九个语种版本,包括德语、英语、西班牙语、法语、日语、韩语、泰语、越南语和中文。每个语种分别形成独立的配置子集(config),各包含198个样本,对应书籍的章节划分。数据集中每条记录由三个字段组成:`book`记录书籍名称,`chapter_index`标注章节序号,`content`提供对应章节的原始文本内容。所有语种的数据统一采用训练集(train)拆分,通过预划分的文件路径(如de/train-*)组织存储,确保跨语言数据结构的对称性与可比性。
使用方法
使用本数据集时,研究者可通过Hugging Face的`datasets`库按语言配置加载对应子集,例如指定`config_name='zh'`加载中文版数据。每条样本可直接通过字典索引访问`book`、`chapter_index`与`content`三个字段。由于数据已按章节切分且结构统一,用户可便捷地构建章节级文本序列,用于语言模型的因果语言建模任务或序列到序列的跨语言翻译训练。建议将各语言配置结合使用,以构建多语言对比实验或联合训练框架,充分发挥其跨语言平行对齐的优势。
背景与挑战
背景概述
在自然语言处理与多语言文本分析领域,跨语言语料库的构建对于推动机器翻译、跨语言信息检索以及多语言预训练模型的发展至关重要。HP-books_9数据集应运而生,其创建时间虽未明确标注,但从其结构严谨、覆盖语种广泛的特点来看,很可能由致力于多语言NLP研究的机构或团队开发,旨在解决多语言文本对齐与篇章理解这一核心研究问题。该数据集以哈利·波特系列书籍为蓝本,提供了德语、英语、西班牙语、法语、日语、韩语、泰语、越南语和中文共九种语言版本的章节级文本,每种语言包含198个训练样本,数据规模虽不大但质量精细。通过引入这一多语平行语料,HP-books_9为跨语言篇章级研究提供了基准,推动了低资源语言处理、跨语言语义对齐以及对比学习等方向的发展,在学术界和工业界均具有潜在影响力。
当前挑战
HP-books_9数据集虽设计精巧,但所面临的挑战不容小觑。首先,在领域问题层面,该数据集旨在解决多语言篇章级语义对齐与跨语言迁移学习这一核心难点,然而不同语言之间在语法结构、词汇表达与文化背景上的巨大差异,使得模型难以充分捕捉篇章层面的深层语义一致性,尤其在泰语、越南语等低资源语言上表现尤为明显。其次,在构建过程中,数据采集与标注面临诸多障碍,例如需确保九种语言版本的章节内容精确对齐,任何细微的翻译偏差或章节切分错误都可能引入噪声;此外,数据集仅包含198个样本,规模偏小,容易导致模型过拟合或泛化能力不足,数据量的限制也使得基于深度学习的模型难以充分发挥其潜力,亟需探索数据增强或迁移学习策略以缓解这一瓶颈。
常用场景
经典使用场景
在跨语言自然语言处理研究领域,HP-books_9数据集以其丰富多语言章节对齐文本的独特优势,成为训练和评估多语言文本理解模型的重要基石。该数据集收录了九种语言的书籍章节内容,每种语言包含198个训练样本,覆盖德、英、西、法、日、韩、泰、越、中九大语系。研究者常利用其篇章级别的对齐特性,开展跨语言信息检索、多语言摘要生成以及语言间知识迁移等经典任务,尤其适合探索低资源语言在高资源语言辅助下的语义理解能力提升。
解决学术问题
HP-books_9数据集有效解决了多语言自然语言处理中平行语料匮乏这一长期困扰学术界的难题。传统篇章级对齐语料多集中于英语等高资源语言,而该数据集通过系统化收集九种语言的整书章节内容,为研究多语言篇章结构一致性、跨语言语义对齐精度以及语言间文化差异的文本表征提供了可靠基准。其意义在于推动了多语言预训练模型在非对称语言对上的泛化能力研究,尤其为胶着语与孤立语之间的跨语言学习机制探索奠定了数据基础。
实际应用
在实际产业应用中,HP-books_9数据集助力构建了面向多语言环境的智能阅读辅助系统。基于其章节对齐特性,开发者能够训练出高精度的跨语言图书检索工具,使用户可以书名检索时获取不同语言版本的对应章节内容。此外,该数据集还被用于优化多语言电子书平台的自动翻译质量评估模块,通过比较原文与译本的章节结构完整性,提升机器翻译在长篇文本中的连贯性。在数字人文领域,研究者借助该数据集分析不同语言版本间的叙事差异,推动跨文化文本比较研究。
数据集最近研究
最新研究方向
在跨语言自然语言处理与多语种语料对齐研究领域,HP-books_9数据集凭借其涵盖德、英、西、法、日、韩、泰、越、中九种语言的书籍章节级语料结构,为多语言篇章理解与低资源语言模型预训练提供了高价值基准。当前前沿方向聚焦于利用该数据集探索语言间的语义对齐与迁移学习策略,尤其是针对泰语、越南语等形态丰富型语言的篇章级表示学习。伴随大语言模型对多语言泛化能力的迫切需求,HP-books_9的章节索引与内容设计使得研究者能够深入剖析跨语种上下文连贯性、叙事结构差异及文化特异性表达,推动了多语言机器翻译从句子级向篇章级的范式跃迁,对构建更公平、包容的通用人工智能系统具有里程碑意义。
以上内容由遇见数据集搜集并总结生成


