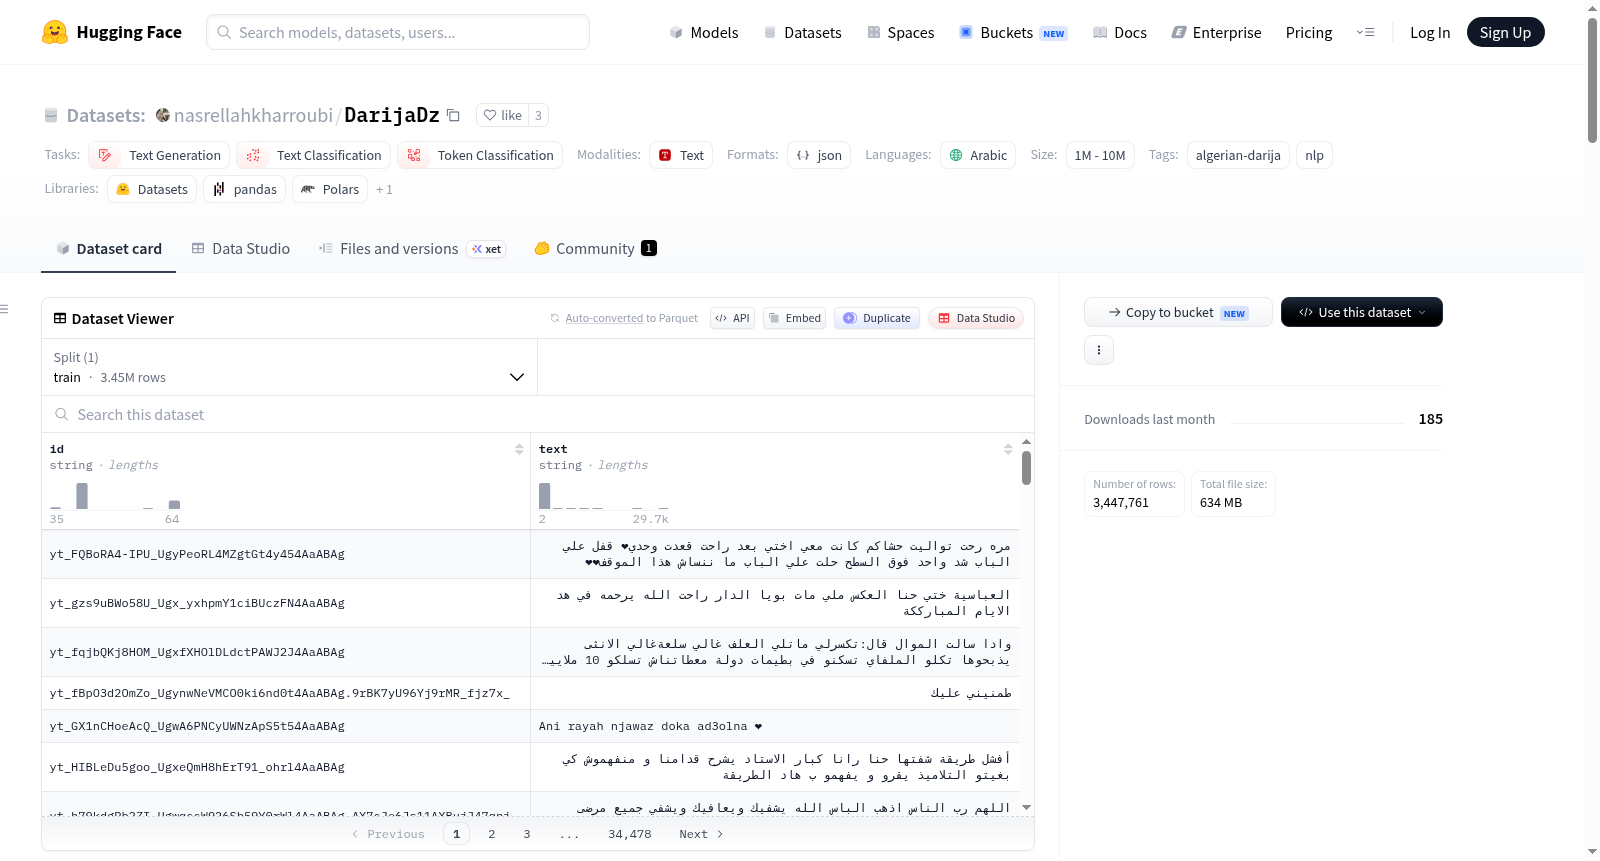
DarijaDz
收藏资源简介:
DarijaDZ 是一个大规模用户生成文本语料库,从阿尔及利亚 YouTube 频道收集而来,包含约 340 万条评论和 4225 万个词级别 token。文本内容主要使用阿尔及利亚 Darija 文字书写,同时包含拉丁 / Arabizi 书写和混合文字内容。该数据集旨在为低资源语言变体——阿尔及利亚 Darija 提供大规模公开文本资源,支持语言模型预训练、继续预训练、阿拉伯语 / Darija 自然语言处理研究、方言识别、情感分析、命名实体识别、机器翻译、分词器研究、阿拉伯文字与 Arabizi 书写研究、代码切换和非正式在线语言研究等任务。数据通过 YouTube Data API v3 从 43 个频道收集,涵盖新闻、教育、烹饪、娱乐、评论等多种内容类别。经过包括 URL 替换、@提及替换、零宽字符移除、方向控制字符移除、视频时间戳移除、连续表情符号折叠、字符延长折叠、过度标点折叠、近空文档移除、阿拉伯语变音符号移除、Unicode NFKC 标准化以及基于 MinHash/LSH 的近重复文档去重等预处理步骤。数据集以 Hugging Face 兼容格式发布,可直接使用 load_dataset 加载。
DarijaDZ is a large-scale user-generated text corpus collected from Algerian YouTube channels, containing approximately 3.4 million comments and 42.25 million word-level tokens. The text is primarily written in Algerian Darija, with Latin/Arabizi script and mixed script content. The dataset aims to provide a large-scale public text resource for the low-resource language variant Algerian Darija, supporting tasks such as language model pretraining, continued pretraining, Arabic/Darija NLP research, dialect identification, sentiment analysis, named entity recognition, machine translation, tokenizer research, Arabic script and Arabizi writing research, code-switching, and informal online language research. Data was collected from 43 channels via YouTube Data API v3, covering categories including news, education, cooking, entertainment, and commentary. Preprocessing steps include URL replacement, @mention replacement, zero-width character removal, direction control character removal, video timestamp removal, consecutive emoji folding, character elongation folding, excessive punctuation folding, near-empty document removal, Arabic diacritics removal, Unicode NFKC normalization, and MinHash/LSH-based near-duplicate document deduplication. The dataset is released in a Hugging Face-compatible format and can be loaded directly using load_dataset.
DarijaDZ 数据集概述
基本信息
- 数据集名称:DarijaDZ
- 语言:阿拉伯语(阿尔及利亚方言)
- 类型:大规模用户生成文本语料库
- 来源:阿尔及利亚 YouTube 频道
- 规模:超过100万条样本(1M < n < 10M)
- 任务类别:文本生成、文本分类、词元分类
- 创建者:Kharroubi Nasrellah(ENSIA 四年级学生)
语料库规模
| 指标 | 数值 |
|---|---|
| 文档数量 | 3,447,761 |
| 词级词元 | 42,250,028 |
| 平均词元/文档 | 12.25 |
文字使用分布(词元级别)
| 文字类别 | 词元数 | 占比 |
|---|---|---|
| 阿拉伯文字 | 36,173,217 | 85.62% |
| 拉丁/阿拉伯语化拼写 | 4,526,255 | 10.71% |
| 数字、标点与符号 | 1,506,822 | 3.57% |
| 阿拉伯语+拉丁语混合 | 43,734 | 0.10% |
注:数据中阿拉伯文字与Arabizi(阿拉伯语拉丁拼写)之间的不均衡,促使开发了阿拉伯文字→Arabizi转写工具以平衡数据。
数据来源与采集
- API:YouTube Data API v3
- 采集内容:顶级评论及回复
- 爬虫:可恢复的采集管道
- 频道数量:43个
- 处理的原始视频文件数:25,640个
- 覆盖内容类别:新闻与时事、教育/高考备考、烹饪与生活方式、娱乐与故事、评论与博客
清洗与预处理
清洗管道基于1,000个文档的蓄水池样本经验开发,并应用于整个语料库,具体规则包括:
- URL → 替换为[URL]
- @提及 → 替换为[MENTION]
- 移除零宽度及不可见字符
- 移除方向隔离控制字符
- 移除视频时间戳
- 连续emoji运行折叠
- 字符拉长折叠(保留表达性变异)
- 过多标点运行折叠
- 移除接近空文档
- 移除阿拉伯语变音符号(Tashkeel)
- 应用Unicode NFKC规范化
- 使用MinHash/LSH移除近似重复文档
预期用途
当前版本数据集最适合:
- 无监督语言建模
- 语言模型预训练
- 继续预训练
- 分词器开发
- 语料库分析
- 阿拉伯语/达里亚语语言学研究
- 非正式在线语言研究
- 阿拉伯/拉丁文字变体研究
- 代码切换研究
此外,该数据集还可用于:方言识别、情感分析、命名实体识别、机器翻译及分词器研究。
数据格式
数据以Hugging Face兼容格式分发,加载方式:
python from datasets import load_dataset
dataset = load_dataset("nasrellahkharroubi/DarijaDz")
引用信息
引用格式:
Kharroubi Nasrellah. DarijaDZ: Algerian Darija YouTube Corpus. 2026.