
遇见数据集

ProxyScrape Free Proxy List

收藏
github2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

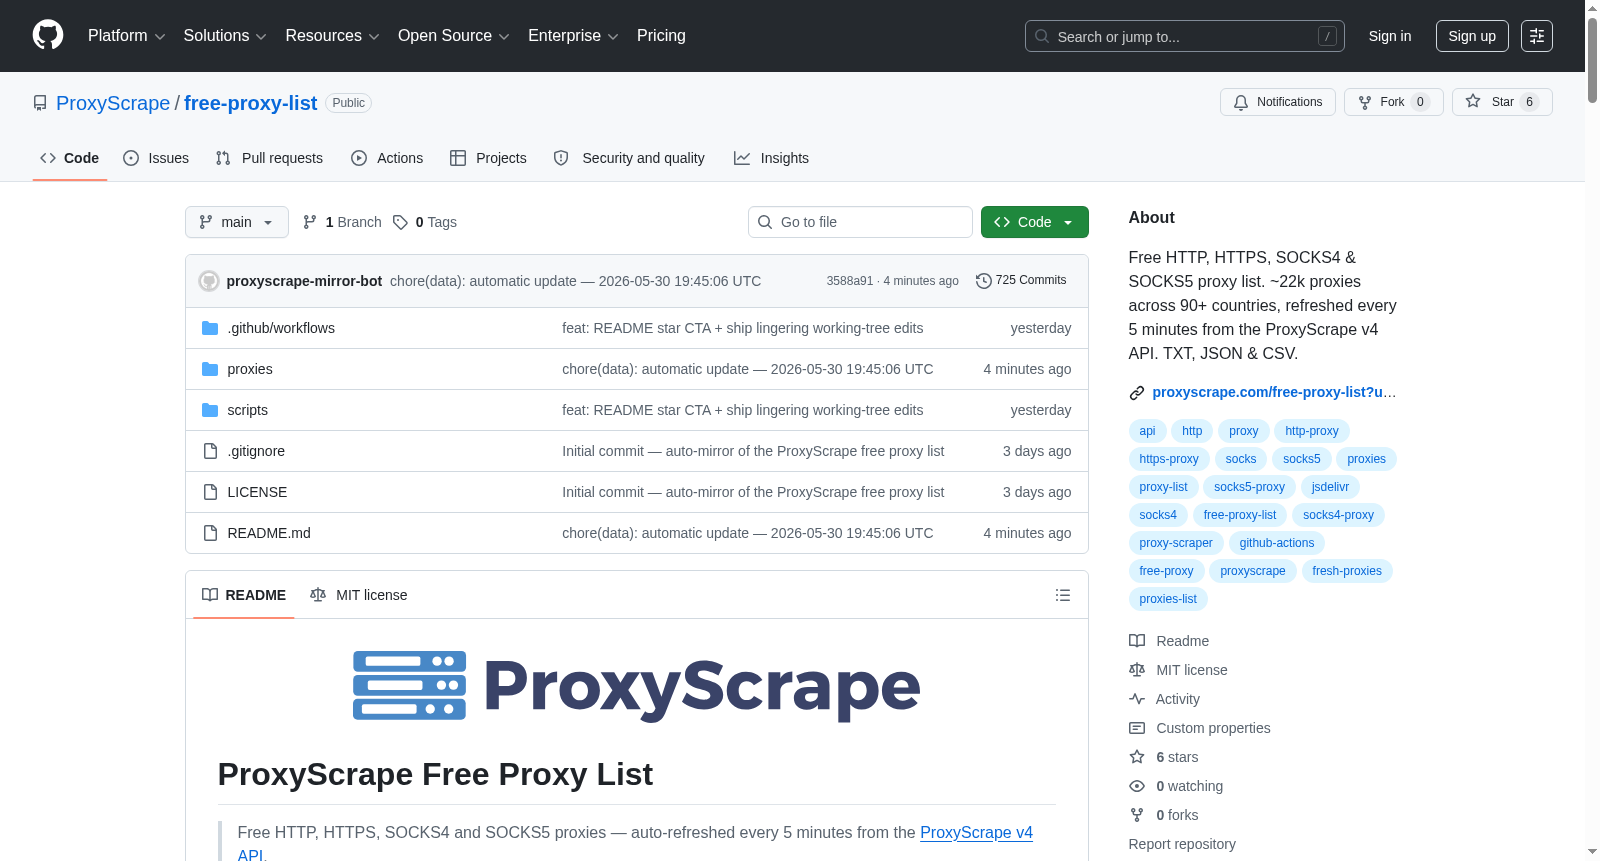
这是一个免费的HTTP、HTTPS、SOCKS4和SOCKS5代理列表,包含来自90多个国家的约22,000个代理,每5分钟从ProxyScrape v4 API自动刷新,提供TXT、JSON和CSV格式。

This is a free list of HTTP, HTTPS, SOCKS4 and SOCKS5 proxies, comprising approximately 22,000 entries from over 90 countries. The dataset is automatically refreshed every 5 minutes via the ProxyScrape v4 API, and is available in TXT, JSON and CSV formats.

创建时间:
2026-05-28
原始信息汇总

数据集概述:ProxyScrape Free Proxy List

ProxyScrape Free Proxy List 是一个公开的免费代理列表镜像仓库,由 ProxyScrape 维护。数据集自动从 ProxyScrape v4 API 获取,每 5 分钟刷新一次,旨在为开发者提供免费代理的自动更新集合。

核心特性

  • 数据来源:ProxyScrape 免费代理列表,同时提供实时 API 接口。
  • 更新频率:本仓库每 5 分钟更新一次,底层 API 每分钟更新。
  • 代理类型:支持 HTTP、HTTPS(CONNECT 能力)、SOCKS4、SOCKS5。
  • 数据统计(示例):总计 3,217 个代理,覆盖 97 个国家,分属 239 个协议与国家组合。

仓库目录结构

代理数据按多种维度进行分片存储,每个分片都包含 data.txtdata.jsondata.csv 三种格式:

  • proxies/all/:所有代理的汇总数据。
  • proxies/protocols/:按协议(http, https, socks4, socks5)分类。
  • proxies/countries/:按国家(ISO-3166 alpha-2 小写代码,如 us, de)分类。国家目录下还可再按协议细分,协议子分片仅在有对应代理时存在。
  • proxies/stats.json:统计数据汇总,包含总数、按协议划分的数量及国家列表。

数据文件格式

  • data.txt:每行一个代理,格式为 protocol://ip:port
  • data.json:包含元数据的代理对象数组。元数据字段包括:protocol, ip, port, country, country_code, city, anonymity, ssl, uptime_percent, asn, isp, latency_ms, last_checked
  • data.csv:CSV 格式,列顺序与 JSON 中的字段头一致。
  • stats.json:包含总数、按协议统计数和国家数量的 JSON 对象。

数据获取方式

所有数据文件通过 jsDelivr CDN 提供快速、全局的缓存访问。URL 模式如下:

  • 所有代理 TXT:https://cdn.jsdelivr.net/gh/proxyscrape/free-proxy-list@main/proxies/all/data.txt
  • 所有代理 JSON:https://cdn.jsdelivr.net/gh/proxyscrape/free-proxy-list@main/proxies/all/data.json
  • 所有代理 CSV:https://cdn.jsdelivr.net/gh/proxyscrape/free-proxy-list@main/proxies/all/data.csv
  • 按协议:.../proxies/protocols/<协议>/data.txt(如 http, https, socks4, socks5
  • 按国家:.../proxies/countries/<国家代码>/data.txt
  • 按国家和协议:.../proxies/countries/<国家代码>/<协议>/data.txt
  • 数据状态:.../proxies/stats.json

如果需要可重复性,可以固定到特定 commit 的 SHA。

使用说明

支持通过 curl、Python、Node.js 等方式获取数据。可结合 jq 进行过滤(如选择延迟小于 500ms 的代理)。对于需要实时代理和查询时过滤(协议、国家、匿名度、超时等)的用户,推荐使用 ProxyScrape 的公共 API。

已知局限

  • 安全性:免费公共代理不安全,可能存在流量记录、内容注入等问题,不应传输敏感信息。
  • 稳定性:代理可能随时失效,客户端需要实现重试和健康检查。
  • 速度:延迟波动大,吞吐量不稳定,不应期待服务等级协议(SLA)。
  • 黑名单风险:许多 IP 可能已被反爬系统或信誉服务识别。

许可信息

仓库中的代码(如 scripts/update.py)采用 MIT 许可。代理数据本身来源于公开渠道,按“现状”提供,不提供任何适用性保证。

相关链接

  • 数据集详情页面:https://github.com/ProxyScrape/free-proxy-list
  • 官方网站:https://proxyscrape.com/free-proxy-list
  • 公共 API 文档:https://docs.proxyscrape.com/api-reference/public-api/get-proxy-list
  • 其他免费工具:在线代理检查器、桌面端代理检查器(MIT 开源)、浏览器扩展。
搜集汇总
数据集介绍
ProxyScrape Free Proxy List 数据集图片
构建方式
在数字化浪潮席卷全球的当下,网络代理服务已成为数据采集、隐私保护与网络访问的重要基石。ProxyScrape Free Proxy List数据集正是基于这一需求而生,它通过ProxyScrape v4 API作为数据源,利用Python 3脚本以每五分钟为周期自动抓取并更新数据。该脚本以2000个代理为批次进行分页请求,内置重试与退避机制,对代理记录以协议、IP地址和端口号为键进行去重,随后为每条数据补充国家、ASN、在线率、延迟及SSL标志等元信息,最终按协议类型与国家代码进行分片存储。更新流程依托服务器端的cron定时任务驱动,通过flock机制防止任务重叠,仅在数据发生变化时才触发Git提交与推送,确保镜像仓库始终维持最新状态。
使用方法
使用该数据集的方式灵活多样,开发者可根据技术栈自由选择。最快捷的方式是通过curl命令直接拉取jsDelivr CDN上的纯文本列表,例如使用'curl https://cdn.jsdelivr.net/gh/proxyscrape/free-proxy-list@main/proxies/all/data.txt'即可获取全部代理。若需操控特定协议或国家,只需在URL路径中替换protocols或countries下的对应目录。对于偏好编程语言调用的场景,Python可结合urllib与json模块加载JSON数据并利用列表推导式筛选高在线率或低延迟的精英代理;Node.js环境则可借助fetch API与数组过滤方法实现类似功能。所有分片文件均支持TXT、JSON与CSV三种格式,配合jq、pandas等数据处理工具,能够轻松集成到自动化工作流或规模化数据采集管道之中。
背景与挑战
背景概述
代理服务器在网络爬虫、数据采集与隐私保护领域扮演着不可或缺的角色,它们能够有效隐藏用户真实IP、规避地理限制与反爬机制。ProxyScrape Free Proxy List数据集由ProxyScrape团队创建并维护,依托其v4公共API,自推出以来持续为开发者提供免费、实时更新的HTTP、HTTPS、SOCKS4与SOCKS5代理列表。该数据集的核心研究问题在于构建一个高度自动化、低延迟的代理资源汇聚与分发系统,以解决网络数据抓取过程中代理资源获取零散、时效性差的痛点。凭借每五分钟自动刷新的机制与丰富的国家及协议分片组织方式,该数据集已成为众多爬虫工程师与安全研究者的重要基础工具,对推动Web数据获取领域的效率提升具有显著影响力。
当前挑战
当前数据集面临的核心挑战首先源自代理本身的不可靠性:公共代理具有高度的动态性与不稳定性,存活周期短且延迟波动显著,用户需在客户端构建重试与健康检测机制以应对频繁失效。其次,构建过程中面临代理数据质量把控与规模扩大的矛盾——从全球众多异构来源采集代理需处理大量重复、失效条目,同时依据协议、国别与匿名度等多维属性进行高效分片与元数据扩充,对实时清洗算法的精度与吞吐量提出了严苛要求。此外,代理的潜在风险不可忽视,由于来源公开,恶意节点可能窃取流量或注入内容,安全性与可信度成为制约其实用深度的关键瓶颈。
常用场景
经典使用场景
在网络爬虫与数据采集领域,代理资源是突破目标站点反爬机制、实现大规模分布式抓取的核心要素。ProxyScrape Free Proxy List 数据集收录了来自全球近百个国家的数千个活跃代理节点,涵盖 HTTP、HTTPS、SOCKS4 与 SOCKS5 四种协议,并每五分钟自动刷新。研究者与工程师可依据协议类型、国家代码、匿名等级及延迟等元数据精准筛选所需代理,将其无缝集成至 Scrapy、Selenium 或 Requests 等爬虫框架中,从而规避 IP 封锁、降低请求被标记的风险,确保数据采集任务的高效与稳定。
解决学术问题
该数据集着力消解网络信息检索与大规模数据采集研究中长期存在的代理资源匮乏、时效性差与地域覆盖不均等痛点。传统研究往往受限于静态代理列表的更新滞后与协议支持不完整,难以在动态变化的网络环境中复现实验或验证算法普适性。ProxyScrape Free Proxy List 以其高频更新机制(五分钟周期)与结构化元数据(含国家代码、匿名等级、延迟及 ASN 信息),为代理调度优化、匿名性评估、地理分布式爬取策略等研究方向提供了可靠且可复用的实验数据基础,推动了网络测量与反反爬技术领域的方法论进步。
实际应用
在工业级网络应用中,该数据集的实用价值尤为显著。企业级数据服务商利用其代理资源池实现多地域电商价格监控、社交媒体舆情分析及搜索引擎结果聚合,通过动态轮换代理策略有效规避目标平台的反爬识别。安全研究团队则借助其匿名代理节点开展渗透测试与威胁情报收集,在不暴露真实 IP 的情况下评估网络防御体系。此外,跨境网络加速与内容分发系统亦可从该数据集中筛选低延迟节点,优化用户访问体验。其支持多种输出格式(TXT、JSON、CSV)的特性,使其能够轻松适配各类自动化运维脚本与企业级数据管道。
数据集最近研究
最新研究方向
在当前全球网络安全态势日益严峻、数据采集与隐私保护需求并存的背景下,该ProxyScrape免费代理列表数据集正成为网络爬虫、分布式系统匿名通信及地理位置模拟研究中的核心基础设施。其前沿研究方向聚焦于利用自动刷新、多协议(HTTP/HTTPS/SOCKS4/SOCKS5)及高粒度元数据(延迟、匿名等级、ASN归属等)构建动态代理池,服务于反封锁策略优化、大规模网页抓取中的IP轮换算法以及代理健康度预测建模。尤其是在LLM训练数据获取、跨境电商舆情监控等热点事件中,该数据集提供的实时、结构化代理源显著提升了数据采集的鲁棒性与合规性,同时推动了关于免费代理安全风险与可靠性评估的实证研究,为学术与工业界平衡效率与安全提供了关键支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


